

Pydantic V1迁移到V2:Python数据校验代码适配指南
针对Python工程的Pydantic V1到V2平滑迁移实用指南,详细剖析底层Rust架构变革、自动化迁移工具运用、废弃API替换以及自定义校验器重构全流程。
Pydantic 从 V1 演进到 V2 是 Python 数据建模与校验生态中一次具有决定性的重构。V2 通过底层重写为基于 Rust 的核心引擎 pydantic-core,将校验与序列化性能提升了 5 到 50 倍,但同时也带来了大量非向下兼容的破坏性变更(Breaking Changes)。本文梳理从 Pydantic V1 迁移到 V2 的工程实施路径,覆盖核心架构变化、自动化转换工具的运用、关键语法的手动改写以及行为差异排查,帮助工程团队在保障服务平稳的前提下完成适配。
一、理解底层架构变革:V1 与 V2 的本质区别
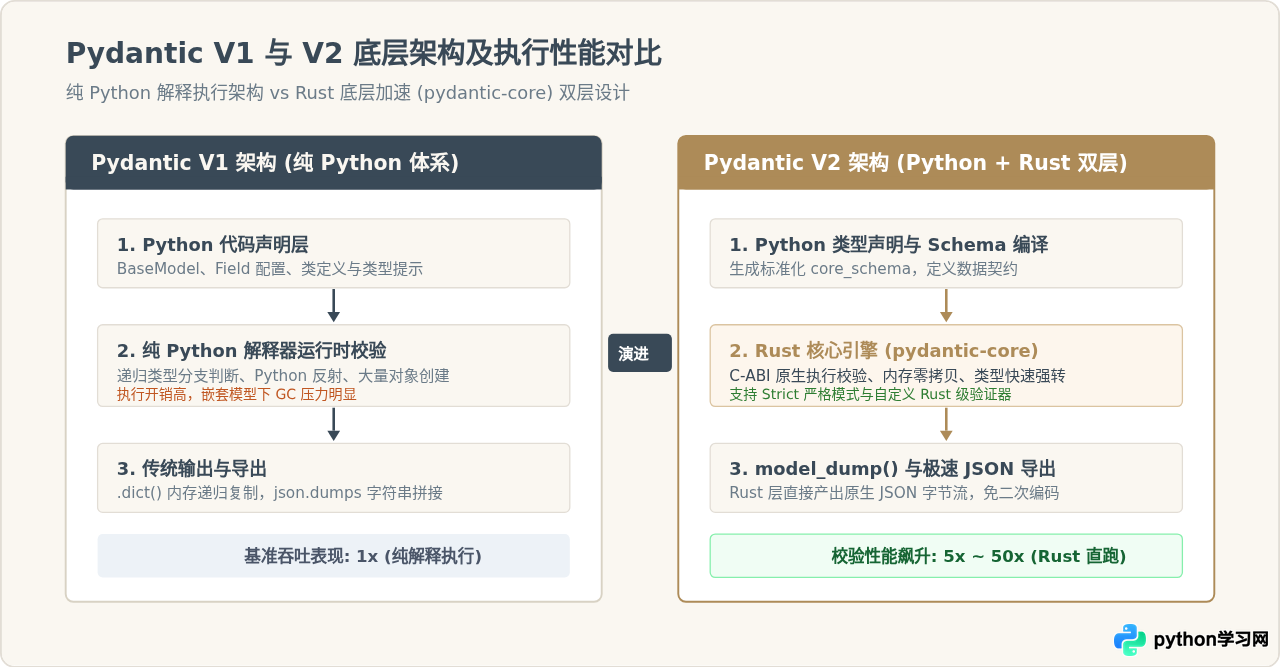
在 V1 时代,Pydantic 的所有类型检查、递归解析、默认值处理与序列化逻辑完全由纯 Python 代码驱动。由于 Python 本身的动态类型与解释器开销,面对复杂嵌套模型或高并发请求时,校验逻辑往往成为 CPU 密集型微服务的瓶颈。而在 V2 中,Pydantic 引入了双层解耦架构:上层继续提供符合 Python 类型提示习惯的声明式接口,而核心校验逻辑、类型转换器与 JSON 序列化器则全量迁移到底层 Rust 实现的 pydantic-core。
除了纯粹的性能提升,底层重构还修复了许多历史包袱:
- 内置方法命名空间净化:V1 中模型的通用方法(如
.dict()、.json()、.copy())直接占据了实例属性名,若模型定义了名为copy或dict的字段,就会发生严重冲突。V2 将所有内置方法统一加上model_前缀(如model_dump()、model_validate()),彻底释放了字段命名空间。 - 严苛与宽松双校验模式:V2 原生支持
strict=True严格校验模式。在宽松模式(默认)下,字符串"123"依然可以自动转换为整数123;而在严格模式下,类型必须完全一致,杜绝隐式类型转换带来的数据脏读。 - 验证与序列化分离:序列化逻辑独立为
Serializer,允许开发者针对不同的输出目标定制序列化行为,而不再混入校验链路。
二、迁移规划:四步安全实施法
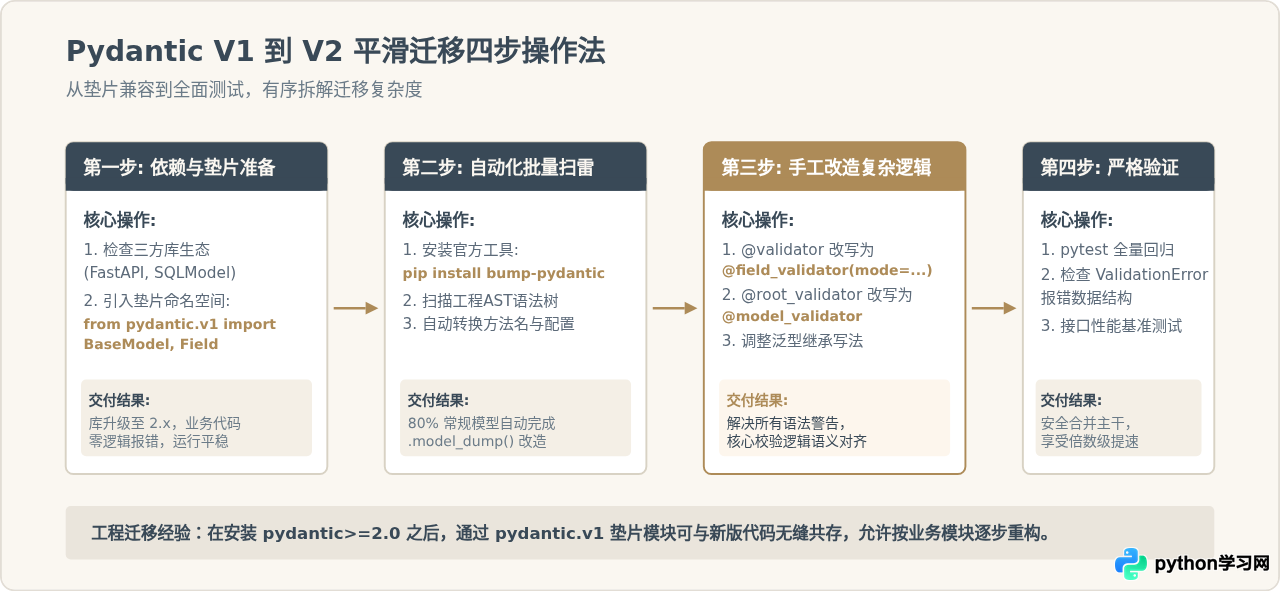
对于大型生产项目,切忌一刀切地直接升级依赖库。推荐采用分步走的策略:第一步先解决依赖兼容与运行时垫片,第二步使用自动化工具重构常规代码,第三步手工改造高级校验器,第四步通过测试回归上线。
三、使用 bump-pydantic 进行自动化语法重构
Pydantic 官方维护了代码迁移工具 bump-pydantic。该工具基于抽象语法树(AST)扫描 Python 代码,能够自动识别常见的废弃属性与方法调用,并完成批量替换。
首先在虚拟环境中安装工具:
pip install bump-pydantic在执行批量修改前,建议使用 --diff 参数进行预览:
bump-pydantic --diff app/确认无误后执行正式修改:
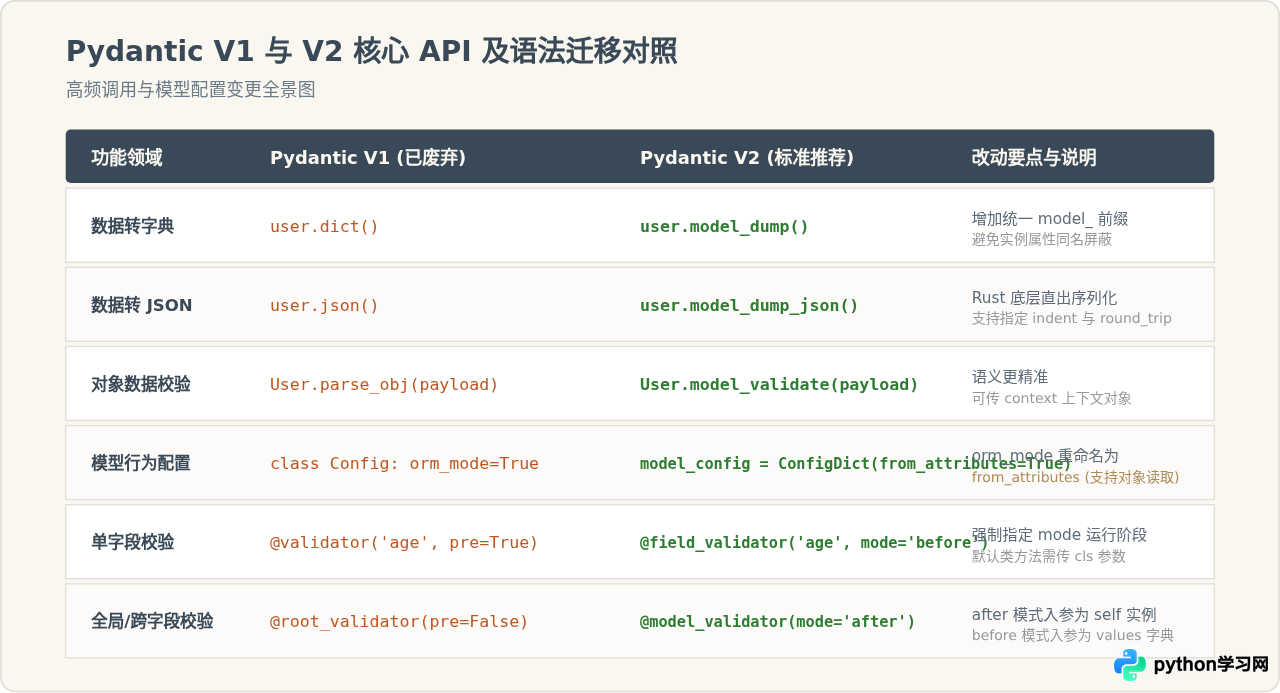
bump-pydantic app/bump-pydantic 可以自动完成以下转换:
- 将
model.dict()批量替换为model.model_dump() - 将
model.json()替换为model.model_dump_json() - 将
Model.parse_obj(data)替换为Model.model_validate(data) - 将
Model.parse_raw(raw_str)替换为Model.model_validate_json(raw_str) - 将内部类
class Config:转换为模块级model_config = ConfigDict(...) - 将
Field(regex=...)中的regex替换为pattern
bump-pydantic 无法完全处理复杂的 @validator 逻辑(尤其是涉及 pre=True、each_item=True、跨字段校验或需要访问完整上下文的场景),也无法自动转换高度动态的元编程代码。这些部分需要开发者进行人工代码审计与重写。
四、核心 API 与关键语法改写详解
下面深入剖析 V1 到 V2 最常修改的几个核心语法,并给出规范的重构代码示例。
1. 字段级校验器重构:从 @validator 到 @field_validator
在 V1 中,@validator 默认以 Python 转换后的值作为输入,参数传递比较隐式。V2 引入了 @field_validator,要求开发者显式定义校验模式 mode(可选 'after'、'before'、'plain' 或 'wrap')。
V1 代码写法:
# V1 遗留代码
from pydantic import BaseModel, validator

class UserProfile(BaseModel):
    username: str

    @validator("username")
    def validate_username(cls, value):
        if len(value) < 3:
            raise ValueError("用户名至少需要3个字符")
        return value.strip().lower()
V2 适配写法:
# V2 推荐代码
from pydantic import BaseModel, field_validator

class UserProfile(BaseModel):
    username: str

    @field_validator("username", mode="after")
    @classmethod
    def validate_username(cls, value: str) -> str:
        if len(value) < 3:
            raise ValueError("用户名至少需要3个字符")
        return value.strip().lower()
关键要点:在 V2 中,@field_validator 默认期望被修饰函数是一个类方法(@classmethod)。如果使用 mode="before",传入的 value 是未经任何类型校验的原始输入(可能是字符串、整数或任意类型),适合用来进行清洗或规整;如果使用 mode="after",传入的已经是通过类型强转的基础类型对象。
2. 模型级校验器重构:从 @root_validator 到 @model_validator
跨字段或关联业务的逻辑在 V1 中使用 @root_validator。这在 V2 中由 @model_validator 取代,且语义有了清晰划分:
mode="before":在模型任何字段被验证前触发,接收一个原始数据对象(通常为dict),必须返回修改后的数据结构。mode="after":在所有单字段验证完成后触发,作为实例方法执行,第一个参数为self,必须返回self。
V1 跨字段校验示例:
# V1 遗留代码
from pydantic import BaseModel, root_validator

class PasswordReset(BaseModel):
    password: str
    confirm_password: str

    @root_validator
    def check_passwords_match(cls, values):
        pw = values.get("password")
        cpw = values.get("confirm_password")
        if pw and cpw and pw != cpw:
            raise ValueError("两次输入的密码不一致")
        return values
V2 适配写法:
# V2 推荐代码
from typing_extensions import Self
from pydantic import BaseModel, model_validator

class PasswordReset(BaseModel):
    password: str
    confirm_password: str

    @model_validator(mode="after")
    def check_passwords_match(self) -> Self:
        if self.password != self.confirm_password:
            raise ValueError("两次输入的密码不一致")
        return self
3. 模型配置改造:ConfigDict 的使用
在 V1 中,模型的元行为通过内部类 class Config 定义。V2 统一改为类属性 model_config = ConfigDict(...),配合类型注解提供自动补全与静态类型检查。
# V2 规范配置
from pydantic import BaseModel, ConfigDict

class Article(BaseModel):
    model_config = ConfigDict(
        from_attributes=True,   # 替代 V1 的 orm_mode = True
        str_strip_whitespace=True, # 自动去除字符串前后空格
        populate_by_name=True,     # 替代 V1 的 allow_population_by_field_name
        extra="forbid"             # 禁止传入未声明的额外字段
    )

    title: str
    views: int
4. 泛型模型(GenericModel)的直接整合
在 V1 中,定义泛型返回结构必须从 pydantic.generics.GenericModel 继承。在 V2 中,GenericModel 已经完全弃用并并入 BaseModel,开发者只需标准多重继承 BaseModel 与 typing.Generic 即可:
# V2 泛型写法
from typing import Generic, TypeVar, List
from pydantic import BaseModel

DataT = TypeVar("DataT")

class ResponseEnvelope(BaseModel, Generic[DataT]):
    code: int = 0
    message: str = "success"
    data: DataT
五、迁移过程中必须防范的隐式陷阱
除了代码语法层面的报错,还有若干运行时逻辑行为的隐式变更,极易引发线上微小逻辑漂移:
- 默认值的浅拷贝机制:在 V1 中,字段默认值如果是可变对象(如
tags: list = []),Pydantic 会自动做深拷贝以防跨实例污染;而在 V2 中,推荐显式使用Field(default_factory=list),避免潜在的引用共享。 - ValidationError 结构微调:调用
error.errors()返回的字典结构中,错误定位路径由以前的字符串拼接变得更精确,type字段的报错枚举值也有所调整。如果前端或上游网关有强依赖特定type字符串的解析逻辑,需要同步核对测试。 - 正则表达式关键字:
Field(regex="^abc")必须改为Field(pattern="^abc"),若漏改会在模型初始化阶段直接抛出PydanticUserError。 - BaseSettings 独立拆包:配置读取模块
BaseSettings不再随pydantic主包附带,而是拆分到了独立的扩展库中。如果工程使用环境变量注入配置,需要单独安装并调整引用:pip install pydantic-settingsfrom pydantic_settings import BaseSettings, SettingsConfigDict
六、验证与上线保障总结
完成全量模块的代码改造后,工程迁移的最后一步是构建完备的验证防线。建议通过以下三个维度进行上线前验收:
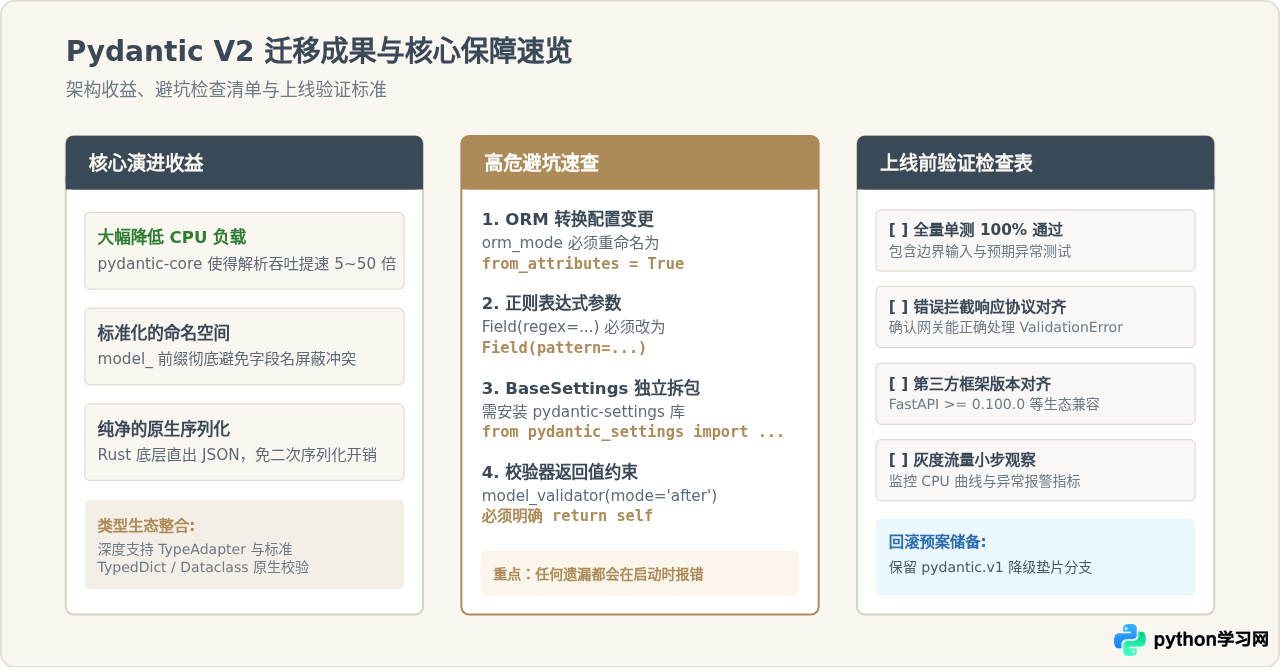
Pydantic V2 的迁移虽然伴随较多 API 语义的微调,但其底层的重构换来了显著的性能收益和更加健壮的类型系统。通过借助 pydantic.v1 垫片保持渐进式过渡、利用 bump-pydantic 完成机械性转换,并在业务核心重点关注 @field_validator 和 @model_validator 的执行时序,团队完全可以在低风险的前提下高效完成版本跨越。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









