

Python正则贪婪与非贪婪模式:.*与.*?的实际匹配差异
深入解析Python正则表达式中.*与.*?的核心匹配差异、回溯运作原理、代码示例及常见性能陷阱与优化方案。
在 Python 正则表达式中,.* 与 .*? 的根本分歧在于匹配跨度与退出时机:.* 属于贪婪模式(Greedy),在满足匹配规则的前提下会尽可能多地消耗字符,直到文本末尾后再逆向回溯;而 .*? 属于非贪婪模式(Non-greedy 或称惰性匹配),在满足规则的前提下尽可能少地消耗字符,每读入一个字符便尝试验证后续模式是否匹配成功,一旦满足便立即结束当前匹配。理解这一差异,不仅能避免在提取 HTML 标签、引号内容和日志片段时遭遇“过度匹配”的 Bug,还能在面对大体量文本时避免陷入严重的正则回溯性能陷阱。
一、匹配机制推导:从字符串吞食到回溯
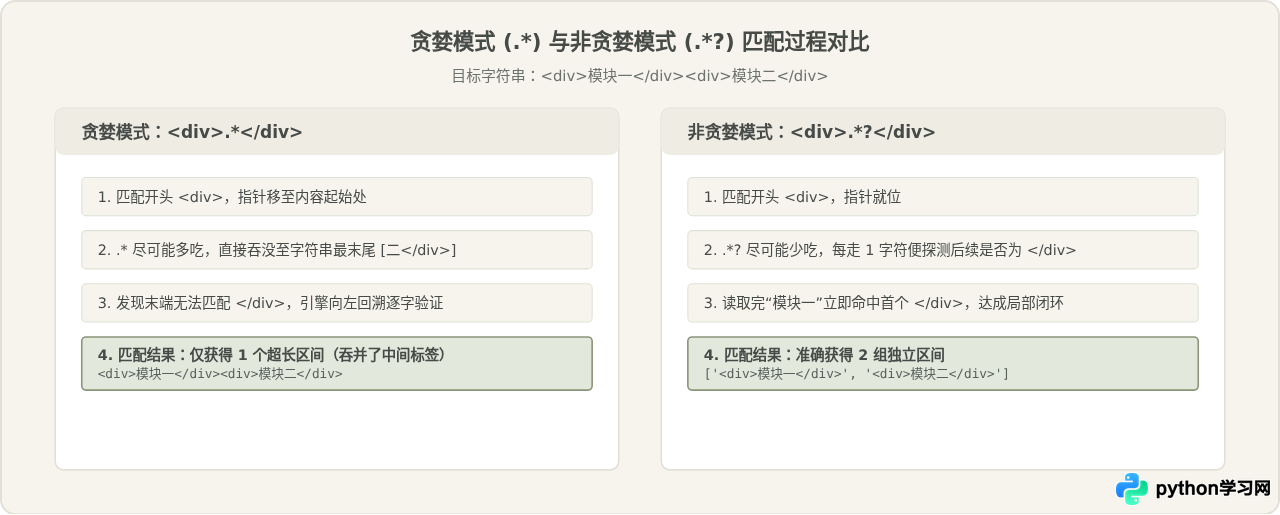
为了直观展现两者在执行层面的运作过程,假设我们需要处理一段包含两个 div 标签的文本:<div>模块一</div><div>模块二</div>,并希望提取出每个 div 内的内容。
当我们使用 <div>.*</div> 尝试匹配时:
- 正则引擎首先成功定位到开头的
<div>。 - 接下来遇到了
.*。由于贪婪特性,点号会一口气吞下剩余的全部字符串,直接读到整段文本的最末端。 - 引擎开始匹配模式尾部的
</div>。此时指针已在文本末端,无法向后读取,因此触发回溯(Backtracking)。 - 引擎指针从右向左逐字倒退,直到倒退至第二个
</div>的位置,发现刚好满足条件,于是整个匹配宣告完成。 - 最终提取到的结果是跨越两个标签的整串内容:
<div>模块一</div><div>模块二</div>,导致“多吃”了中间的内容。
而当我们换用非贪婪模式 <div>.*?</div> 时:
- 正则引擎同样先匹配开头的
<div>。 - 遇到
.*?后,引擎采取“能少吃就少吃”的策略。每读入一个字符(例如“模”),立即尝试检查其后是否紧跟着</div>。 - 当读完“模块一”后,指针刚好探测到第一个
</div>,此时完整表达式直接宣告成功匹配。 - 引擎锁定第一段结果
<div>模块一</div>,随后从第一个闭合标签之后继续搜寻,最终准确分割出两段独立的 div。
二、三个典型应用场景与代码验证
在实际 Python 开发中,re 模块的贪婪与非贪婪行为经常决定了业务逻辑的正确性。以下通过三组典型的代码场景进行实测对比。
场景 1:HTML 标签与结构化标记提取
当需要从 HTML 片段中抓取特定标签内容时,如果不显式声明非贪婪修饰符 ?,多组同类标签将被合并成一个大块输出。
import re

html_content = "<span>苹果</span><span>香蕉</span><span>橙子</span>"

# 贪婪模式匹配
greedy_result = re.findall(r"<span>.*</span>", html_content)

# 非贪婪模式匹配
nongreedy_result = re.findall(r"<span>.*?</span>", html_content)

print("贪婪匹配输出:", greedy_result)
print("非贪婪匹配输出:", nongreedy_result)非贪婪匹配输出: ['<span>苹果</span>', '<span>香蕉</span>', '<span>橙子</span>']
场景 2:双引号内的键值截取
在处理类似 JSON、配置文本或 SQL 语句中的引号内容时,贪婪匹配会导致第一个左引号与最后一个右引号之间的所有字段被一并抽走。
import re

text_line = 'name="Alice" role="Admin" dept="Security"'

# 贪婪模式:试图截取引号间内容
match_greedy = re.search(r'".*"', text_line)

# 非贪婪模式:遇到最近的右引号即终止
match_nongreedy = re.findall(r'".*?"', text_line)

print("贪婪匹配:", match_greedy.group() if match_greedy else None)
print("非贪婪匹配:", match_nongreedy)非贪婪匹配: ['"Alice"', '"Admin"', '"Security"']
场景 3:日志行时间戳与首段截取
在处理系统日志时,若希望截取中括号内的日志级别,贪婪模式可能将正文后方偶然出现的闭合括号一并卷入。
import re

log_line = "[INFO] [AUTH] User login failed: code [401] token expired"

# 贪婪模式匹配括号
res_greedy = re.search(r"\[.*\]", log_line).group()

# 非贪婪模式匹配首个中括号
res_nongreedy = re.search(r"\[.*?\]", log_line).group()

print("贪婪括号匹配:", res_greedy)
print("非贪婪首括号匹配:", res_nongreedy)非贪婪首括号匹配: [INFO]
三、深层辨析:回溯机制与性能认知偏差
不少开发者在使用过程中容易形成一种直觉认知:“非贪婪模式每次匹配的字符更少,所以运行速度肯定比贪婪模式更快”。这种看法并不准确,甚至在某些场景下恰恰相反。
正则引擎处理 .*(贪婪)时,内部使用的是长距离推进:底层可以快速利用字符串搜索原语掠过文本,只有在后置条件无法满足时才发生有限的回溯。而 .*?(非贪婪)的实质是高频试探:指针每步进一步,引擎就必须暂停当前量词,切换状态去尝试匹配后续字符,如果失败则恢复量词、再读入一个字符、再次测试后续字符。
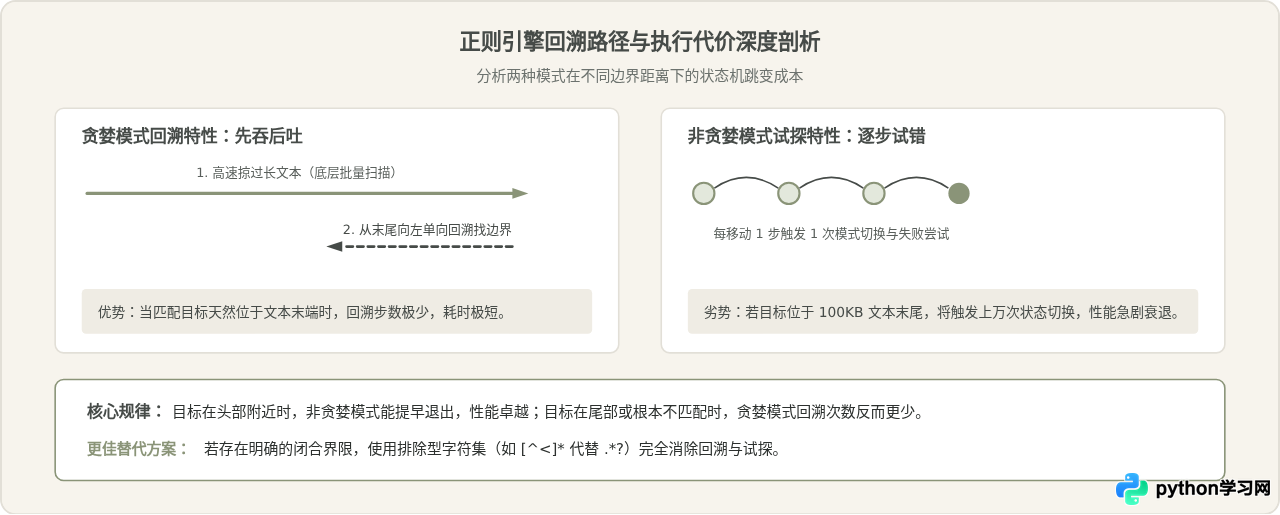
这意味着:非贪婪匹配绝不是没有代价的性能加速器。如果目标字符串长度很大,且期望的结束标记距离起始点非常远,非贪婪模式会在中间成千上万个字符位置不断尝试启动匹配,造成大量的状态保存与恢复开销。
四、进阶陷阱:换行符与灾难性匹配
在涉及复杂文本时,仅靠 .*? 依然容易踩坑,最常见的就是以下两个问题:
1. 点号(Dot)默认不匹配换行符
在 Python 正则中,. 默认匹配除换行符 \n 外的任意单个字符。如果标签内部存在换行:
import re

text_with_newline = """<div>
  第一行内容
  第二行内容
</div>"""

# 默认情况下 .*? 无法跨越换行,导致匹配失败返回空列表
print("默认匹配:", re.findall(r"<div>.*?</div>", text_with_newline))

# 必须启用 re.DOTALL (或 re.S) 标志,允许点号匹配换行符
print("re.DOTALL匹配:", re.findall(r"<div>.*?</div>", text_with_newline, re.DOTALL))re.DOTALL匹配: ['<div>\n 第一行内容\n 第二行内容\n</div>']
注意:一旦开启 re.DOTALL,贪婪模式 .* 的破坏力将成倍放大。若文件中包含数百个标签且缺少一个闭合标签,.* 会一口气吞没数万行代码直到整个文件结束,引发严重的内存占用和逻辑混乱。
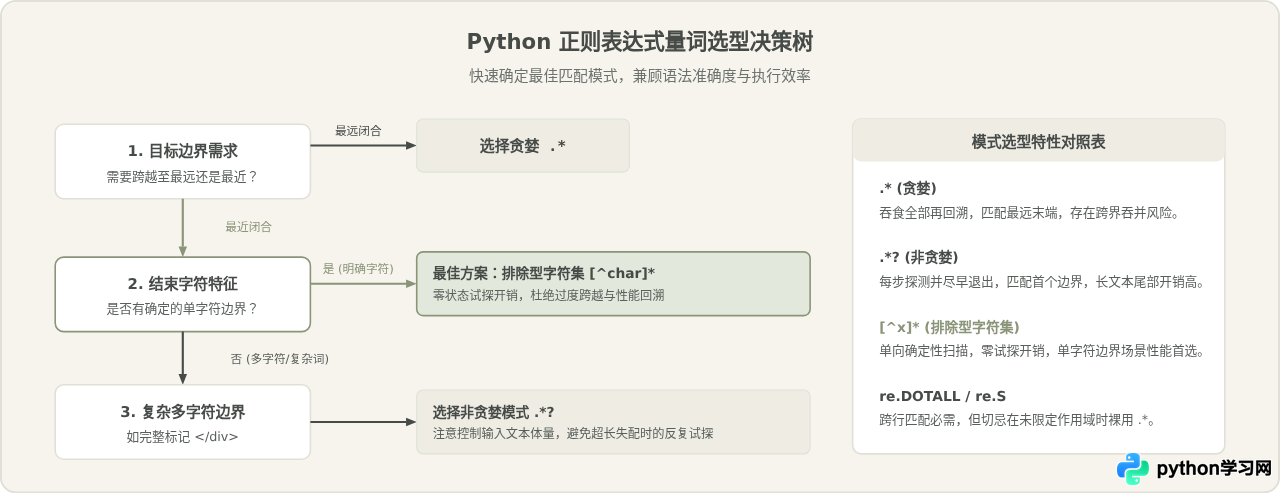
五、工程决策:何时用贪婪,何时用非贪婪?
在实际编码中,选择量词时可以遵循清晰的逻辑步骤:
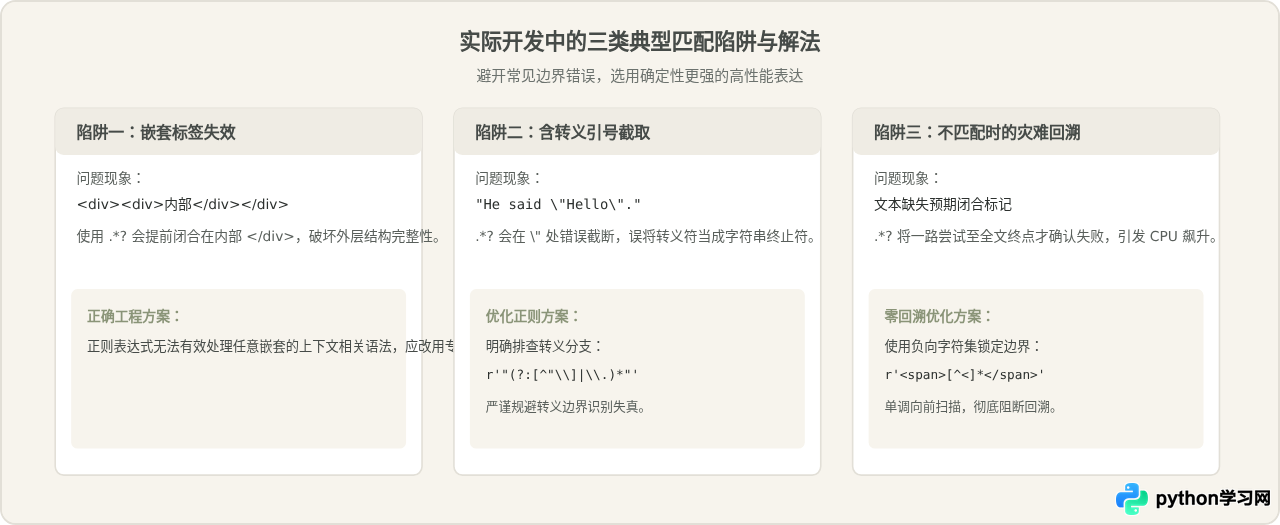
- 需要获取最远边界还是最近边界?如果需要匹配从第一个特定标识到最后一个标识的全部文本,使用
.*;如果希望遇到下一个标识就停止,使用.*?。 - 边界字符是否明确且唯一?如果边界字符非常具体(如右双引号
"或标签起始符号<),优先采用排除型字符集(Negated Character Class),例如用[^"]*替代.*?。排除型字符集属于确定性匹配,引擎无需在每个字符位置反复停顿测试后续模式,性能显著高于.*?且完全免疫回溯灾难。 - 文本规模是否庞大?若需在数十兆的日志或长文本中搜索,避免在未做行首/行尾锚定(
^或$)的情况下使用.*?,以防引发严重性能瓶颈。
六、总结
.* 与 .*? 并不是孰优孰劣的替代关系,而是对应着截然相反的匹配策略:
.*拥有极高的批量扫描速度,适合用于抓取整行剩余内容或确定需要最远闭合的场景,但必须防范因末端回溯造成的误吞并。.*?能够严格在最近的合法边界停下,是提取独立标签、短字段和成对符号的利器,但其高频试探特性要求开发者在面对长文本时警惕性能开销。- 在提取引号、括号等单字符包裹的数据时,应优先养成使用
[^x]*排除型字符集的习惯,这能从根本上消除不必要的正则回溯,写出既安全又高效的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









