

Python正则表达式怎么只匹配不提取:非捕获组实战
|)”或“量词约束(+、*)”等结构组合,但又不希望 re.findall() 或匹配对象将其作为捕获结果单独拆出时,只需将普通括号 (pattern) 改写为非捕获组语法 (?:pattern)。这样既能保证整体匹配规则生效,又能彻底避免产生独立的子捕获槽位。
一、问题起因:为什么普通括号会导致“只提取不给全文本”
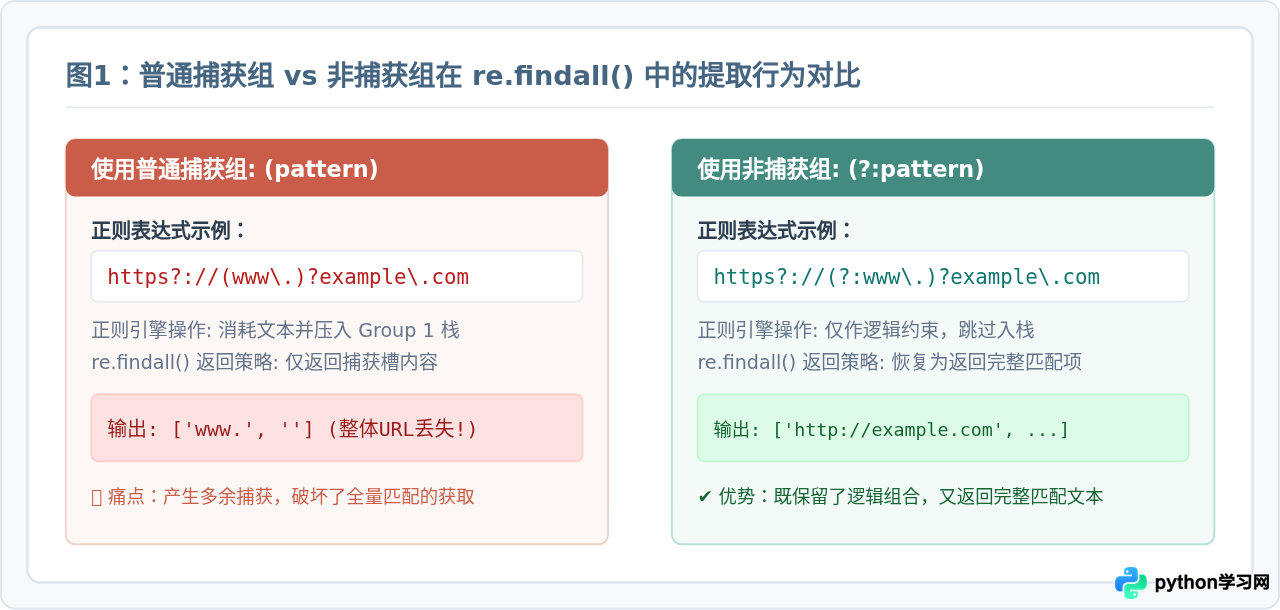
在编写 Python 数据清洗或文本解析脚本时,很多开发者都会遇到这样一个现象:原本用 re.findall() 可以完整拿回匹配文本,但为了给某几个可选词添加逻辑或(例如匹配 http:// 或 https://),随手加了一对圆括号 (http|https),结果 re.findall() 突然不再返回整个 URL,而是只返回了 ['http', 'https']。
这是因为 Python 的标准库 re 遵循了 POSIX 与 PCRE 的通用捕获组设计:在默认情况下,正则表达式中的每一对无前缀括号 (...) 都会被视作捕获型分组(Capturing Group)。正则引擎不仅会用它来限定作用域,还会专门在内存中分配一个索引槽位(即 group(1)、group(2)),将括号内所匹配的局部字符提取出来。
更关键的是,re.findall() 的返回规则具有如下分歧机制:
- 整个表达式无括号:返回由每次完整匹配内容组成的字符串列表(例如
['full_match_1', 'full_match_2'])。 - 表达式包含一个捕获组:忽略外部未被括号包裹的字符,仅返回捕获组对应的内容。
- 表达式包含多个捕获组:将每个匹配项的各个捕获组打包为元组,返回元组列表(例如
[('group1', 'group2'), ...])。
为了既享受括号带来的语法约束,又让 re.findall() 保持“返回完整匹配文本”的原生行为,非捕获组 (?:...) 应运而生。
二、非捕获组的语法构成与工作原理
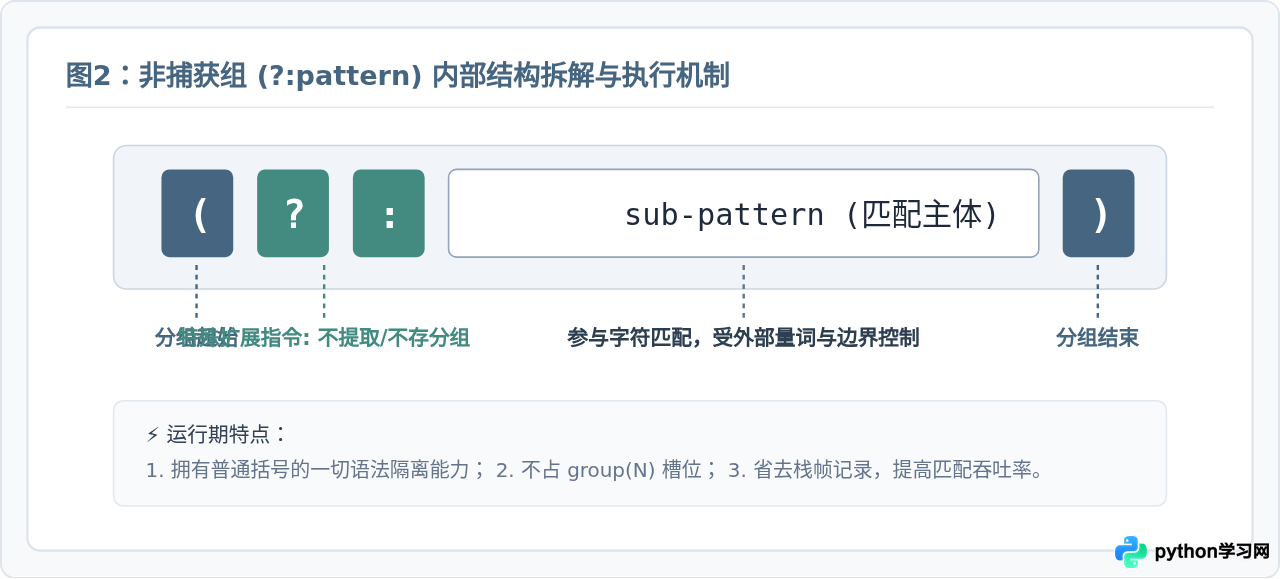
非捕获组的语法格式为:(?:表达式)。在左圆括号后紧跟一个问号和一个冒号 ?:。
其核心原理可以分解为两部分:
- 匹配期(Matching Phase):它与普通括号没有任何区别。括号内的字符、量词、逻辑分支(如
(?:cat|dog))全部参与文本匹配并消耗(consume)输入字符。 - 捕获期(Capturing Phase):当引擎匹配成功后,它会检测括号前置标志。检测到
?:标识时,引擎主动放弃创建分组序号,不向 Match 对象的groups()元组中写入数据。
三、三大高频实战场景与完整代码示例
场景 1:用 OR 分支匹配多选单位,但需提取包含数值的完整词
在解析前端样式表或配置文件时,常常需要抓取类似 120px、1.5em、32rem 等带单位的尺寸值。如果我们为了约束单位种类而写成 r'\d+(?:\.\d+)?(px|em|rem)',调用 re.findall() 就只会拿到单位字符串 ['px', 'em'],而丢弃了前面的数值部分。
此时将单位分支放进非捕获组中,即可保留整体:
import re

text = "容器宽度设置:margin: 20px; font-size: 1.5rem; line-height: 24px; padding: 10em;"

# 错误写法:使用普通捕获组
wrong_pattern = r'\d+(?:\.\d+)?(px|em|rem)'
print("普通括号 findall 结果:", re.findall(wrong_pattern, text))
# 示例输出: ['px', 'rem', 'px', 'em']  <- 丢失了数字部分!

# 正确写法:将单位分支放进非捕获组
correct_pattern = r'\d+(?:\.\d+)?(?:px|em|rem)'
print("非捕获组 findall 结果:", re.findall(correct_pattern, text))
# 示例输出: ['20px', '1.5rem', '24px', '10em']  <- 成功保留完整匹配项!
场景 2:重复模式匹配(量词整体修饰)
匹配类似 IPv4 地址或版本号时,格式是由点和数字重复构成的(例如 192.168.1.1 由 3 个“数字+点”加 1 个“数字”组成)。很多初学者会写出 r'(\d{1,3}\.){3}\d{1,3}':
import re

log_line = "Client connected from 192.168.1.100 and proxy 10.0.0.1"

# 错误写法:量词修饰普通捕获组
bad_pattern = r'(\d{1,3}\.){3}\d{1,3}'
print("捕获组匹配 IP:", re.findall(bad_pattern, log_line))
# 示例输出: ['1.', '0.']
# 原因:量词重复迭代时,普通捕获组每次都会被覆写,最终只留下了第三次匹配到的最后一个段!

# 正确写法:使用非捕获组
good_pattern = r'(?:\d{1,3}\.){3}\d{1,3}'
print("非捕获组匹配 IP:", re.findall(good_pattern, log_line))
# 示例输出: ['192.168.1.100', '10.0.0.1']  <- 完整返回整个 IP 地址
场景 3:re.split() 分割文本时不保留分隔符
Python 中的 re.split() 有一个特殊行为:如果正则模式中包含捕获括号,被匹配到的分隔符本身也会被插入到返回的切分结果列表中。如果不希望分隔符出现在切分列表中,就必须使用非捕获组。
import re

data = "Apple; banana| cherry, orange;melon"

# 使用普通捕获组切分
parts_with_delim = re.split(r'(;|\s*\|\s*|,)', data)
print("普通捕获组切分:", parts_with_delim)
# 示例输出: ['Apple', ';', ' banana', '|', ' cherry', ',', ' orange', ';', 'melon']

# 使用非捕获组切分
parts_clean = re.split(r'(?:;|\s*\|\s*|,)', data)
print("非捕获组纯净切分:", parts_clean)
# 示例输出: ['Apple', ' banana', ' cherry', ' orange', 'melon']
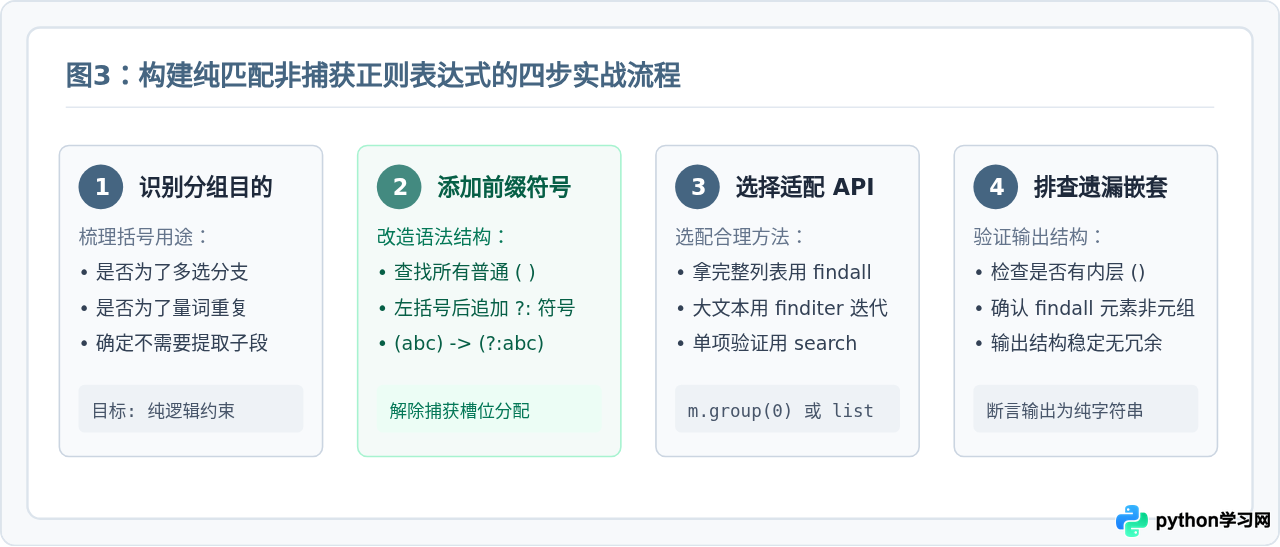
四、编写“只匹配不提取”正则的四步操作规范
在实际编码中,按照以下标准流程逐步推导和检查,可以一次性写出行为符合预期的非捕获正则:
五、非捕获组与常见相似语法的边界区分
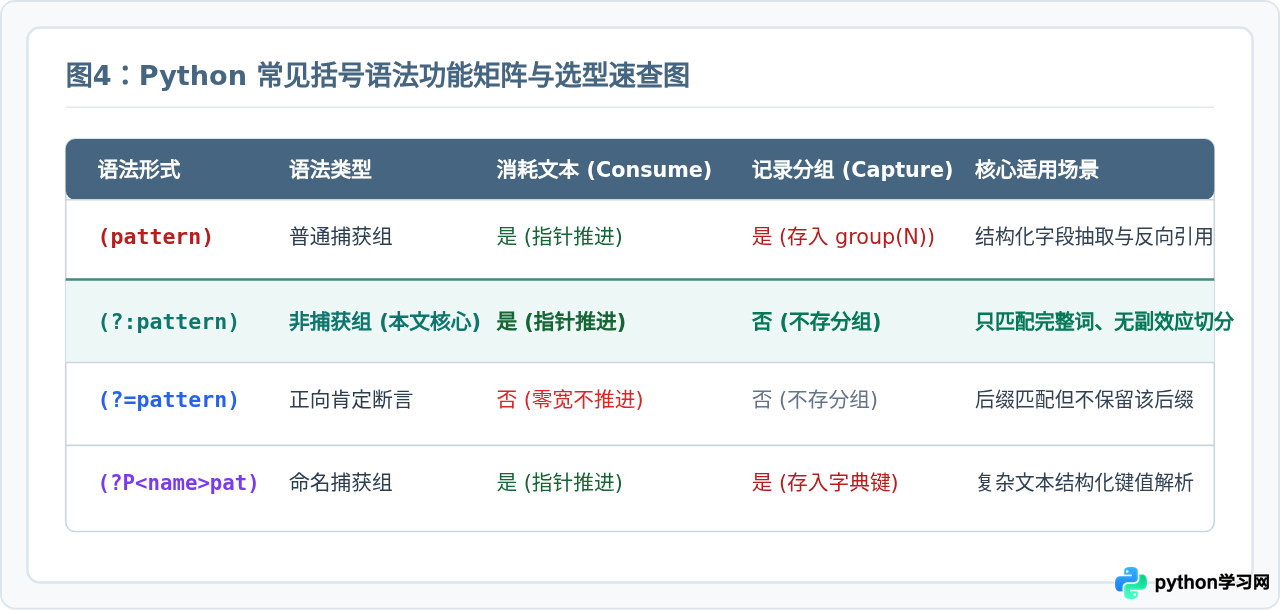
在 Python 正则表达式体系中,以括号配合问号开头的扩展语法较多,最容易混淆的是非捕获组与环视断言(Lookaround)。
- 非捕获组
(?:pattern):会消耗字符。匹配指针会走过这部分字符,最终匹配结果的group(0)中包含这部分文本。 - 正向肯定断言
(?=pattern):是零宽断言(Zero-width),不消耗字符。它只像雷达一样向前探查后续文本是否满足条件,探查完后指针退回原处,最终匹配结果不包含断言内的字符。
(?:...);如果这部分字符仅仅作为“锚点”或“触发条件”,最终提取结果里完全不应该出现它,使用断言 (?=...)。
六、容易踩坑的细节提醒
- 嵌套括号泄漏:在复杂的正则模式中,如果外层使用了非捕获组
(?:...),但内层无意中混入了普通括号,例如(?:abc|(def)),则内层的def依然会被当成独立的捕获组。排查时应自内向外确认每一对圆括号是否都按需加上了?:。 - 性能收益:在大规模日志分析或长文本高频扫描场景下,如果不需要提取字段,全量使用
(?:...)替代(...)可以省去回溯栈对分组位置的内存开销与状态维护,正则匹配性能通常会有 10%~25% 的提升。 - 配合 re.finditer 的优雅处理:在处理超大文本时,即使使用了非捕获组,一次性使用
re.findall()生成长列表仍可能消耗过多内存。推荐使用re.finditer(r'(?:...)', text),遍历 Match 对象并直接读取match.group(0)获取完整匹配串。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









