

Python数据分析方向学习指南:NumPy、Pandas与可视化实战路径

一、核心技能树与进阶顺序
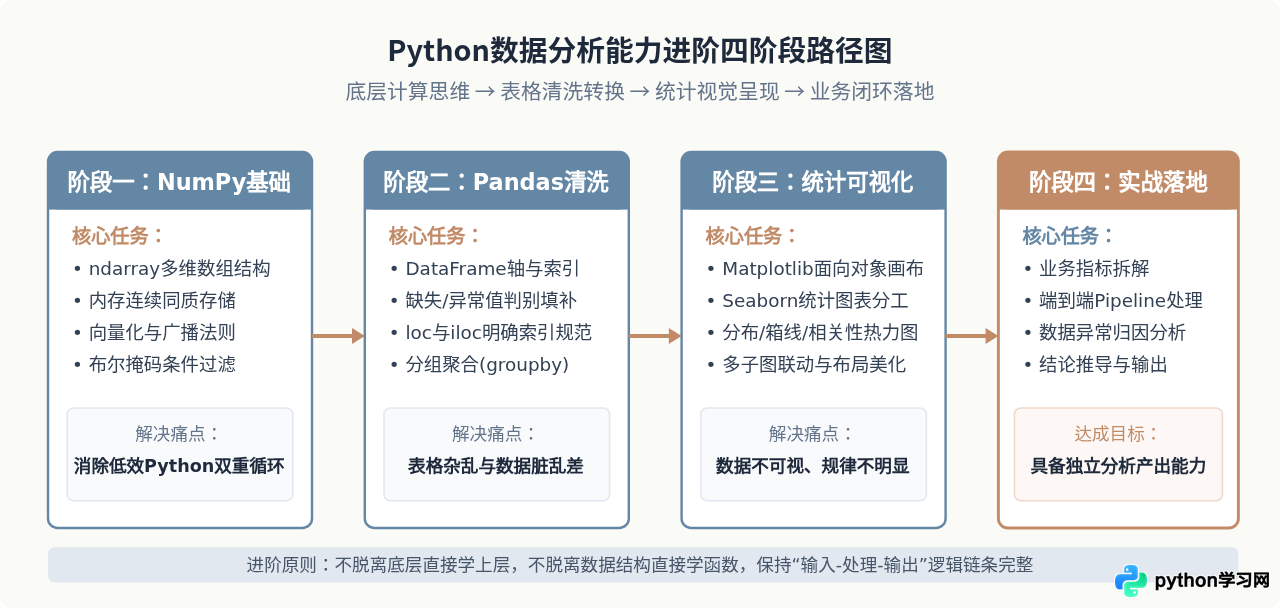
学习Python数据分析常见的障碍是过早陷入细节代码,导致面对真实杂乱数据时不知从何下手。正确的学习过程应当遵循数据在内存中流转的物理规律与业务加工逻辑:
- 阶段一:NumPy计算底层(理解向量化与广播)——理解连续同质存储机制,摆脱慢速的Python原生for循环,掌握多维数组切片与掩码过滤。
- 阶段二:Pandas数据规整(掌握清洗与轴对齐)——掌握Series与DataFrame的索引对齐逻辑,熟练处理缺失值、重复项、类型转换与分组聚合。
- 阶段三:数据探索与统计可视化(图表传达特征)——掌握面向对象绘图规范,运用分布图、关系图、分类图揭示数据内在规律。
- 阶段四:业务实战综合闭环(端到端分析落地)——从原始格式文件导入,经过规范的管道化清洗与特征提取,最终输出可靠的分析报告与图表。
二、NumPy底层计算机制与向量化思维
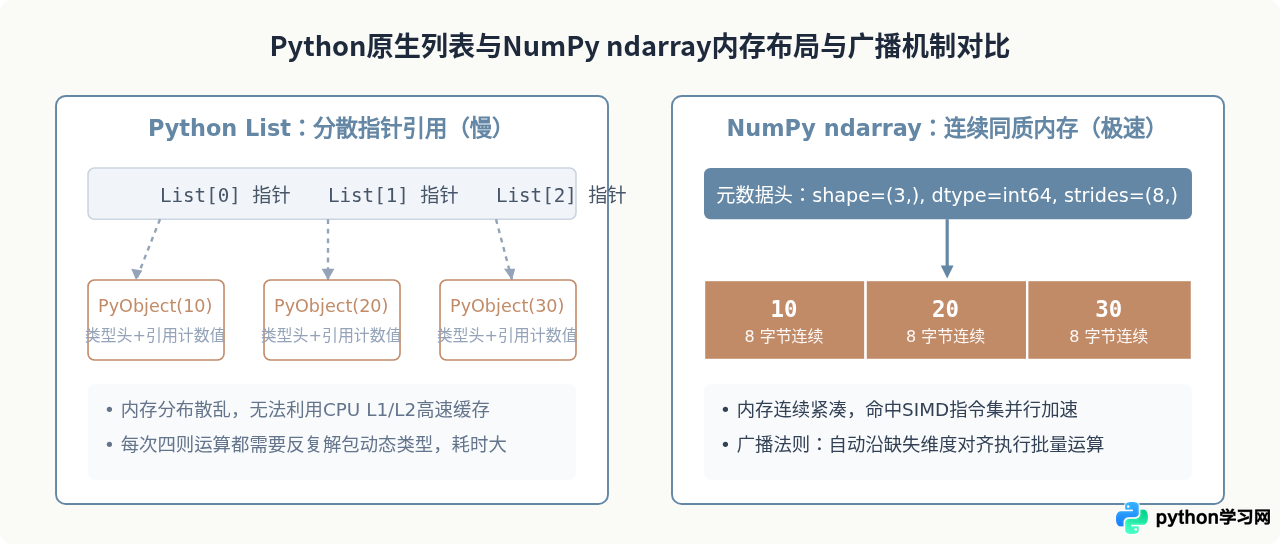
NumPy(Numerical Python)是整个数据分析技术栈的算力基石。初学者常犯的错误是将NumPy数组当作常规的Python列表使用。Python原生的list存储的是指向对象的指针引用,内存地址不连续,且每次访问都要进行动态类型检查;而NumPy的核心数据结构ndarray(N-dimensional Array)是一段物理连续的内存块,所有元素具有完全相同的固定类型(dtype)。
1. 向量化计算与广播法则
NumPy最核心的运算优势来自向量化(Vectorization)与广播(Broadcasting)。所谓向量化,就是把循环推给底层编译过的C语言循环执行;所谓广播,则是当两个数组形状不同时,NumPy根据严格规则自动扩展较小的数组以完成形状匹配:
- 如果两个数组的维度数不同,维度较少的数组会在前部补齐维度大小为1的形状;
- 在任何一个维度上,如果一个数组的长度为1而另一个大于1,长度为1的数组会沿着该轴复制展开;
- 如果在某个轴上长度既不相等也不为1,则无法广播并抛出
ValueError。
import numpy as np

# 1. 数组创建与形状检查
arr_2d = np.array([[10, 20, 30], [40, 50, 60]], dtype=np.float64)
bias = np.array([1.5, 2.0, 0.5])  # shape: (3,)

# 2. 向量化与广播计算(无需写for循环)
adjusted_arr = arr_2d * 1.1 + bias  # bias自动广播匹配每行
print("广播计算结果示例:\n", adjusted_arr)

# 3. 高效条件过滤(布尔掩码)
mask = adjusted_arr > 35.0
filtered_values = adjusted_arr[mask]
print("条件过滤后的扁平元素:", filtered_values)sub_arr = arr[0:2, :])返回的是原数组的视图(View),并没有复制底层内存数据。修改 sub_arr 的值会直接改变原数组 arr。如果需要独立副本,必须显式调用 arr[0:2, :].copy()。
三、Pandas数据清洗、对齐与重构
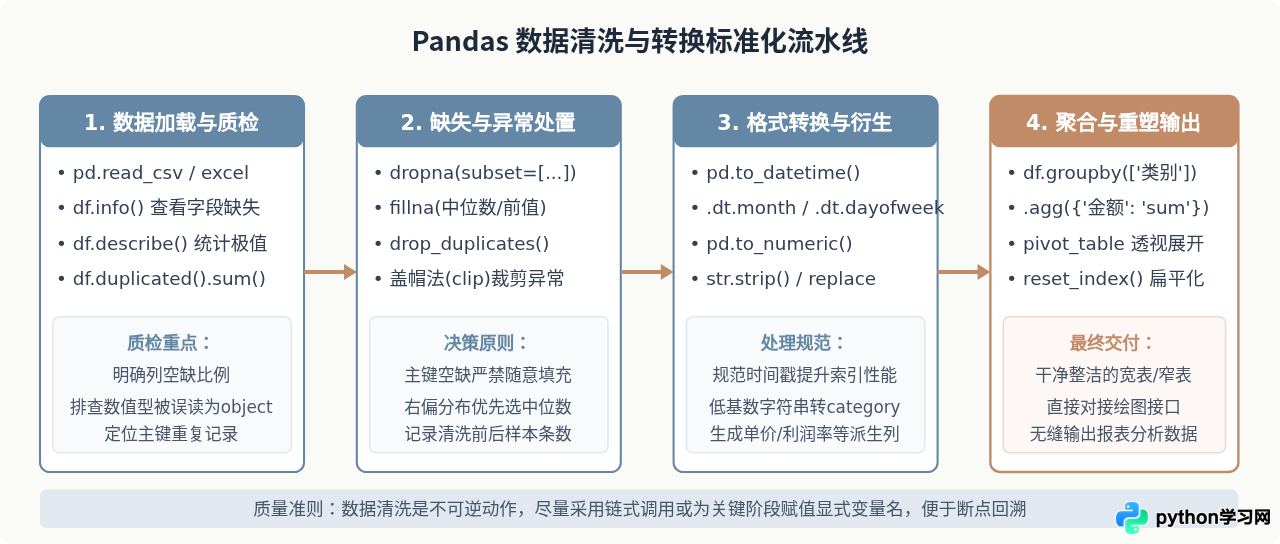
如果说NumPy负责底层的数值阵列,那么Pandas则是处理真实业务数据的中枢。真实世界的数据通常具有三个特点:列类型不一致(有文本、数值、日期)、含有缺失脏数据、以及需要基于业务主键进行多表关联。Pandas的核心结构DataFrame正是在NumPy ndarray的基础上,增加了显式的行索引(index)与列标签(columns)。
1. 切片选择的标准方式:loc 与 iloc
很多初学者随意使用 df['col'][0:5] 这种链式切片,极易引发 SettingWithCopyWarning 警告并造成隐蔽的赋值失败。在Pandas中必须严格按照以下规则选取代号:
df.loc[行标签, 列标签]:基于显式文本或数值标签选取。包含起止两端闭区间。df.iloc[行整数位置, 列整数位置]:基于纯从0开始的整数位置偏移量选取。符合Python左闭右开区间惯例。
import pandas as pd
import numpy as np

# 构建包含脏数据的样本业务表
raw_data = {
    'order_id': ['A101', 'A102', 'A103', 'A104', 'A104', 'A105'],
    'user_id': [1001, 1002, 1003, 1004, 1004, 1005],
    'order_time': ['2023-10-01 09:12', '2023-10-01 11:30', '2023-10-02 14:00', '2023-10-02 15:20', '2023-10-02 15:20', '2023-10-03 18:40'],
    'category': ['电子产品', '日用百货', '电子产品', '日用百货', '日用百货', '生鲜食品'],
    'amount': [1299.0, 45.5, np.nan, 88.0, 88.0, -10.0]  # 含有缺失值与异常负数
}
df = pd.DataFrame(raw_data)

# 1. 剔除完全重复行
df = df.drop_duplicates(subset=['order_id']).copy()

# 2. 转换日期格式
df['order_time'] = pd.to_datetime(df['order_time'])

# 3. 缺失值与异常值清洗(loc安全赋值)
category_median = df.groupby('category')['amount'].transform('median')
df['amount'] = df['amount'].fillna(category_median)
df.loc[df['amount'] < 0, 'amount'] = np.nan
df = df.dropna(subset=['amount']).copy()

# 4. 聚合统计:计算各品类订单量与总金额
summary_df = df.groupby('category').agg(
    order_count=('order_id', 'count'),
    total_revenue=('amount', 'sum'),
    avg_order_value=('amount', 'mean')
).reset_index()

print("品类汇总数据示例:\n", summary_df)SettingWithCopyWarning 时,切勿用关闭警告的配置(pd.options.mode.chained_assignment = None)掩盖问题。本质原因是你在某个中间视图(View)上赋值,Pandas无法判定该修改能否如期反映到原表中。标准做法是使用 .loc[mask, 'col'] = value 或者在子集产生后显式使用 .copy() 隔断血缘关系。
四、统计可视化:从数据清洗到商业洞察
数据清洗完成后,海量的表格数字难以直接被人脑感知,此时需要通过可视化手段揭示变量分布、异常离群值与相关性规律。Python数据可视化生态中,最常用的是 Matplotlib 与 Seaborn:
- Matplotlib(底层画布):提供完整的图形基建(Figure、Axes、Axis、Tick)。控制力极强,能微调从边距、字体到坐标轴刻度的所有像素级细节,但绘制复杂统计图代码较为冗长。
- Seaborn(高级统计包装):基于Matplotlib构建,原生支持直接传入Pandas DataFrame。仅需一两行代码即可自动完成均值聚合、置信区间渲染与多分类着色(hue)。
| 分析维度 | 推荐图形 | 推荐工具库 | 分析目的与适用场景 |
|---|---|---|---|
| 单变量数值分布 | 直方图(Histplot)/ 箱线图(Boxplot) | Seaborn | 观察数据集中趋势、右偏/左偏程度,快速识破极端离群值 |
| 双连续变量关联 | 散点图(Scatter)/ 回归线图(Regplot) | Seaborn | 验证两个指标之间是否存在线性正负相关或非线性模式 |
| 时间序列趋势 | 折线图(Lineplot) | Matplotlib / Seaborn | 反映指标随时间轴的变化波动、周期性及增长态势 |
| 跨维度特征相关 | 热力图(Heatmap) | Seaborn | 快速扫描多个数值字段之间的皮尔逊相关系数矩阵,定位共线性 |
import matplotlib.pyplot as plt
import seaborn as sns

# 推荐实践:采用面向对象风格(Object-Oriented API)
fig, axes = plt.subplots(1, 2, figsize=(12, 5), dpi=100)

# 子图1:各分类销售总额对比(条形图)
sns.barplot(
    data=summary_df,
    x='category',
    y='total_revenue',
    color='#6487A5',
    ax=axes[0]
)
axes[0].set_title('各品类总销售额分布', fontsize=13, pad=10)
axes[0].set_xlabel('商品品类', fontsize=11)
axes[0].set_ylabel('销售金额 (元)', fontsize=11)
axes[0].grid(axis='y', linestyle='--', alpha=0.5)

# 子图2:客单价均值对比
sns.barplot(
    data=summary_df,
    x='category',
    y='avg_order_value',
    color='#C28B68',
    ax=axes[1]
)
axes[1].set_title('各品类平均客单价', fontsize=13, pad=10)
axes[1].set_xlabel('商品品类', fontsize=11)
axes[1].set_ylabel('客单均价 (元)', fontsize=11)
axes[1].grid(axis='y', linestyle='--', alpha=0.5)

plt.tight_layout()
# plt.show()  # 在本地执行时调用展示
五、知识全景与场景选型决策
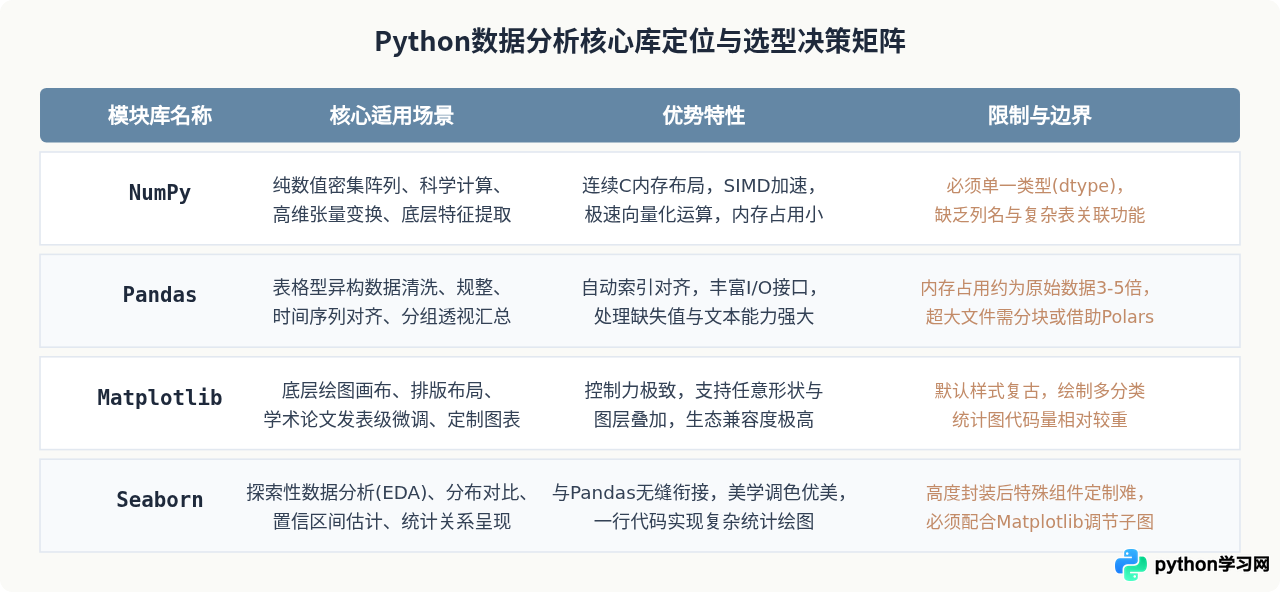
为了让不同阶段的代码编写者在面对具体业务需求时能快速选择最优工具,下方的决策矩阵总结了NumPy、Pandas、Matplotlib及Seaborn的职能分工与协同关系:
六、实践总结与常见问题排查
完成全流程学习后,在日常编写分析脚本时,建议牢记以下工程自检标准:
- 拒绝纯循环思维:在NumPy与Pandas中,只要写出了嵌套的
for i in range(len(df)):,95%以上都可以被vectorized operation、isin()、map()或apply()替代。 - 守住数据类型边界:读取数据后第一时间检查
df.dtypes。如果数值列被识别为object,通常是因为混入了空格、特殊破折号或脏字符,应先使用字符串方法清理后再转为数值。 - 保持绘图结构整洁:绘制可视化图表时始终使用
fig, ax = plt.subplots(...)显式指定坐标轴,避免混淆全局plt状态,从而杜绝多子图互相污染的现象。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









