

从零开始学Python数据分析:需要掌握哪些基础知识?

零基础接触Python数据分析,最容易陷入的误区是把整门计算机语言当成前置门槛去死记硬背。事实上,从事数据分析并不需要掌握Web后端开发、异步并发、装饰器高阶黑魔法或桌面GUI编程。数据分析的核心主线非常清晰:掌握够用的Python基础语法、熟练运用数据处理三件套(NumPy、Pandas、Matplotlib/Seaborn)、理解数据清洗的基本逻辑,以及建立将实际业务问题抽象为数据表格操作的思维能力。
一、知识图谱:精简聚焦的四层结构
许多初学者学了三个月还在死磕多线程和面向对象继承,转头面对一个实际的销售Excel表格依然不知从何下手。如果目标是快速进入数据分析实战,知识储备应当从底层语法向高层业务递进,剔除所有与数据加工无关的旁支体系。
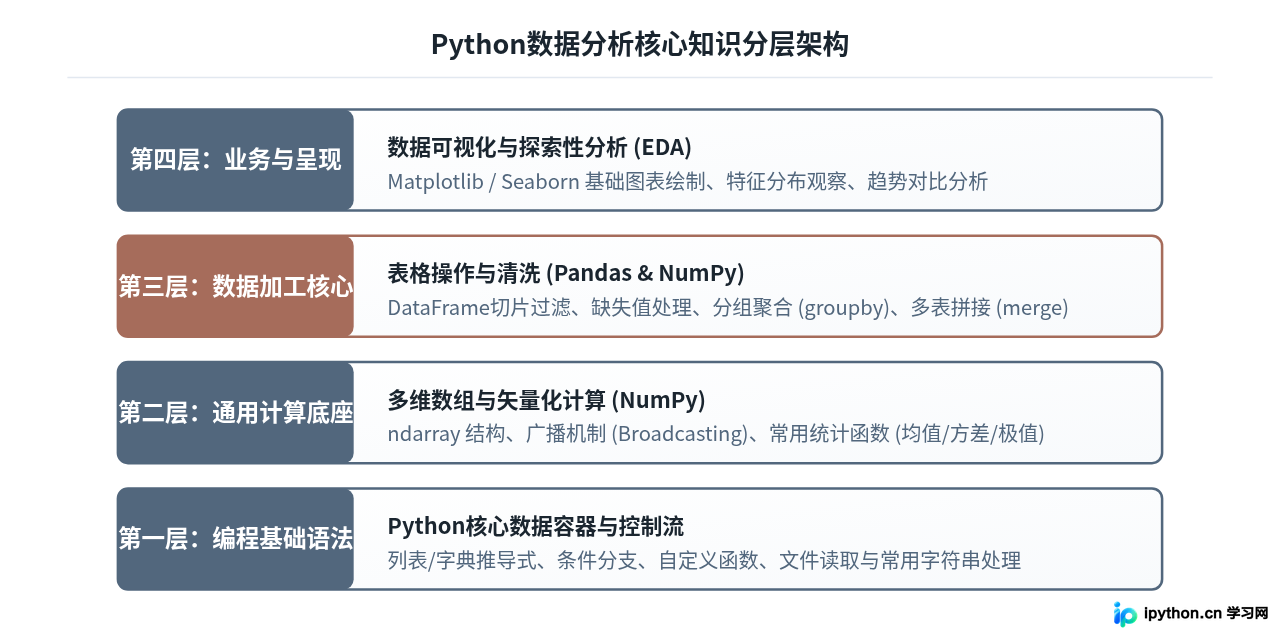
图1:Python数据分析知识分层架构(由底层语言基础向顶层分析呈现递进)
如图1所示,学习路径可以清晰地分为四个层级。只要在每一层掌握恰好满足下一层需求的知识,就能以最短路径进入真实数据分析任务,避免在无关的技术细节上消耗精力。
二、第一层:Python语言中真正必须掌握的基础语法
学习Python语言本身时,只需关注数据分析中高频使用的容器和控制结构。具体包含以下四部分:
1. 基础容器:列表(List)与字典(Dictionary)
在实际分析中,外部导入的数据往往先以字典列表的形式出现。例如从接口抓取的数据通常形如 [{"name": "张三", "sales": 120}, ...]。熟练掌握字典的键值存取、列表的切片与追加、以及字典嵌套列表的提取方式,是后续将数据转换为表格结构的前提。
2. 控制流程与推导式
除了标准的 if-else 条件判断和 for 循环,列表推导式与字典推导式是日常代码中使用率极高的工具。例如快速清洗一组字符串格式的金额字段:
# 示例:提取并清洗列表中的异常值与字符串
raw_data = [" 120 ", "350", "N/A", " 480 "]
cleaned_data = [int(x.strip()) for x in raw_data if x.strip().isdigit()]
# cleaned_data 输出结果示例: [120, 350, 480]
3. 函数封装与 Lambda 表达式
不需要深入研究闭包或元类,但必须能够独立编写接收输入、返回处理结果的函数。此外,熟练使用单行 lambda 匿名函数至关重要,因为后续在 Pandas 中使用 apply() 或 map() 方法批量转换整列数据时,几乎都是依靠 Lambda 表达式完成的。
三、第二层:数值计算与表格处理核心库
Python 之所以成为数据分析的首选工具,主要归功于科学计算生态库。这个生态的核心由 NumPy 与 Pandas 构成,二者分工明确:
1. NumPy:矢量化计算的底层引擎
NumPy 提供了连续内存存储的 ndarray 对象。与原生 Python 列表通过循环逐个计算相比,NumPy 采用底层的 C 语言向量化运算,性能高出数十倍。在数据分析中,你不需要推导高级线性代数,但必须理解:
- 数组形状(Shape 与 Reshape):了解数据是一维向量还是二维矩阵。
- 广播机制(Broadcasting):当一维数组与二维矩阵进行加减乘除时,NumPy 如何自动扩展维度匹配。
- 缺失值标记:
np.nan是浮点型的非数值占位符,理解其在比较运算中的特殊性(例如np.nan == np.nan结果为False)。
2. Pandas:数据分析绝对的核心工具
可以说,日常80%以上的数据分析工作都是在与 Pandas 的 DataFrame(二维表格)打交道。掌握 Pandas 必须重点突破以下六项基本操作:
| 操作类别 | 核心方法 / 语法 | 实际分析应用场景 |
|---|---|---|
| 文件导入与导出 | pd.read_csv(), pd.read_excel() |
读取本地业务数据表格,指定编码、分隔符或表头行 |
| 行列定位与切片 | df.loc[] (基于标签), df.iloc[] (基于位置) |
按指定条件筛选符合标准的客户订单或指标行 |
| 布尔索引过滤 | df[(df['sales'] > 100) & (df['city'] == '北京')] |
多维度组合筛选特定业务子集 |
| 分组聚合统计 | df.groupby('category')['revenue'].agg(['mean', 'sum']) |
按品类统计销售总额、客单价等分组汇总指标 |
| 多表关联拼接 | pd.merge(left, right, on='user_id', how='left') |
类似 SQL 的 JOIN 操作,关联用户信息表与订单记录表 |
| 缺失值与重复值 | df.dropna(), df.fillna(), df.drop_duplicates() |
清洗冗余记录,填补指标空缺 |
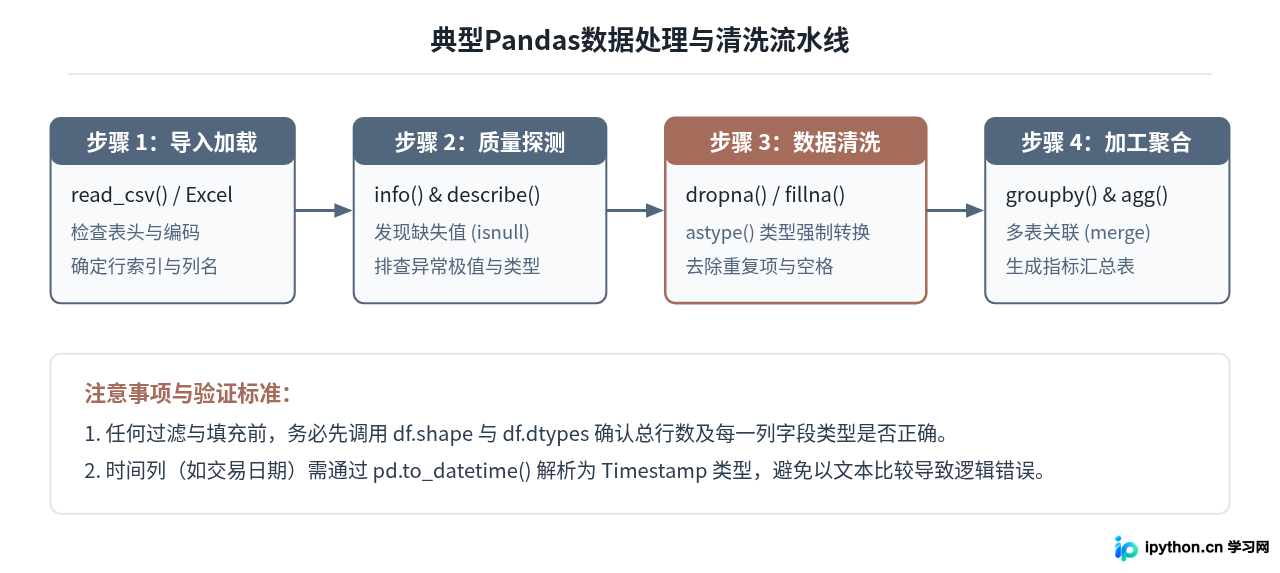
图2:Pandas 数据处理与清洗的典型操作步骤流程
四、第三层:数据可视化基础
完成数据整理后,需要将数据指标转化为直观图表展示给业务方或决策者。可视化工具库非常多,但入门阶段只需聚焦两个:
- Matplotlib:Python 可视化的底层基石。重点掌握
Figure(画布)和Axes(坐标轴)的面向对象作图接口、标题与坐标轴标签的中文显示配置、以及多子图排版。 - Seaborn:基于 Matplotlib 封装的高级统计绘图库,针对 Pandas DataFrame 做了专门优化。只需一两行代码即可绘制出分布图(Distribution Plot)、分类箱线图(Boxplot)或相关性热力图(Heatmap)。
图表选择的基本原则是:对比离散分类用柱状图,观察连续趋势用折线图,研究单变量分布用直方图或箱线图,探究双变量关系用散点图。切忌为追求酷炫而堆叠难以解读的高维复杂图表。
五、第四层:必不可少的基础分析思维与统计常识
代码只是工具,驱动分析的是对数据的敏感度与基本统计学概念。零基础学习者不需要掌握复杂的机器学习算法,但以下三类统计常识是数据解释的底线要求:
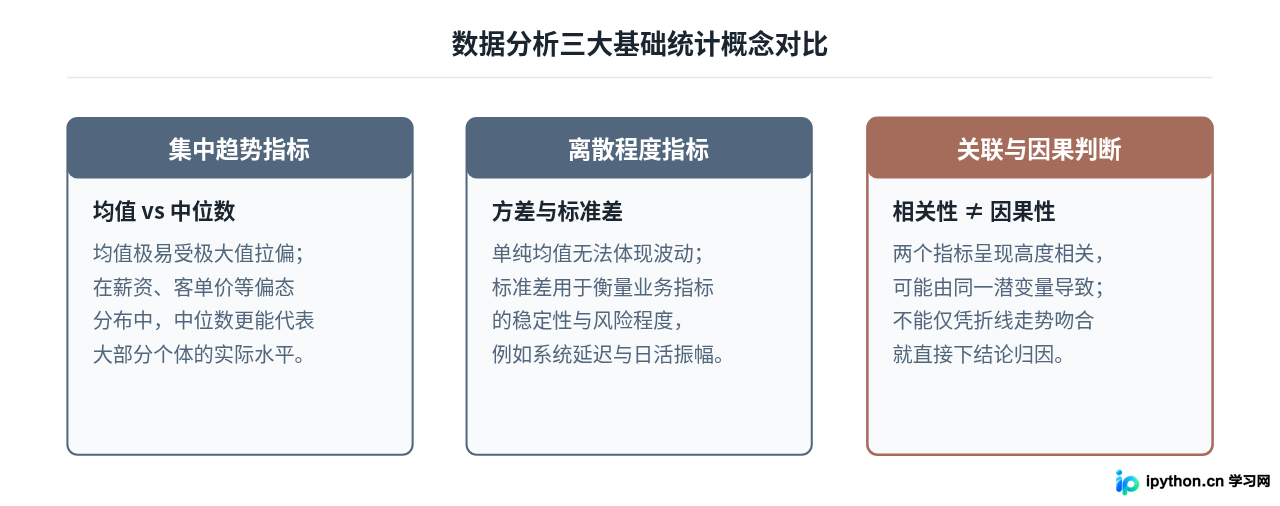
图3:数据分析入门阶段必备的核心统计思维与判断依据
在清洗与解读数据时,如果缺乏这些统计直觉,很容易得出荒谬的结论。例如仅看“部门平均工资”而忽略中位数与分布形态,或者把促销期间因为打折带来的销售额提升误判为产品本身吸引力增强。
六、零基础学习路径与避坑建议
根据上述四个维度的核心内容,初学者的阶段规划应当以“最小必要知识”为原则,快速闭环:
推荐的学习顺序与周期节奏:
- 第1周(Python基础):重点攻克数据类型、列表与字典、for循环与简单函数编写,不要碰面向对象设计模式。
- 第2周(Pandas表格实战):掌握 DataFrame 数据的增删查改、条件过滤、groupby 分组聚合与 merge 表关联。找一个公开的销售数据集亲手复现。
- 第3周(数据清洗与指标计算):深入练习空值处理、类型格式化、异常值定位、日期时间序列解析。
- 第4周(可视化与业务输出):学习 Matplotlib 和 Seaborn 常用统计图表,尝试输出一份图文结合的探索性数据分析报告。
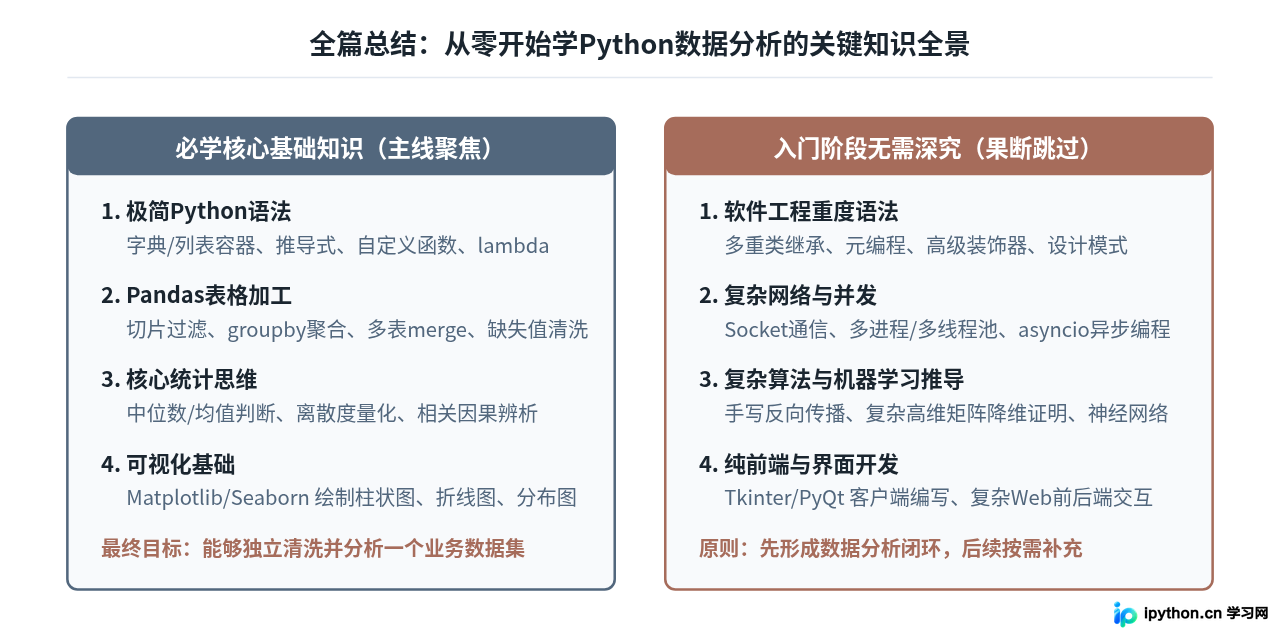
图4:学习范围取舍总结:必学核心知识与入门避坑清单
数据分析是一门强实践导向的技能。只要掌握了本文梳理的基础知识架构,就可以立即找一份真实表格开始处理,在解决具体问题的过程中不断查漏补缺,这是最高效、也最不容易半途而废的进阶方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









