

Python包导入报错排查:常见ImportError原因及sys.path分析
深入解析Python模块与包导入报错的核心机制,剖析sys.path搜索链顺序,并针对同名遮蔽、循环导入、跨目录执行及虚拟环境不匹配等典型ImportError提供系统化排查步骤与修复方案。
在 Python 开发中,ModuleNotFoundError: No module named ... 与 ImportError: cannot import name ... 是发生频率最高且最容易令人困惑的两类报错。出现这两类错误通常只对应两类本质原因:一是 Python 解释器在当前模块检索路径(sys.path)中根本定位不到目标文件;二是目标文件已被定位,但在加载执行或提取特定符号时发生了中断(例如同名遮蔽、循环依赖或局部未完成初始化)。本文将系统剖析 Python 的模块检索链与 sys.path 构成机制,并针对四种典型故障场景提供排查步骤与工程化解决方案。
一、Python模块加载机制与sys.path搜索链剖析
当执行 import my_module 或 from my_package import helper 时,Python 解释器并非盲目在硬盘全局扫描,而是遵循一套严谨的查找链路:首先检索内存已加载缓存,再匹配内置模块,最后在 sys.path 所记录的目录列表中按先后顺序线性搜索。
了解 sys.path 内部各元素的优先级顺序,是排查一切导入异常的基础。sys.path 是一个标准的 Python 列表,解释器在启动时会自动按以下顺位将其填充初始化:
- 启动入口所在目录(Index 0): 如果运行
python path/to/script.py,则sys.path[0]为该脚本所在的绝对目录;如果在交互式终端(REPL)中启动,则为当前工作目录。 - PYTHONPATH 环境变量指定的目录: 用户在操作系统中预先配置的路径集合,按环境变量声明的先后顺序插入。
- Python 标准库目录: 安装 Python 时附带的基础库路径,例如
/usr/lib/python3.x或 Windows 下对应的Lib目录。 - 第三方库目录(site-packages): 存放通过
pip安装的第三方分发包目录,通常排在检索链的尾端。
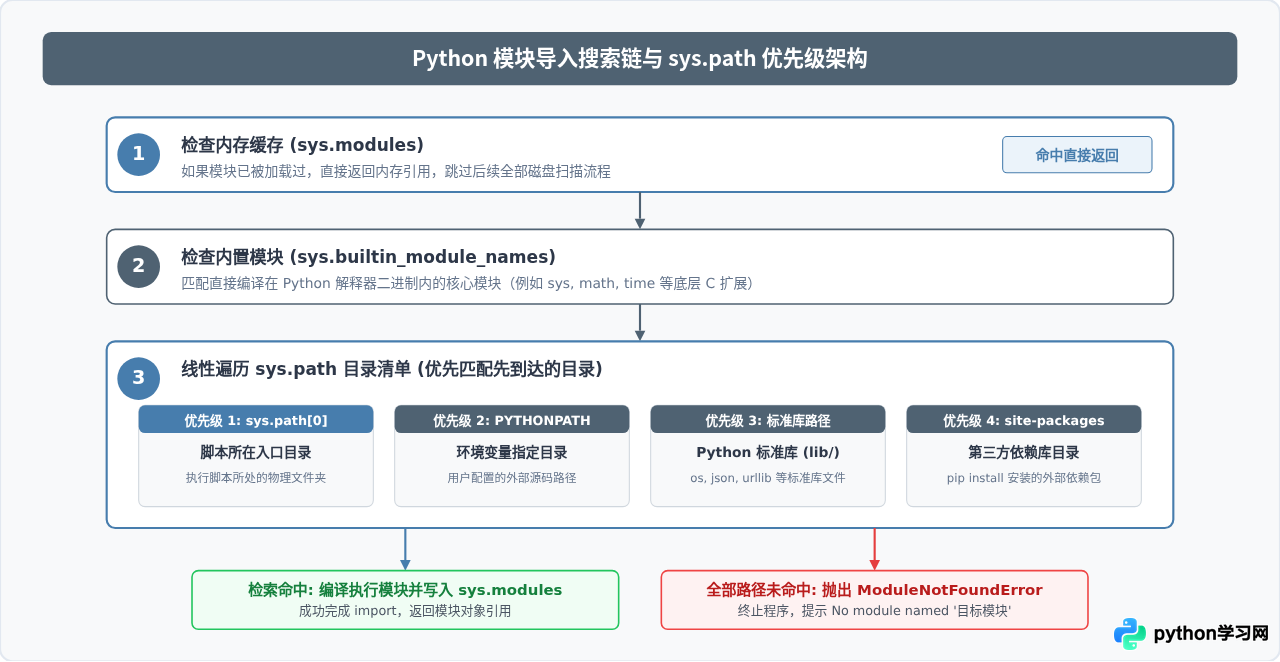
在实际代码中,可以通过以下脚本直接打印当前运行环境的 sys.path 真实列表,直观核实解释器的搜索顺序:
import sys

print("当前 Python 解释器路径:", sys.executable)
print("\nsys.path 搜索目录列表 (按优先级降序):")
for idx, path in enumerate(sys.path):
    print(f"[{idx}] {path}")
二、报错排查:标准化四步诊断流程
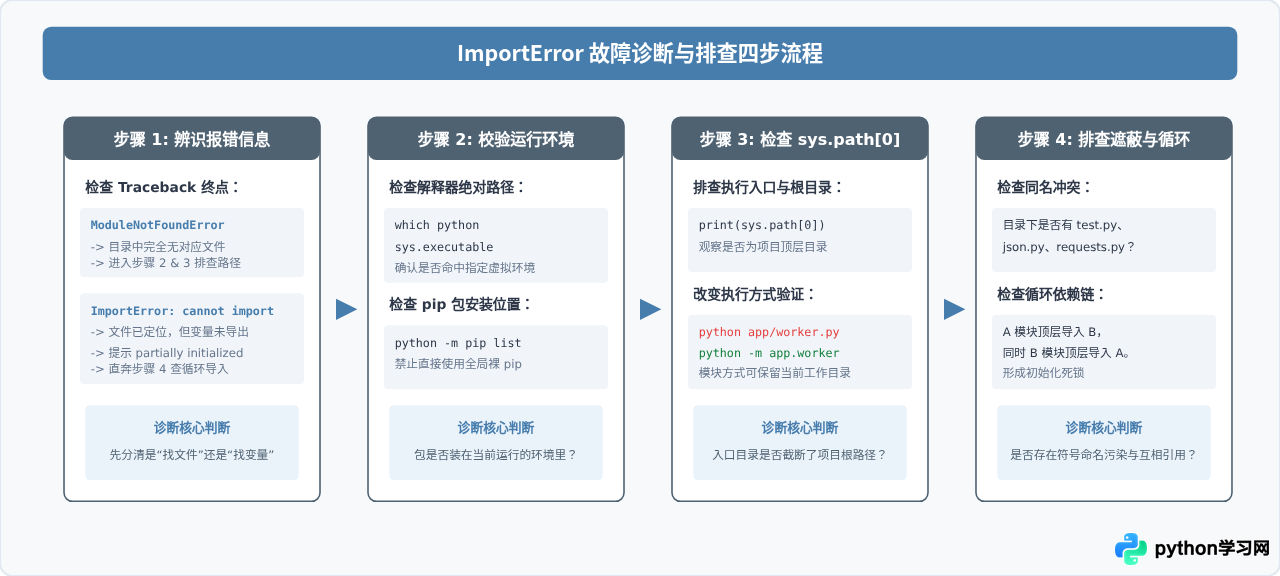
遇到导入报错时,切忌盲目随意复制网上的 sys.path.append('..')。遵循以下四步诊断法,能够在数分钟内精确锁定根因:
- 辨析报错类型: 确认控制台抛出的是
ModuleNotFoundError还是ImportError。前者说明文件根本没有在sys.path覆盖的任何目录中出现;后者说明文件找到了,但内部符号提取失败。 - 核实 Python 解释器与虚拟环境: 检查运行命令所调用的 Python 是否与
pip install所在的环境严格一致。 - 定位入口脚本与 sys.path[0]: 确认当前是以相对路径直接执行脚本,还是以模块方式(
python -m)运行。 - 排查同名遮蔽与循环依赖: 检查当前目录下是否有与系统库同名的文件,以及是否有两个文件发生了互相引入。
三、四类常见ImportError深度分析与代码案例
1. 同名文件遮蔽标准库或第三方库(Shadowing)
这是初学者最常见、排查起来也最让人费解的场景。例如在学习爬虫时,随意在工程目录下新建了一个名为 requests.py 的文件;或者测试数学函数时创建了 math.py。
当执行 import requests 时,根据 sys.path 的优先级,解释器首先在 sys.path[0](当前脚本所在目录)寻找 requests.py。解释器欣然加载了本地的空文件或测试文件,随后在执行 requests.get(...) 时报错:AttributeError: module 'requests' has no attribute 'get';若写成 from requests import get,则直接抛出 ImportError: cannot import name 'get' from 'requests'。
import requests; print(requests.__file__)。如果输出路径位于你的工程目录下,100% 发生了同名文件遮蔽。立刻重命名该本地文件并删除对应的 __pycache__ 目录。
2. 循环依赖导致部分初始化(Circular Import)
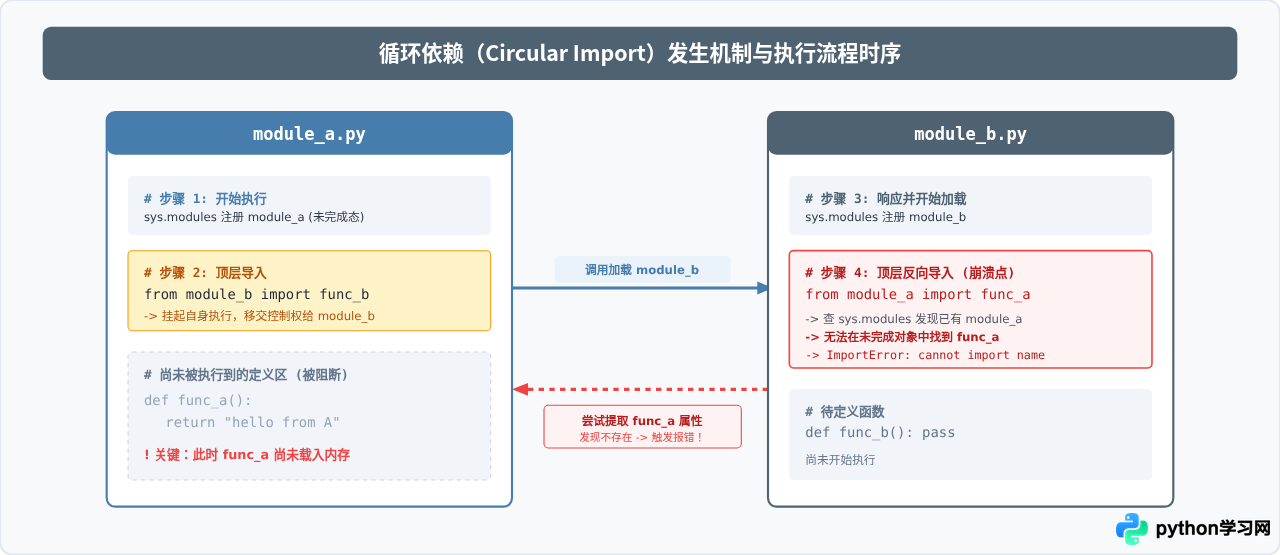
循环导入发生在两个或多个模块相互引用彼此的变量或函数时。Python 允许循环 import module,但在模块顶层使用 from a import b 时极其容易崩溃。其原因在于 Python 执行 import 时的原子机制:
- 当解释器开始加载
module_a.py时,先向sys.modules注册一个未完成初始化的空模块对象。 - 解释器按行向下执行。当读到
from module_b import func_b时,暂停module_a的执行,转去加载module_b.py。 module_b.py执行到from module_a import func_a。解释器查询sys.modules,发现module_a已经在缓存中,于是直接进入module_a提取func_a。- 但此时
module_a还停留在第二步,func_a的函数定义语句尚未被解释器读到!于是抛出核心错误:ImportError: cannot import name 'func_a' from partially initialized module 'module_a' (most likely due to a circular import)。
解决循环导入的三种方式:
- 解耦与重构(推荐): 将
func_a与func_b共同依赖的基础逻辑或数据模型抽离到第三个独立模块(例如common.py),破坏环状依赖。 - 延迟导入(Lazy Import): 将
from module_a import func_a移入具体调用该函数的函数体内,避免在顶层模块解析时立即求值。 - 导入整个模块对象而非特定函数: 使用
import module_a,并在函数内通过module_a.func_a()方式调用,这样只需加载模块引用,无需在顶层绑定属性。
3. 跨目录脚本直接执行导致包结构丢失
在具有多层级结构的项目中,常见如下目录结构:
my_project/
├── core/
│   ├── __init__.py
│   └── database.py
└── jobs/
    ├── __init__.py
    └── sync_job.py
如果在 sync_job.py 顶部编写了 from core.database import connect_db,当我们在终端切换至 jobs/ 目录下运行:
# 错误执行方式
cd jobs
python sync_job.py控制台必定报错:ModuleNotFoundError: No module named 'core'。其原因正是由于 sys.path[0] 被赋值为 my_project/jobs,解释器在该目录下只能看到 sync_job.py,根本无法探寻到同级的 core 目录。
正确解决规范:永远不要进入子目录使用脚本路径直接启动。应退回到项目根目录 my_project/,使用模块参数 -m 启动:
# 正确启动方式
cd my_project
python -m jobs.sync_job
使用 -m 标志执行时,Python 会将当前工作目录(即 my_project 根目录)设置为 sys.path[0],项目顶层的所有子包(core、jobs)均能被正确索引。
4. 虚拟环境与 IDE 解释器未对齐
很多开发者在终端执行 pip install pandas 成功,但运行脚本或在 VS Code / PyCharm 中点击运行却抛出 ModuleNotFoundError: No module named 'pandas'。这属于典型的环境错位:
- 终端中全局的
pip关联到了系统 Python(例如/usr/bin/python3)。 - IDE 运行所选用的是虚拟环境解释器(例如
.venv/bin/python),或者反之。
对齐验证方案:在终端中强制使用与运行脚本相同的 Python 二进制执行 pip 安装:
# 确保为当前虚拟环境安装
python -m pip install pandas

# 验证安装所属的实际路径
python -c "import pandas; print(pandas.__file__)"
四、工程化解决 sys.path 依赖的推荐方案
在大型多模块或微服务工程中,除了遵守模块化启动外,通常有以下标准实践来彻底免除路径烦恼:
- 方案 A:配置 PYTHONPATH 环境变量。
在开发或容器启动脚本中设置环境变量:export PYTHONPATH="${PYTHONPATH}:/path/to/my_project"。这样无论入口脚本在何处执行,sys.path中都会稳定包含项目源码根目录。 - 方案 B:使用可编辑安装模式(Editable Install,推荐)。
在工程根目录编写标准的pyproject.toml或setup.py,然后执行:pip install -e .
该命令会将当前项目作为开发态包注册到当前虚拟环境的site-packages中,代码修改实时生效,且在任何目录下均可像使用标准三方库一样任意import my_project.xxx。 - 坚决避免的做法: 在业务代码中硬编码
sys.path.append('..')或相对磁盘路径。这不仅具有极强的环境脆弱性,而且一旦部署到容器或生产流水线,就会引发严重的路径漂移失效。
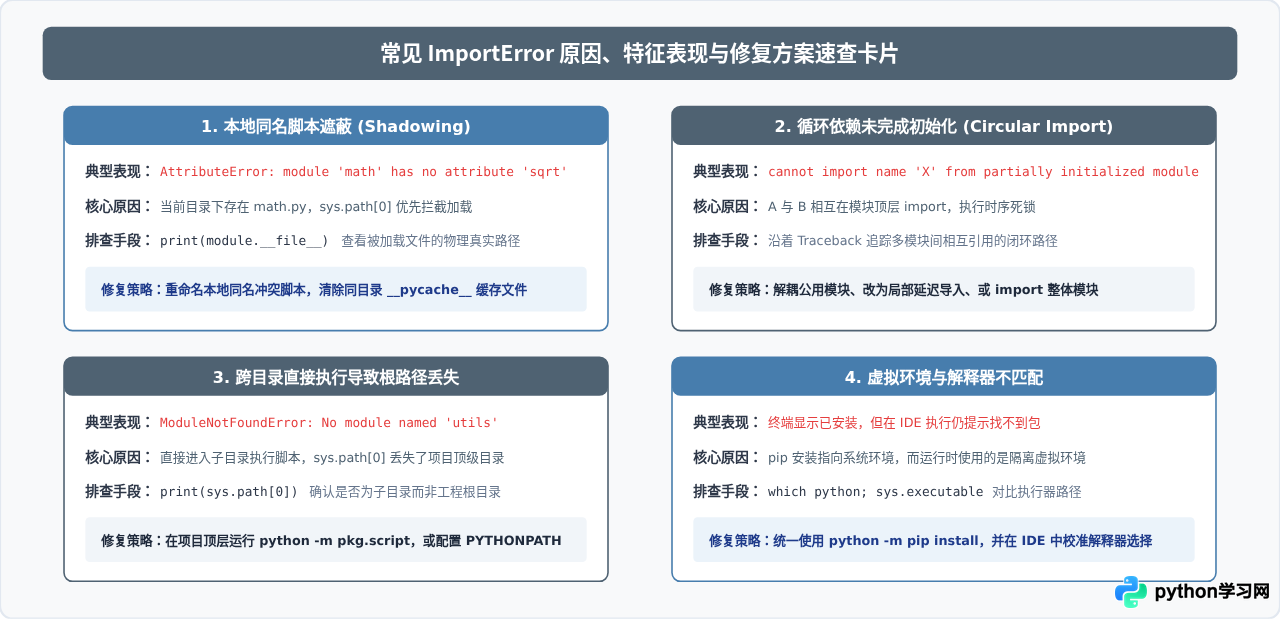
五、常见 ImportError 核心原因与修复速查
下表总结了各类导入异常的典型特征与标准应对措施,供排查时快速对比参考:
综上所述,Python 模块导入异常绝非玄学。只要掌握 sys.path 的判定优先级与模块生命周期,沿着“报错定位 → 解释器环境核验 → 搜索根路径对齐 → 符号冲突与死锁排查”的逻辑链条逐步分析,即可迅速彻底地解决各类包导入故障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









