

Python学到什么程度能找工作?Web、数据与自动化岗位的技能清单
全面梳理Python在Web开发、数据分析与自动化测试运维三大主流方向的求职技能标准,提供切实可行的技能清单、作品集要求与求职自测指南。
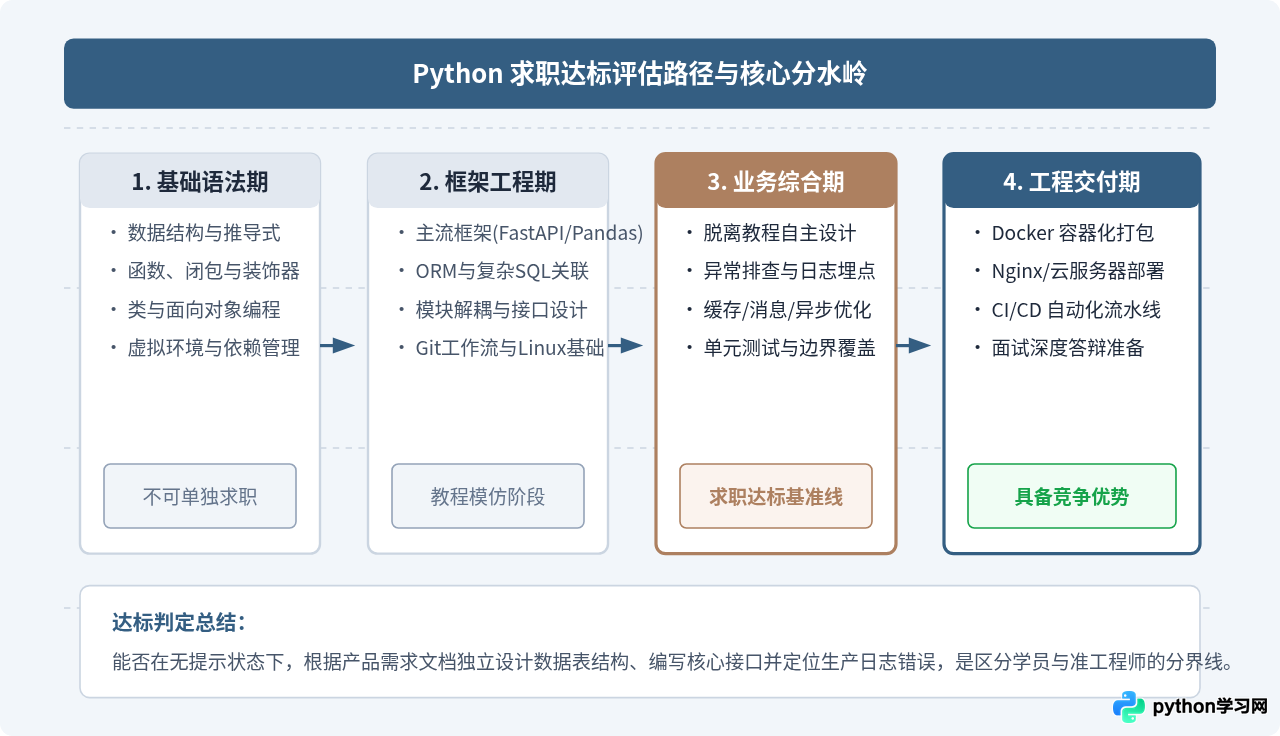
判断Python是否学到可以求职的水平,核心不在于记住了多少语法条目,而在于能否脱离配套教程,独立利用Python解决具体岗位的工程问题,并交付符合团队规范的完整作品。初学者容易陷入“看完语法就能投简历”或“必须精通所有底层源码才能面试”的两个极端。实际上,招聘市场看重的是候选人在明确业务场景下的工程化落地能力。
一、通用基础底线:所有岗位的公共技术基石
无论后续选择哪一个发展分支,企业在考察初级Python开发者时,都会默认候选人具备扎实的语言基础和标准协作习惯。这一阶段需要达到的标准是:能够熟练组织代码结构,处理常见错误,并在团队版本控制流程中正常协作。
- 语言核心机制:熟练掌握列表、字典、集合的高效操作与内存推导式;理解函数闭包、装饰器(Decorator)的工作原理;掌握生成器(Generator)与迭代器处理海量数据的场景;熟练使用面向对象编程(类、继承、魔法方法);理解异常处理层级与自定义异常设计。
- 工程与包管理:熟练使用
venv或uv建立隔离的虚拟环境;掌握pip及依赖锁定文件(requirements.txt或pyproject.toml);清楚模块导入路径机制(sys.path与PYTHONPATH)。 - 协同与底层环境:熟练使用 Git 进行分支管理、Commit 规范编写与冲突解决;掌握基础 Linux 常用命令(文件权限、进程查看、日志检索与环境变量设置);掌握基础 SQL 增删改查操作与事务概念。
二、Web后端开发岗位:技能清单与工程标准
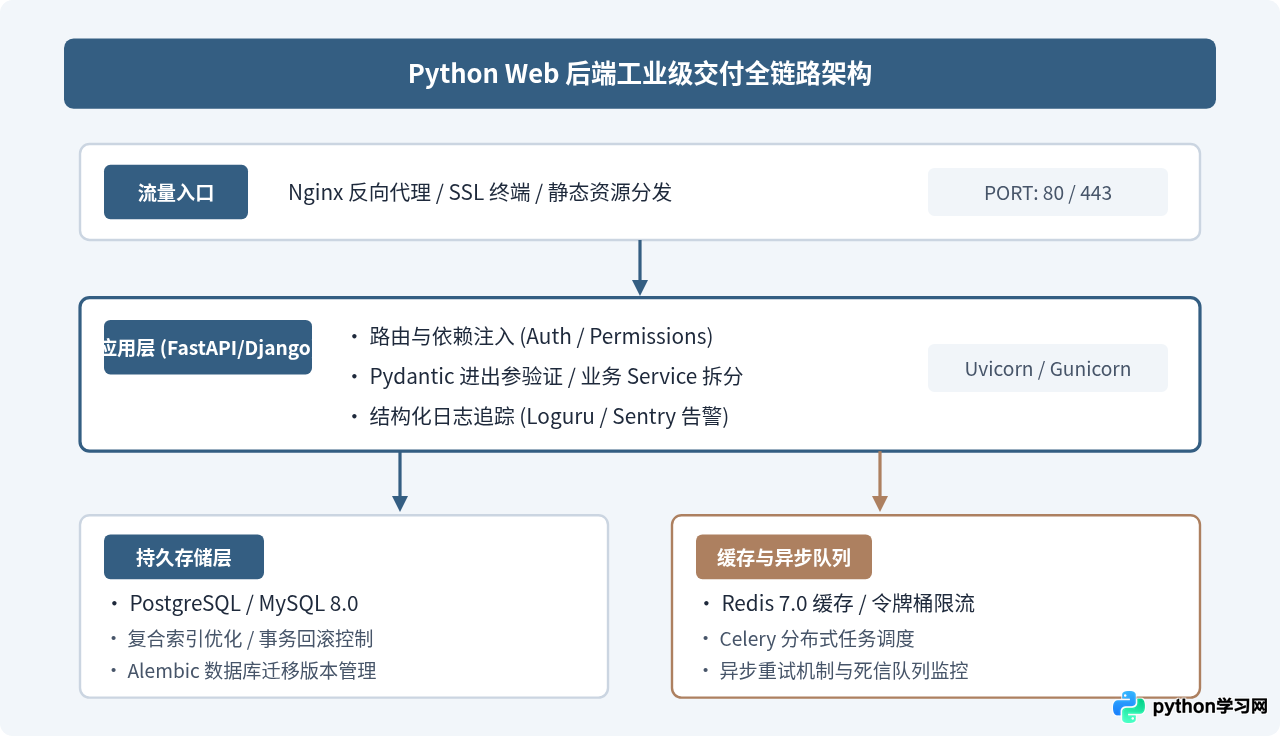
Python 在 Web 领域主要用于服务端 API 架构、微服务以及中后台系统建设。当前市场中,现代异步框架 FastAPI 与成熟大而全的 Django 占主流,轻量级的 Flask 多用于内部工具或微型服务。
1. 核心技术栈清单
- Web 框架:精通至少一款主流框架。若以 FastAPI 为主,需深刻理解基于类型提示(Type Hints)的 Pydantic 数据验证机制、Dependency Injection(依赖注入)以及 ASGI 异步事件循环;若以 Django 为主,需掌握其 MTV 模式、内置 Admin 高度定制、中间件(Middleware)与信号机制(Signals)。
- 数据持久层:熟练使用 ORM(SQLAlchemy 2.0+ 或 Django ORM),重点在于写出无 N+1 查询问题的代码(合理使用
joinedload、selectinload或select_related/prefetch_related);理解数据库事务隔离级别,能编写原生复杂 SQL 完成聚合统计并分析 Explain 执行计划。 - 安全与鉴权:理解无状态鉴权原理,熟练实现 JWT(JSON Web Token)的颁发、验证、刷新机制;掌握基于角色的访问控制(RBAC);掌握密码哈希加盐存储(Argon2 / Bcrypt)及防重放机制。
- 缓存与异步任务:熟练使用 Redis 实现接口热点数据缓存、分布式锁以及计数器;掌握使用 Celery 或 ARQ 处理耗时任务(如邮件发送、长耗时报表计算、数据导入导出)。
2. 简历项目验收标准
写在简历上的 Web 项目,不能仅仅是博客系统或未加修改的电商 Demo。一个能够支撑面试的 Web 项目应当满足以下要求:
- 具备完整的在线运行演示地址(Deploy on Cloud/VPS)和开放的 GitHub 仓库,代码目录符合工业规范。
- 包含清晰的接口文档(Swagger/OpenAPI)与数据库 E-R 关系图。
- 包含自动化测试(
pytest覆盖核心业务分支,测试覆盖率达到 60% 以上)。 - 使用 Dockerfile 和 docker-compose 完成应用、PostgreSQL、Redis 的一键部署。
三、数据分析与数据开发岗位:技能清单与业务标准
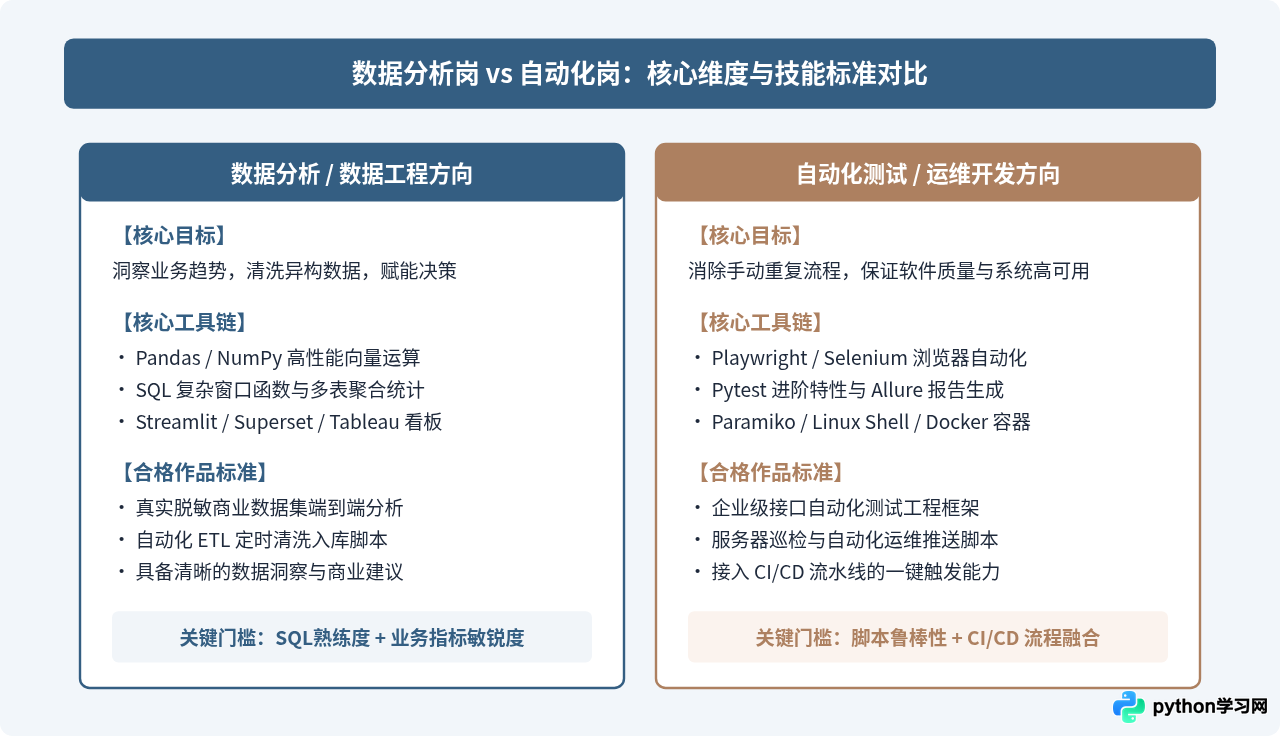
纯粹的初级“数据分析师”岗位对业务理解和 SQL 的要求往往高于 Python 本身。因此,以 Python 为求职核心的候选人,应当向“数据工程化分析”或“自动化数据管道构建”靠拢,突出代码清洗海量复杂数据及自动化交付的能力。
1. 核心技术栈清单
- 数据清洗与计算(Pandas / NumPy):熟练掌握各种数据格式(CSV、Excel、JSON、Parquet)的高效读写;掌握
merge、join、concat的对齐与合并细节;熟练运用groupby、pivot_table及向量化运算(避免低效的for循环迭代);掌握缺失值插补、异常值清洗与时间序列重采样处理。 - SQL 高级运用:在大多数企业中,SQL 是获取数据的第一门槛。求职者必须掌握窗口函数(
ROW_NUMBER()、RANK()、LEAD()、LAG())、CTE 通用表表达式,以及针对数千万行数据时的索引过滤常识。 - 自动化数据获取与管道:熟练使用
httpx、BeautifulSoup或无头浏览器获取外部公开数据源;掌握基础 ETL 逻辑,能编写定时脚本抽取数据、转换格式并清洗入库。 - 可视化与报告交互:掌握 Matplotlib、Seaborn 输出规范的探索性数据图表;或使用 Streamlit / Plotly 构建交互式数据大屏,让非技术业务人员能够自助过滤和查询数据指标。
2. 数据岗位作品集核心要求
避坑提醒:不要在 GitHub 或简历中放“鸢尾花分类”或“泰坦尼克号生存预测”这类公开竞赛玩具数据集。HR 和技术负责人对此早已产生审美疲劳。
真正具备说服力的作品应该是:针对某个具体真实商业场景(如某品类电商销量分析、行业薪资分布爬取与建模、用户流失归因分析),从采集脱敏数据开始,展现数据清洗逻辑,输出含业务洞察结论的 PDF 报告或自动化看板,并附带可一键复现结果的 Jupyter Notebook 和清晰工程脚本。
四、自动化脚本与测试/运维岗位:技能清单与工具标准
自动化方向是 Python 就业中需求非常稳定的一个分支,涵盖自动化测试工程师(SDET)、自动化运维开发以及 RPA(流程自动化)工程师。这类岗位的核心诉求是:通过可靠的代码替代繁琐的重复性人工操作,并保障系统稳定。
1. 核心技术栈清单
- Web 与界面自动化:优先掌握现代自动化框架 Playwright(或熟练使用 Selenium 4.x)。需掌握动态元素定位(XPath / CSS Selector)、显式等待机制(Explicit Wait)、网络请求拦截(Network Interception)以及多标签页和 Frame 穿透。
- 接口与测试工程化:精通 pytest 框架;熟练使用 Fixture 进行测试夹具管理,掌握
parametrize参数化测试、Mock 打桩技术;掌握生成 Allure 测试报告并集成到 CI/CD 流水线中。 - 系统与设备自动化:掌握操作系统底层交互(
subprocess、psutil、os/sys);掌握网络设备或服务器批量管理库(如paramiko/fabric/netmiko实现 SSH 远程批量执行与文件同步);掌握异步并发执行(asyncio或多进程池multiprocessing)。 - 调度与报警通道:掌握定时任务调度(Linux Crontab 或
APScheduler);具备完整的异常捕获机制,在脚本崩溃或测试未通过时,能够自动通过企业微信、钉钉机器人 Webhook 或邮件发出告警详情。
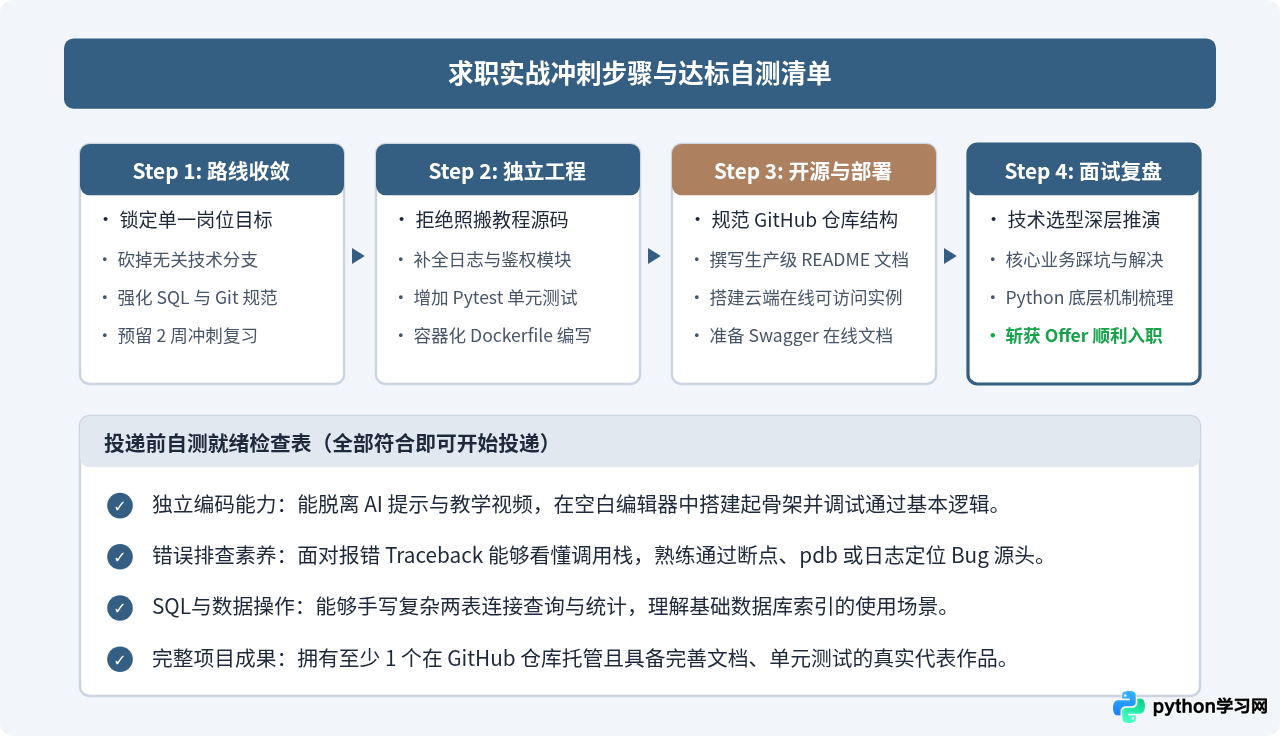
五、从学完到拿Offer的求职准备四步法
掌握了对应的技术栈之后,如何把个人能力通过简历和面试真实传达给雇主?建议严格按照以下四个步骤推进落地。
- 聚焦单一通道,坚决拒绝大而全:初学者切忌在简历中写“精通 Web、精通爬虫、精通数据分析、了解深度学习”。招聘市场更倾向于在某一个领域基础扎实、能够迅速接手业务的候选人。选定 Web、数据或自动化其中一条主线,将 80% 的精力投入该主线。
- 沉淀商业级作品集:脱离教程示例,自主编写一个满足工业规范的实战项目。项目不仅需要跑通核心业务流程,还需具备完整的单元测试、错误处理、环境配置和结构化日志。
- 代码开源与规范交付:将项目开源至 GitHub 或 Gitee,书写标准的
README.md,包含项目架构图、快速启动指令、接口说明和技术难点总结。有条件的 Web 开发者应将项目部署至云服务器并开放测试账号。 - 复盘高频工程考点:提前对项目中使用的技术选型进行灵魂自问:例如“为什么选 FastAPI 而不是 Flask”、“ORM 为什么会出现 N+1 查询,你是如何定位并优化的”、“Redis 缓存穿透与击穿的处理方案”。能讲清技术取舍的原因,是初级开发脱颖而出的关键。
六、总结
判断 Python 学习是否达到找工作的程度,从来不是对比“刷了多少道题”或“看了几百集视频”,而是衡量你在对应业务场景下的工程自主交付能力。当你在没有手把手指导的情况下,能够面对一份需求梳理出模块设计,查阅官方文档调用第三方库,排查解决出现的异常,并把代码干净、规范地交付上线时,你就已经达到了企业初级岗位的要求,完全可以自信地迈出求职投递的第一步。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









