

想从事数据分析或Web开发,Python该怎么侧重学习
针对想从事数据分析或Web开发方向的Python初学者,详细解析两者共同的基础底座、各自截然不同的技术栈核心、学习路径对比以及如何根据自身背景做出实际选择。
很多初学Python的人常陷入一种误区:以为把语法书从头翻到尾,就能自然胜任数据分析或网站开发。事实上,Python在两个领域所解决的问题本质完全不同。数据分析关注的是“静态或批量数据的提取、清洗、统计建模与价值解读”,核心在数据流动与数学逻辑;Web开发关注的是“并发请求响应、状态保持、持久化存储与系统稳定性”,核心在工程架构与网络通信。明确了目标岗位的核心关注点,基础阶段之后的学习侧重点就必须彻底分道扬镳。
一、共同的地基:哪些Python核心知识不可跳过
无论最终走向哪条分支,Python语言本身有一套不可或缺的公共底座。这部分内容不必贪多求全,但必须建立扎实的工程理解:
- 核心数据结构操作:熟练掌握列表(List)、字典(Dict)、集合(Set)与元组(Tuple)的操作。尤其是列表推导式、字典遍历以及如何利用哈希结构实现高效检索。
- 函数与作用域:理解参数传递机制(位置参数、关键字参数、*args与**kwargs)、变量作用域(LEGB规则)以及闭包与高阶函数的直观用法。
- 文件与异常处理:掌握
with open(...)上下文管理器、UTF-8编码处理,以及try...except...finally健壮性设计。 - 模块与包管理:理解
import查找机制、虚拟环境(venv)的隔离原理以及pip依赖管理。
在这个阶段,不要过早钻研元编程、底层C扩展或者复杂的GUI开发(如Tkinter/PyQt),这些对数据分析或Web后端开发几乎没有直接收益。
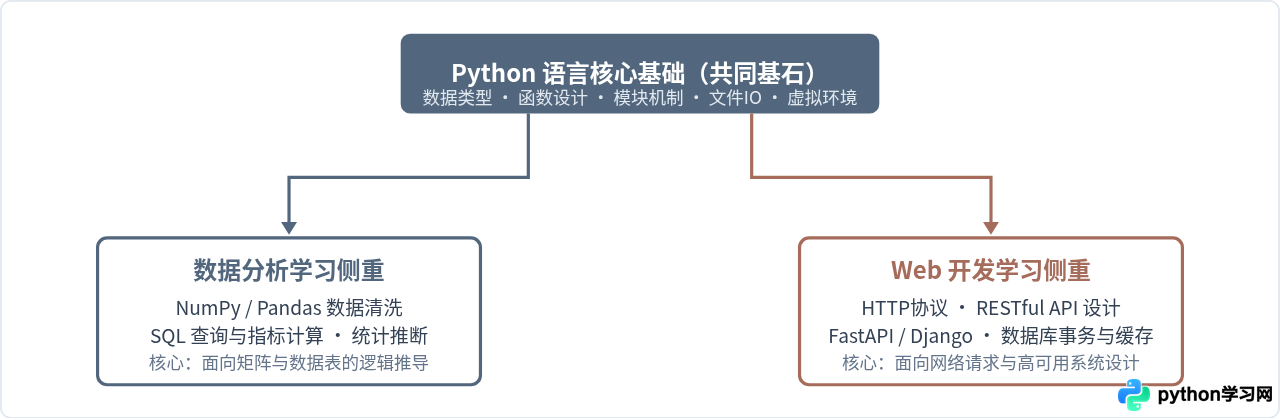
二、选择数据分析:应该如何构建技术侧重点
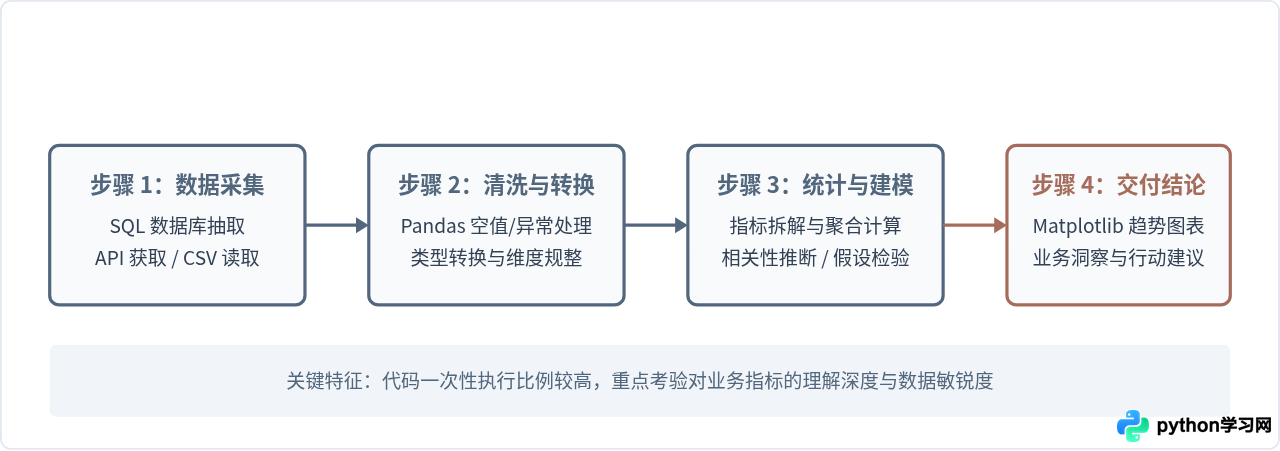
数据分析的核心工作是“从杂乱无章的数据中提取确定性事实”。日常工作中绝大部分时间并非在跑复杂的机器学习算法,而是在清洗异常值、关联维度表、计算业务指标与制作可视化报告。因此,学习侧重应当集中在以下四个层级:
1. 核心库攻坚:从单机表格到向量化计算
初学者容易用for循环去逐行遍历百万行的数据,这在实际工作中往往导致程序跑十几分钟甚至内存崩溃。必须建立“向量化计算”思维:
- NumPy:理解多维数组(ndarray)、广播机制(Broadcasting)与基础线性代数计算。
- Pandas:数据分析的核心武器。必须深入掌握
DataFrame的缺失值填充、分组聚合(groupby)、多表连接(merge、join)与透视变换(pivot_table)。
# 示例:Pandas 常见的数据清洗与业务聚合示例
import pandas as pd

# 读取订单数据
df = pd.read_csv("orders.csv")

# 1. 过滤无效状态并填补缺失金额
clean_df = df[df["status"] != "cancelled"].copy()
clean_df["amount"] = clean_df["amount"].fillna(0.0)

# 2. 统计各城市平均客单价与总销售额
summary = clean_df.groupby("city").agg(
    total_sales=("amount", "sum"),
    avg_ticket=("amount", "mean"),
    order_count=("order_id", "count")
).reset_index()

print("示例输出:聚合分析结果前两行:")
print(summary.head(2))
2. 强化 SQL 能力而不是仅依赖 Python
在企业生产环境中,海量数据存储在数仓(Hive、ClickHouse)或关系型数据库(MySQL、PostgreSQL)中。先用SQL在数据库中完成第一轮粗过滤和聚合,再拉入Python做精细化统计,是行业标准操作。只懂Pandas不懂SQL,在面试和实际工作中会处处受限。
3. 数据可视化与指标推导思维
掌握Matplotlib和Seaborn的基本语法,能够绘制折线图、柱状图、箱线图与散点图。但更关键的是理解图表背后的业务问题:分布是否偏斜?是否存在周期性波动?掌握基本的描述统计学(均值、中位数、分位数、标准差)和假设检验概念,避免得出“伪相关”结论。
三、选择Web开发:应该如何构建技术侧重点
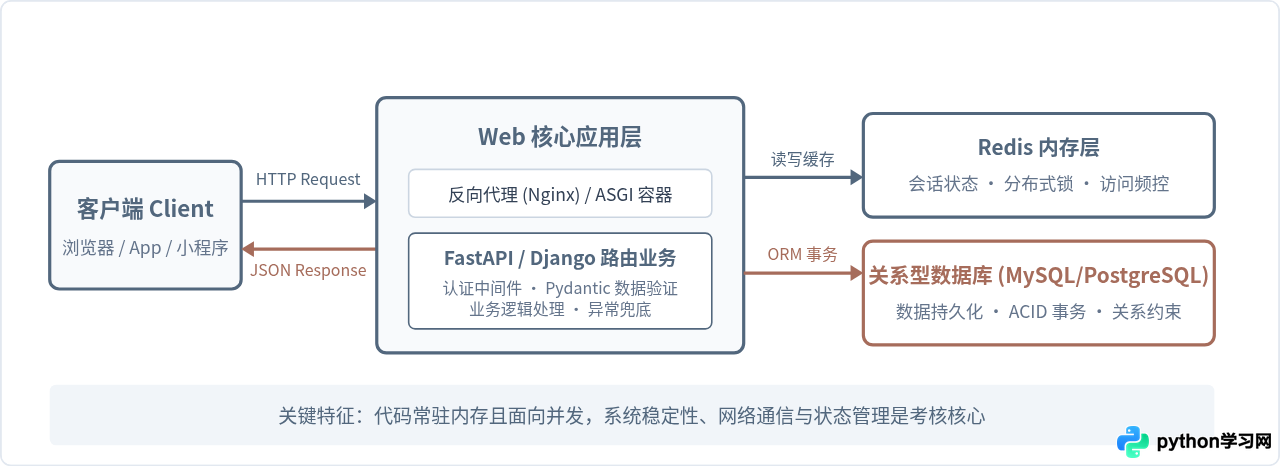
Web开发属于软件工程分支。你的代码不再是本地Jupyter Notebook里按Shift+Enter跑完就结束的脚本,而是需要7x24小时常驻内存、时刻准备迎接成千上万外部并发请求的生产系统。因此,必须将重点转向工程架构与网络底层:
1. 理解网络协议与后端核心概念
- HTTP/HTTPS协议:明确请求方法(GET、POST、PUT、DELETE)、状态码(200、301、400、401、403、500)、请求头与响应体、Cookie与Session、Token验证机制。
- RESTful API 设计规范:掌握如何设计清晰、解耦的接口路由,以及JSON格式的输入校验。
2. 框架选型与实战:Django 与 FastAPI 的取舍
现代Python Web开发主流框架主要集中在两个方向:
- Django:适合想要快速构建完整后台、对权限管理要求高、需要现成ORM的企业中后台项目。它的“全包式”(Batteries Included)设计能让你迅速理解MVC/MVT模式。
- FastAPI:基于异步IO(
asyncio)与类型注解(Pydantic),适合构建轻量微服务、高性能API以及前后端分离项目。学习FastAPI时,必须弄懂异步编程(async/await)以及事件循环机制。
# 示例:FastAPI 声明式接口与异步处理
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户注册服务示例")

class UserRegister(BaseModel):
    username: str = Field(..., min_length=3, max_length=20)
    email: str

@app.post("/api/v1/users", status_code=201)
async def create_user(payload: UserRegister):
    # 模拟数据持久化前校验
    if payload.username == "admin":
        raise HTTPException(status_code=400, detail="用户名已被系统保留")
    return {"message": "用户创建成功", "user": payload.username}
3. 数据库与持久化:从原生SQL到ORM与事务
与数据分析只要SELECT查询不同,Web开发需要频繁处理INSERT、UPDATE以及高并发下的并发冲突。必须理解:
- 数据库事务(ACID):转账、下单场景下的一致性保障。
- ORM映射(SQLAlchemy或Django ORM):模型定义、外键关联、N+1查询问题排查。
- Redis缓存与会话存储:缓解数据库读写压力,处理热点数据。
四、对比与权衡:两条路径的根本差异
为了直观帮助你在学习时间分配上做出权衡,我们可以从日常产出物、核心心智模型与学习重点进行横向对比:
| 对比维度 | 数据分析 (Data Analysis) | Web后端开发 (Web Backend) |
|---|---|---|
| 日常核心产出 | 数据分析报告、SQL报表、业务复盘看板、预测模型 | 稳定的HTTP/RPC接口、后台管理系统、微服务应用 |
| 代码运行环境 | Jupyter Notebook、离线执行脚本、批处理任务调度 | 服务器常驻进程(Gunicorn/Uvicorn)、Docker容器集群 |
| 核心学习心智 | “数据变形与指标解释”:缺失值怎么补?指标下滑原因? | “请求流转与边界安全”:参数是否注入?并发怎么锁? |
| 数据库关注点 | 复杂聚合查询、窗口函数、OLAP列存、多维联查 | CRUD性能、B+树索引优化、高并发锁机制、事务回滚 |
| 协同伙伴 | 业务运营、产品经理、管理层决策者 | 前端工程师、移动端开发、运维测试人员 |
五、如何做出选择并落地执行
学习侧重的选择,本质上由你的个人背景和职业偏好决定:
- 建议选择数据分析的读者:如果你具备较好的商业敏感度、沟通能力,或者本来就有财务、统计、市场、管理等专业背景。数据分析技术能够迅速为你原有的业务能力赋能,不需要过早陷入复杂的计算机底层运维。
- 建议选择Web开发的读者:如果你对软件构建感兴趣,喜欢看到自己编写的代码变成可交互的网页或API产品,对计算机网络、系统安全、并发性能充满好奇,且未来规划向全栈工程师或基础架构方向演进。
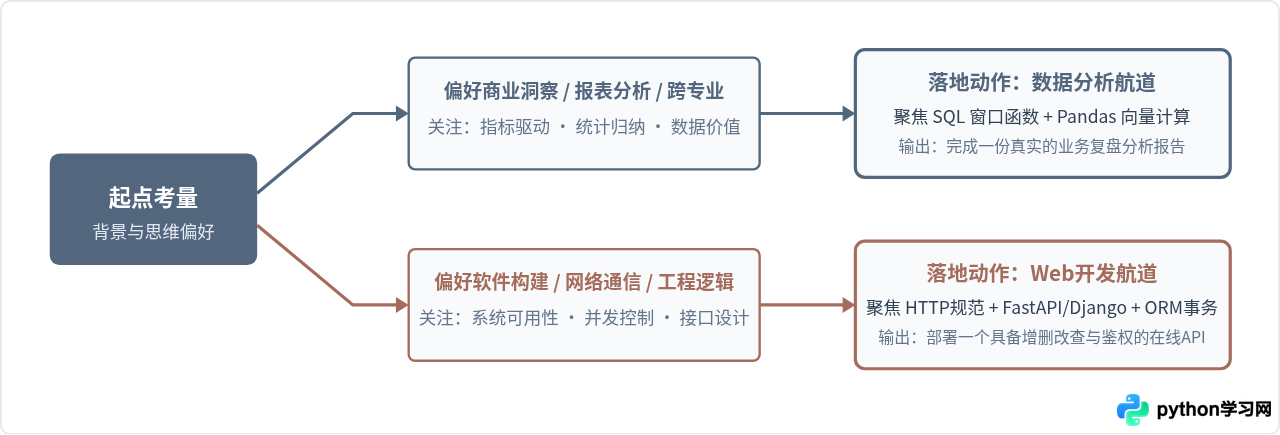
无论最终决定侧重哪个方向,检验学习成效的唯一标准都不是“刷了多少章节视频”,而是“独立完成了怎样的闭环产出”。对于数据分析,拿一份公开的真实数据集(如电商订单、共享单车骑行记录),独立完成清洗、指标计算并给出结论;对于Web开发,从零写一个包含用户注册、登录验证、数据持久化与RESTful API接口的完整项目并部署上线。在完整闭环的训练中,技术侧重点才会真正沉淀为你个人的专业能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









