

Python批量截取字符串列表中的指定部分
一、基于固定位置与长度的切片截取
当列表中所有字符串的格式高度规范(例如固定长度的工号、日期编码、日志时间戳等)时,直接使用 Python 的切片语法 [start:stop:step] 是速度最快且最简练的方案。
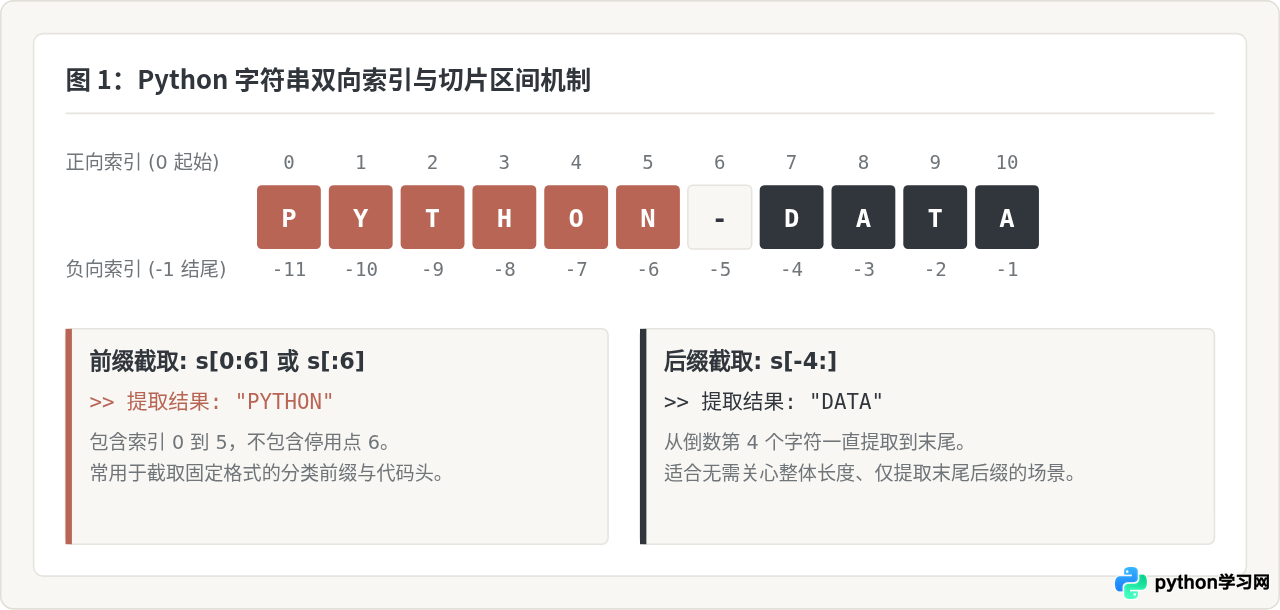
1. 切片的核心语法与索引规则
Python 字符串支持正向索引(从 0 开始递增)与负向索引(从 -1 开始从尾部倒数)。切片采用“左闭右开”原则,即包含起始索引 start 对应的字符,但不包含结束索引 stop 对应的字符。
2. 列表推导式批量执行
借助列表推导式,我们可以将单个字符串的切片逻辑一次性应用到整个列表上:
# 原始字符串列表
records = [
    "2026-03-ORDER-001",
    "2026-03-ORDER-002",
    "2026-03-ORDER-003",
    "2026-03-ORDER-099"
]

# 1. 批量提取前4个字符(年份)
years = [item[:4] for item in records]
# 示例输出: ['2026', '2026', '2026', '2026']

# 2. 批量提取中间的月份(索引 5 到 7)
months = [item[5:7] for item in records]
# 示例输出: ['03', '03', '03', '03']

# 3. 批量提取末尾的编号(最后 3 位)
order_ids = [item[-3:] for item in records]
# 示例输出: ['001', '002', '003', '099']s[10])如果索引超出范围,会立即引发 IndexError;但是切片操作具有容错机制,即使 stop 超过了字符串实际长度,Python 也不会抛出异常,而是优雅地截取到字符串末尾。例如 "abc"[0:10] 仍会安全返回 "abc"。
二、批量处理流水线与数据清洗
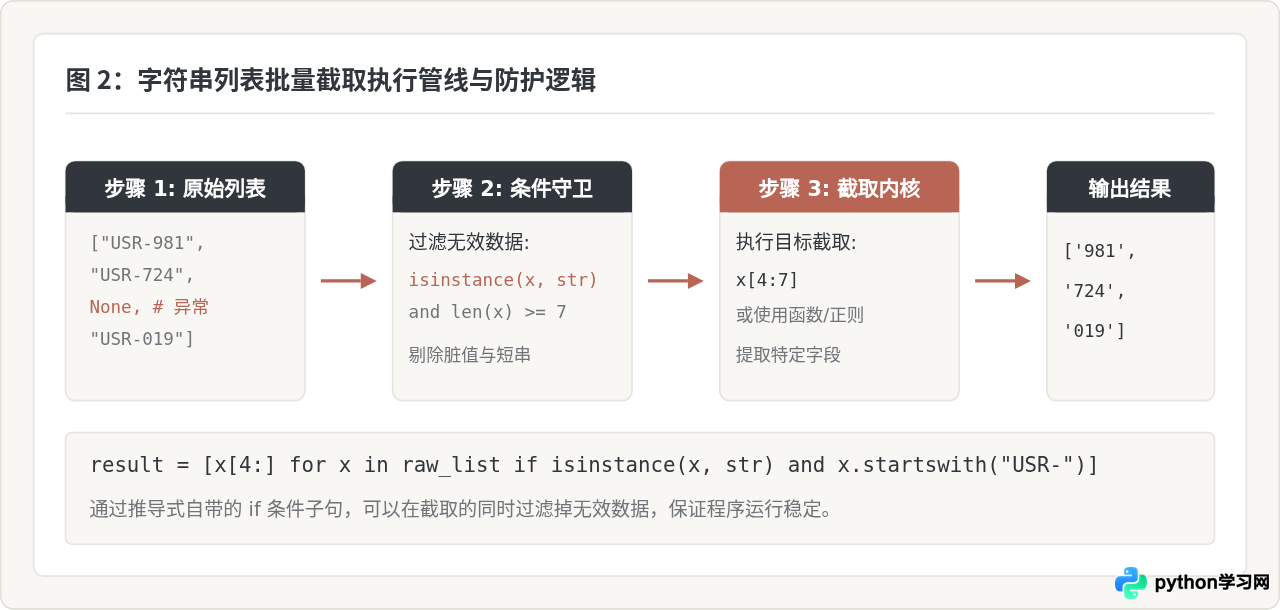
在真实业务场景中,列表往往混杂有空字符串、None 或是异常数据。一个健壮的批量截取操作应当包含输入校验、目标截取和清洗过滤三个阶段。
三、基于特定分隔符的批量截取(split 与 partition)
当需要截取的部分不是固定长度,而是由某种符号(如斜杠、横杠、下划线、逗号)隔开时,位置切片就不再适用,此时应当使用基于字符标记的方法。
1. 使用 split() 进行切分与索引提取
str.split(sep, maxsplit) 是最常用的拆分方法。结合列表推导式,我们可以提取第指定段的内容:
file_paths = [
    "data/v1/users.csv",
    "data/v2/products.json",
    "backup/v3/logs.txt"
]

# 批量提取文件名(最后一个路径节点)
filenames = [path.split("/")[-1] for path in file_paths]
# 示例输出: ['users.csv', 'products.json', 'logs.txt']

# 批量提取文件纯后缀(不带点)
extensions = [path.split(".")[-1] for path in file_paths]
# 示例输出: ['csv', 'json', 'txt']
如果只需要提取前两部分,建议传入 maxsplit 参数以减少不必要的分割开销,例如 item.split("-", 1)。
2. 使用 partition() 进行确定性三元截取
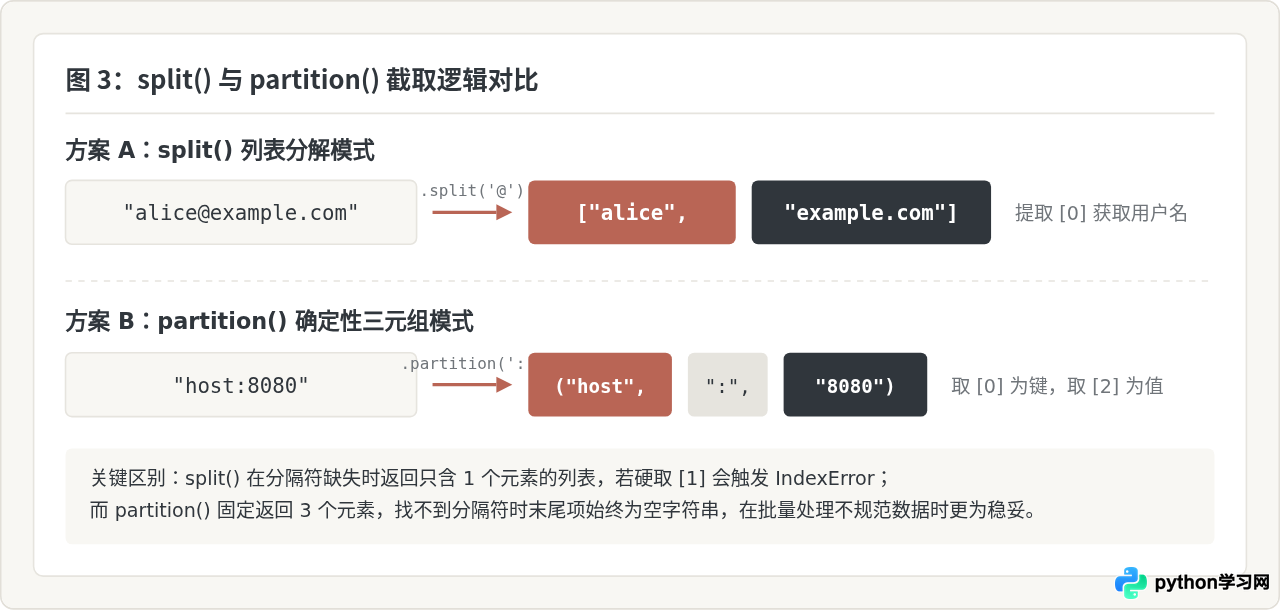
str.partition(sep) 会根据首次出现的分隔符,将字符串拆分成 (head, sep, tail) 的三元组。它有两个显著特点:
- 无论是否存在分隔符,始终返回包含 3 个元素的元组,绝对不会因为解包数量不匹配抛出异常。
- 如果找不到分隔符,
head为原字符串本身,sep和tail为空字符串。
raw_configs = [
    "timeout:30",
    "retries:3",
    "debug_mode",   # 没有冒号的异常项
    "port:8080"
]

# 安全提取冒号后的值:如果无冒号,[2] 为空字符串
config_values = [item.partition(":")[2] for item in raw_configs]
# 示例输出: ['30', '3', '', '8080']
四、基于正则表达式的动态模式匹配
当截取目标不具备固定位置,也没有固定分隔符,而是符合某种特定模式(例如带字母前缀的连续数字、括号内的说明文本等)时,Python 标准库的 re 模块是最强有力的工具。
1. 批量正则捕获组提取
为了保证批量处理时的性能,建议先使用 re.compile() 预编译正则表达式,避免每次循环重复解析正则语法树:
import re

text_items = [
    "交易流水号: TX-202601-A9 (已确认)",
    "流水号 TX-202602-B3 状态异常",
    "无效备注无单号",
    "单据 TX-202603-C7 待复核"
]

# 编译正则表达式,使用括号 () 设定捕获组
pattern = re.compile(r"TX-\d{6}-[A-Z0-9]+")

# 批量提取匹配项,若无匹配项则返回 None 或默认占位
def extract_tx_id(text):
    match = pattern.search(text)
    return match.group(0) if match else "N/A"

extracted_ids = [extract_tx_id(s) for s in text_items]
# 示例输出: ['TX-202601-A9', 'TX-202602-B3', 'N/A', 'TX-202603-C7']
五、方法选型决策与性能考量
在实际工程开发中,面对不同规模的数据集和不同的字符串规范度,选择正确的截取工具能够兼顾代码可读性与执行效率。
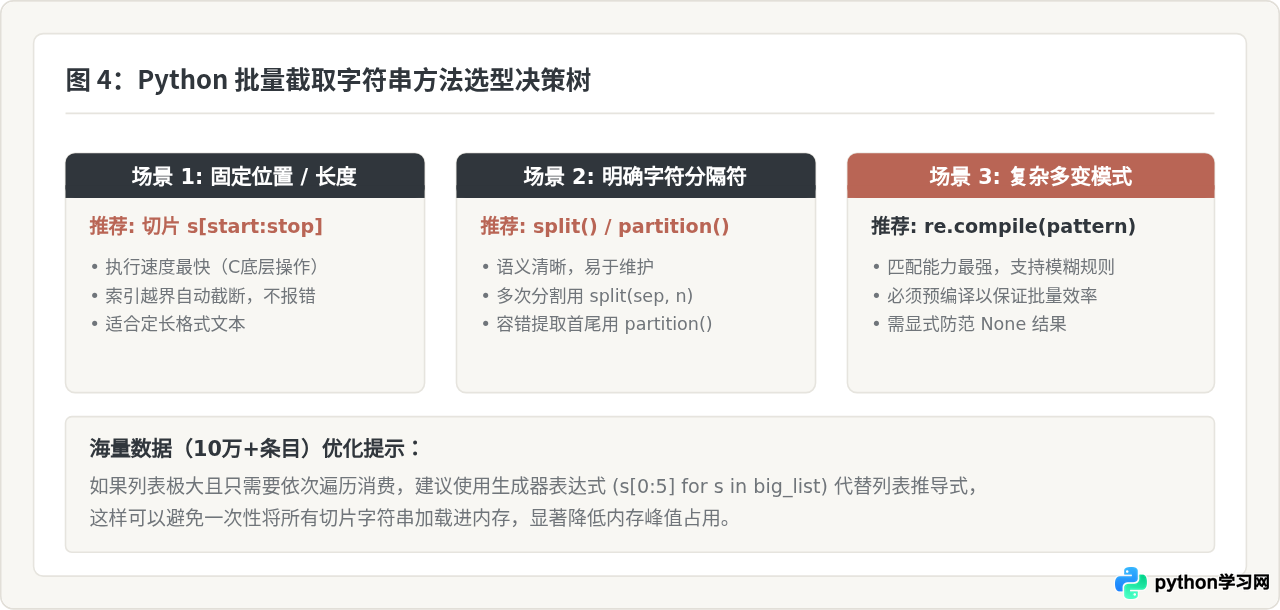
方法性能与特性对比
| 方法 | 适用条件 | 执行效率 | 越界/异常特征 |
|---|---|---|---|
切片 s[start:stop] |
位置与长度固定 | 极高(C原生) | 自动截断,不抛出异常 |
分割 s.split() |
存在清晰且一致的分隔符 | 高 | 取不存在的索引会触发 IndexError |
三元提取 s.partition() |
提取首次出现的分隔符两侧 | 高 | 固定返回长度为3的元组,极难出错 |
正则 re.search() |
结构动态、需按字符类型识别 | 中等(需预编译) | 未匹配返回 None,需防范 AttributeError |
partition(),在模式多变时善用预编译正则;同时结合 if isinstance(s, str) 守卫子句,即可构建出既快速又稳健的字符串批量处理逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









