

Python Web开发中正则表达式的路由匹配与URL解析

在 Python Web 应用中,路由系统的核心职责是将 HTTP 请求中的路径(URL Path)精准映射到对应的视图处理器(View Handler),并提取出路径中携带的业务参数。正则表达式路由通过字符串模式定义路径规则,并利用命名捕获组(Named Capture Groups)实现动态参数解析,为复杂或历史系统的 URL 设计提供了高度灵活且严密的控制能力。
一、URL 正则路由的工作原理与执行链路
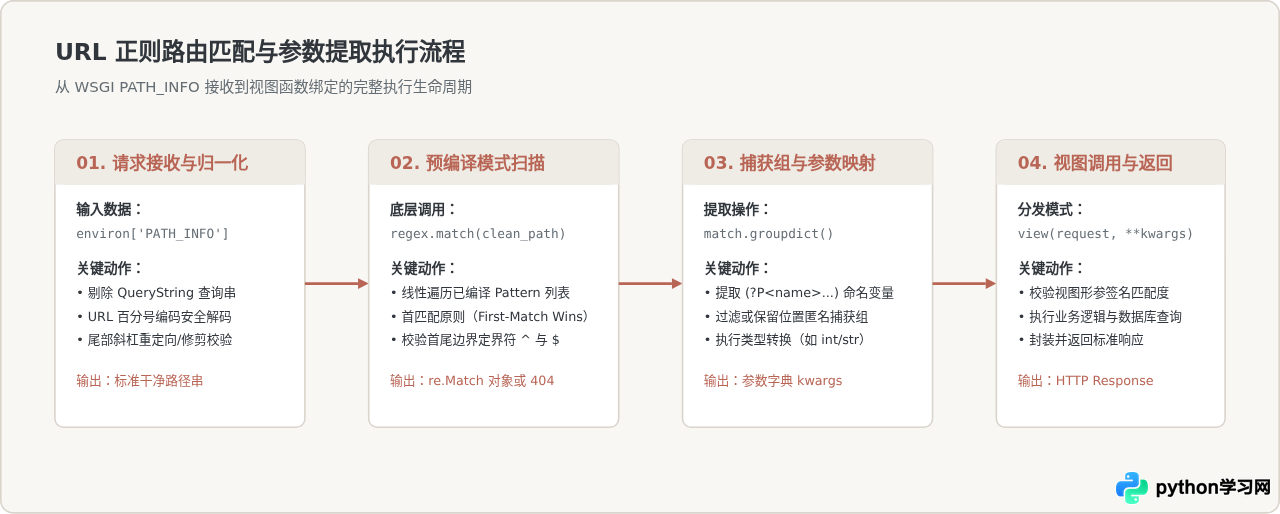
Web 服务器(如 Gunicorn 或 uWSGI)在接收到客户端发起的 HTTP 请求后,会依照 WSGI/ASGI 规范将请求的环境字典(包含 PATH_INFO)传递给 Web 应用框架。路由分发器随即开始在预先注册的路由规则列表中进行线性或分层检索,尝试将当前请求路径与定义好的正则表达式进行匹配。
一旦某条正则表达式成功匹配当前路径,路由引擎就会从正则表达式的匹配结果对象中提取捕获的内容。如果是普通捕获组,参数通常按位置参数(*args)传入视图函数;如果是命名捕获组,则以字典形式提取为键值对(**kwargs)传入。随后,视图函数执行业务逻辑并返回 HTTP 响应。整个匹配链路严格遵循预处理、模式扫描、参数提取与视图分派四个阶段。
二、核心机制:Python re 模块与命名捕获组
在 Python 中,正则表达式的路由解析底层高度依赖标准库 re。理解该机制的核心在于区分两种捕获方式:
- 位置捕获组
(...):匹配的内容通过match.groups()以元组形式返回,视图函数只能按顺序通过位置参数接收。这种方式的可维护性较差,一旦在正则中间增删括号,所有入参顺序都会错乱。 - 命名捕获组
(?P<name>pattern):赋予捕获子表达式一个唯一的变量名,匹配成功后通过match.groupdict()返回键值字典。这使得参数绑定与正则表达式内的括号物理位置解耦,是现代 Web 框架推荐的做法。
以下为一个不依赖任何第三方库、使用 Python 原生 re 构建的最小可行路由分发器:
import re

class SimpleRegexRouter:
    def __init__(self):
        # 路由表:存储编译后的正则表达式对象与对应的处理函数
        self.routes = []

    def add_route(self, pattern_str, handler):
        # 严格使用 ^ 与 $ 限定首尾边界,防止部分匹配漏洞
        if not pattern_str.startswith('^'):
            pattern_str = '^' + pattern_str
        if not pattern_str.endswith('$'):
            pattern_str = pattern_str + '$'

        compiled_regex = re.compile(pattern_str)
        self.routes.append((compiled_regex, handler))

    def dispatch(self, path):
        for pattern, handler in self.routes:
            match = pattern.match(path)
            if match:
                # 提取命名捕获组字典
                kwargs = match.groupdict()
                if kwargs:
                    return handler(**kwargs)
                # 若无命名捕获组则检查是否有位置捕获组
                args = match.groups()
                return handler(*args) if args else handler()

        return "404 Not Found"

# 示例:注册带命名捕获组的路由
router = SimpleRegexRouter()

def article_detail(year, slug):
    return f"文章归档:年份={year}, 别名={slug}"

router.add_route(r"/articles/(?P<year>\d{4})/(?P<slug>[\w-]+)/?", article_detail)

# 测试分发
print(router.dispatch("/articles/2026/python-web-routing"))
# 输出:文章归档:年份=2026, 别名=python-web-routing
三、正则路由模式语法与 URL 解析映射详解
编写高可靠的正则路由,需要对 URL 路径的字符边界、转义符和量词有精确的把握。下表梳理了生产开发中常见的路由规则与对应的参数提取映射关系:
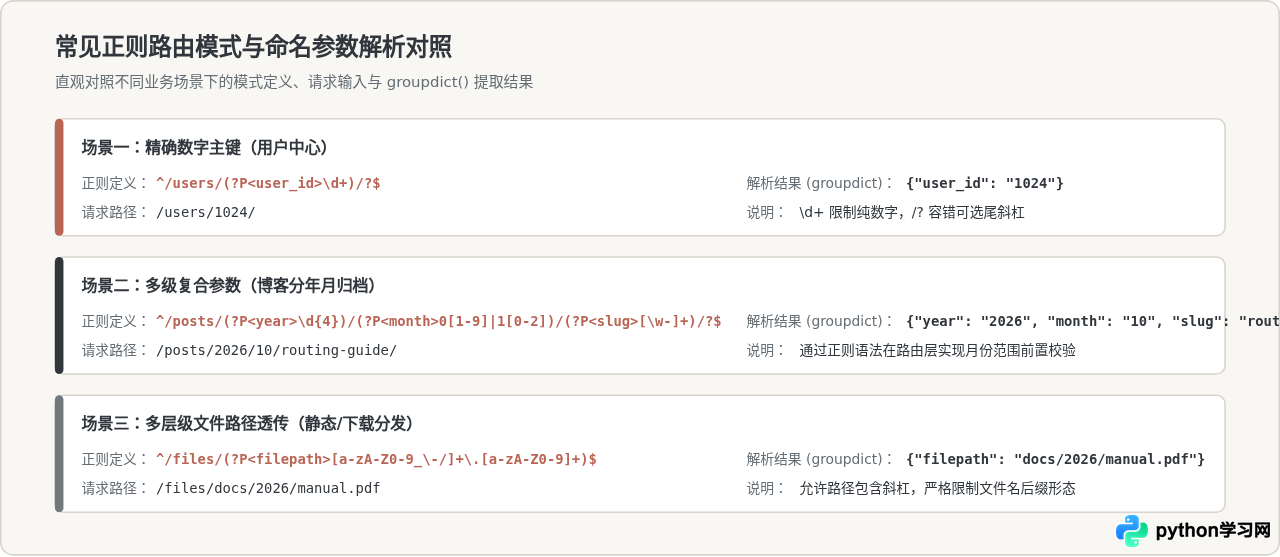
^ 开头,则类似于 re.search(),可能导致攻击者通过构造前缀(如 /malicious/users/10/)越权触发规则;若未以 $ 结尾,可能导致后续任意恶意路径被忽略而直接命中。因此,所有正则路由模式必须始终由 ^ 与 $ 紧密封闭。
四、主流 Python Web 框架中的实现方案对比
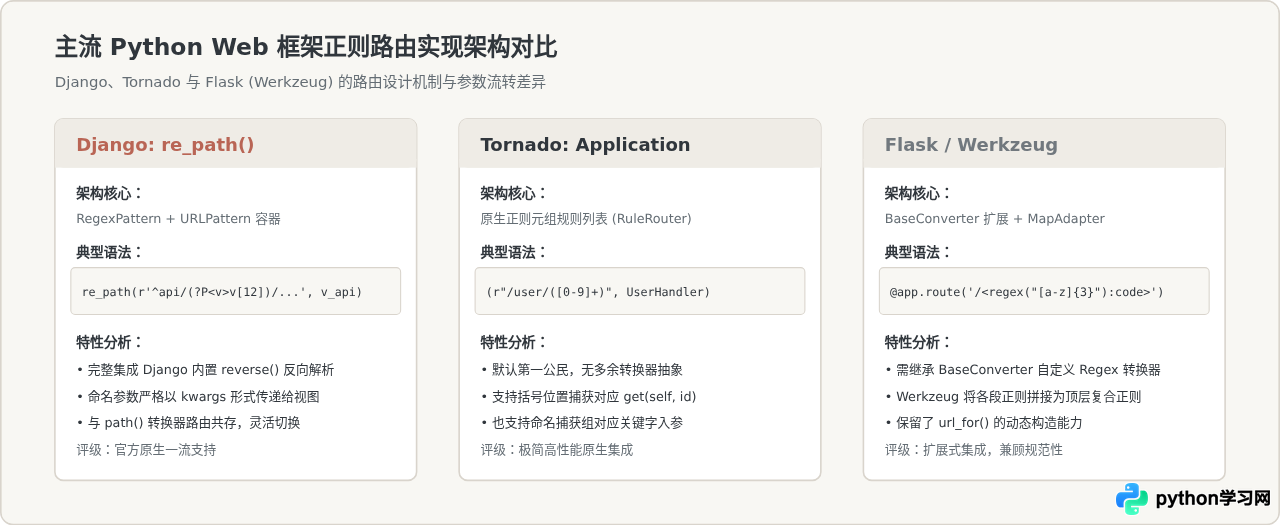
不同框架对待正则路由的设计理念各有侧重:Django 保持了对正则路由的显式支持;Tornado 从底层直接将正则作为路由元组的核心;而 Flask 则借助底层 Werkzeug 的 URL 转换器架构将正则适配为标准转换器。三者的架构对比如图 3 所示:
1. Django 方案:使用 re_path
Django 自 2.0 起引入了基于转换器的 path() 作为首选,但依然在 django.urls 模块中保留了 re_path(),用于应对无法被简单类型覆盖的高阶场景:
from django.urls import re_path
from . import views

urlpatterns = [
    # 匹配规范如 /orders/2026-ABC-9988/ 的订单编号
    re_path(r'^orders/(?P<year>\d{4})-(?P<region>[A-Z]{3})-(?P<seq>\d{4})/$', views.order_detail),
]

# 视图定义
def order_detail(request, year, region, seq):
    # 参数自动作为关键字实参传入,类型为原始字符串
    return HttpResponse(f"订单归档:{year}区[{region}]序列号{seq}")
2. Flask 方案:自定义 Regex 转换器
Flask 默认的路由语法 @app.route('/user/<int:id>') 依赖 Werkzeug 的转换器。若想在 Flask 中直接内嵌正则表达式,通常需要扩展 BaseConverter 并将其注册到应用实例中:
from flask import Flask
from werkzeug.routing import BaseConverter

class RegexConverter(BaseConverter):
    def __init__(self, url_map, *regex_args):
        super().__init__(url_map)
        # 将传入的正则表达式字符串赋给 regex 属性
        self.regex = regex_args[0]

app = Flask(__name__)
# 注册名为 regex 的 URL 转换器
app.url_map.converters['regex'] = RegexConverter

# 在路由装饰器中使用
@app.route('/item/<regex(r"[a-f0-9]{8}-[a-f0-9]{4}-[a-f0-9]{4}"):uuid>')
def show_item(uuid):
    return f"合法 UUID 资源:{uuid}"
五、生产实践:性能调优与安全防线
正则表达式在带来灵活性的同时,如果使用不当,极易成为系统的性能瓶颈甚至安全漏洞。在生产环境下编写正则路由时,必须遵循以下工程准则:
1. 正则预编译与内存常驻
在 Python 中,调用 re.match(pattern, string) 每次都会检查内部的正则表达式缓存池(默认最多缓存 512 个已编译模式)。在路由表初始化阶段,框架必须使用 re.compile() 将所有路径模式一次性预编译为底层 C 结构体的 Pattern 对象。切勿在每次请求到达的分发钩子内部动态生成和编译正则表达式。
2. 防范灾难性回溯(ReDoS)
这是正则路由最危险的安全隐患。当正则表达式中存在重叠的嵌套量词(如 (a+)+$ 或 ([a-zA-Z0-9]+)*$)时,一旦收到不匹配的长输入字符串,正则引擎的回溯算法时间复杂度会呈指数级爆炸($O(2^n)$),迅速耗尽单进程 CPU,导致整个 Web 服务无法响应其他请求。
- 原则 1:避免嵌套量词与重叠字符集。
- 原则 2:使用非贪婪量词时明确边界,优先使用具备明确排除项的字符集(例如用
[^/]+代替.+?)。 - 原则 3:在接入网关层(如 Nginx)限制 URI 最大长度,防止超长字符串进入正则匹配流程。
3. 参数类型转换与边界校验
re.Match.groupdict() 提取出的所有命名捕获值均为 str 字符串。如果业务逻辑需要整型或浮点数,必须在进入业务层之前做防御性类型转换。尽管 \d+ 保证了字符串只由数字字符组成,但仍可能超出系统架构数值极限或数据库主键范围,必须配合异常捕获处理。
六、总结与架构选型指引
正则表达式路由是 Python Web 开发中一把精度极高的手术刀。在选择是否使用正则路由时,可以通过图 4 所示的决策基线进行评估:
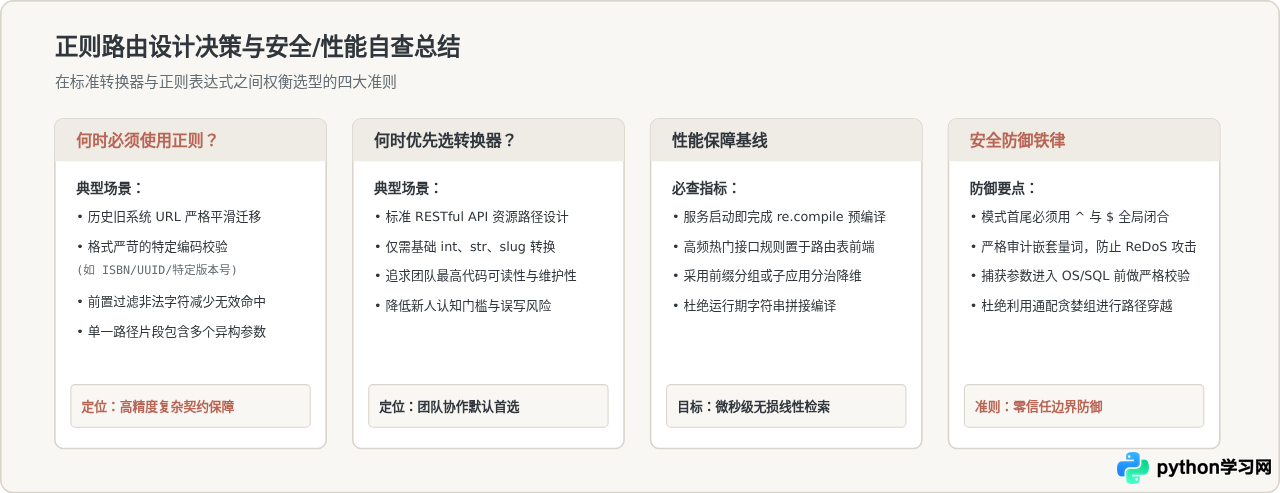
概括而言,对于通用的 CRUD 和标准化 RESTful 资源,推荐优先使用框架内置的类型转换器路由以保持代码精简直观;而当面对复杂的复合参数限制、多版本兼容路由、或是必须在接入层前置拦截异常字符的特定业务时,正则表达式路由配合 (?P<name>pattern) 命名捕获组则是 Python Web 开发者手中最可靠的利器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









