

Python怎么按指定位置或关键字截取字符串子串

string[start:end:step] 与双向索引机制快速截取;二是按特定关键字截取,通常先借助 str.find() 或 str.index() 计算关键字偏移,再配合切片取值,或直接通过 str.partition()、str.split() 以及正则表达式完成结构化提取。本文将系统拆解这两种场景的具体写法、工作原理与实战中的边界避坑点。
一、按指定位置截取:掌握 Python 原生切片(Slice)
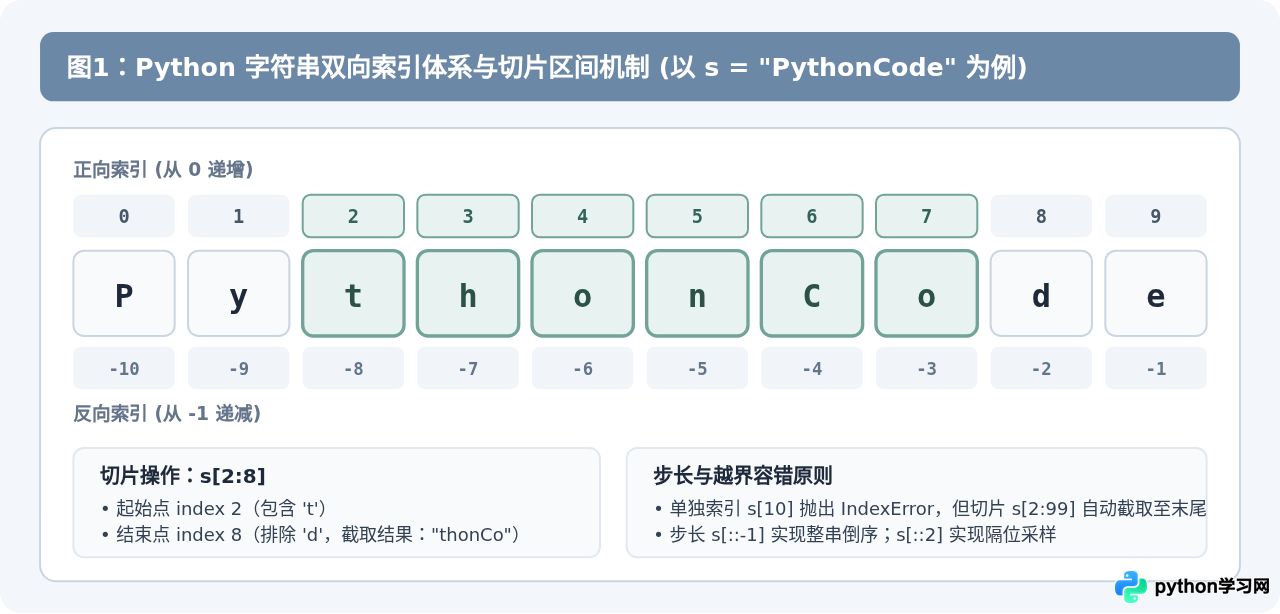
当开发者已知目标子串在原字符串中的固定偏移量或长度时,最直接高效的方式是使用 Python 的切片操作。字符串在 Python 中是有序的字符序列,每个字符对应唯一的正向索引与反向负索引。
1.1 切片核心语法与“左闭右开”原则
切片的基本语法结构为 string[start:end:step],其中包含三个可选参数:
start:截取的起始索引位置(包含该位置字符)。若省略,默认为 0(正向截取时)。end:截取的结束索引位置(不包含该位置字符)。若省略,默认截取至字符串末尾。step:步长,控制每次读取字符的步进跨度。默认值为 1;当步长为负数时表示从右向左反向截取。
需要特别注意 Python 遵循的“左闭右开”规则(即数学上的半开区间 [start, end))。截取出来的子串长度恰好等于 end - start(在步长为 1 且未越界的情况下)。
# 示例:基础切片演示
text = "PythonCode"

# 1. 截取前 6 个字符 (索引 0 到 5)
prefix = text[0:6]
print("前6个字符:", prefix)

# 2. 从第 6 个字符开始截取到末尾 (索引 6 到 9)
suffix = text[6:]
print("末尾子串:", suffix)

# 3. 截取中间片段 (索引 2 到 7, 对应字符 't' 到 'o')
middle = text[2:8]
print("中间片段:", middle)
末尾子串: Code
中间片段: thonCo
1.2 双向索引机制:正向与负向索引协同
Python 支持负数索引,从字符串末尾向前从 -1 开始递减。结合负索引,开发者无需手动计算 len(text) 即可轻松获取倒数字符。
# 示例:负索引切片
filename = "20261014_report_v2.csv"

# 提取文件后缀名 (倒数第 3 位到末尾)
extension = filename[-3:]
print("扩展名:", extension)

# 去除首尾特定长度 (去掉前 9 位日期和末尾 4 位后缀)
title = filename[9:-4]
print("报告主体名称:", title)
报告主体名称: report_v2
二、按关键字截取:动态定位边界并精确提取
现实开发中,待截取内容在字符串中的具体偏移量往往不是固定的,而是位于特定关键字(如冒号、逗号、特定标签或单词)之后、之前或两个关键字之间。此时需要先定位关键字的物理下标,再做切片截取。
2.1 定位关键字:find() 与 index() 的选择标准
Python 提供了两个内置方法用于检索子串首次出现的位置:
str.find(sub[, start[, end]]):返回子串sub的起始索引。若未找到,返回 -1,程序不会中断。str.index(sub[, start[, end]]):功能与find()类似,但若未找到,直接抛出 ValueError 异常。
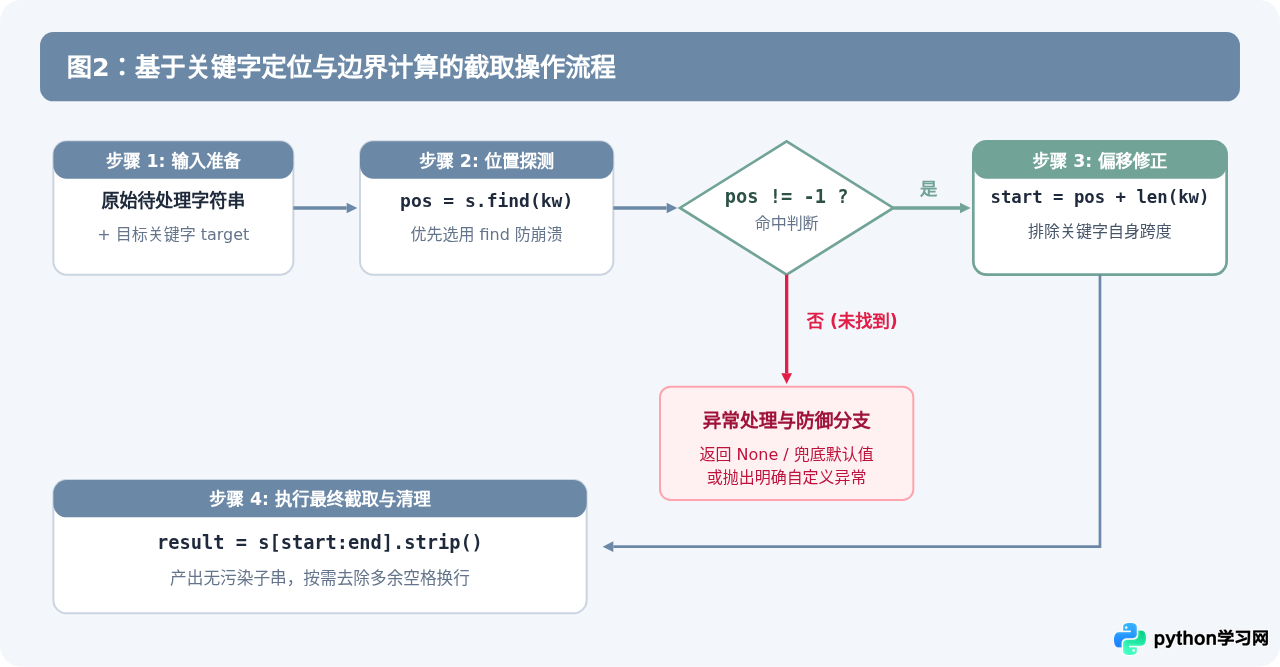
在编写具备健壮容错能力的代码时,强烈建议优先使用 find(),并通过判断返回值是否为 -1 规避异常。
2.2 场景一:截取关键字之后的内容
当需要截取关键字后面的所有内容时,切片的起始位置必须累加关键字本身的长度(len(keyword)),否则截取结果会多出关键字本身。
# 示例:截取关键字之后的内容
log_entry = "2026-10-14 ERROR: Database connection timeout during handshake"
keyword = "ERROR: "

pos = log_entry.find(keyword)
if pos != -1:
    # 关键点:起点必须加上关键字自身长度
    detail = log_entry[pos + len(keyword):]
    print("错误详情:", detail)
else:
    print("日志中未包含指定错误关键字")
2.3 场景二:截取关键字之前的内容
截取关键字之前的内容相对更为直观,直接将关键字的起始索引作为切片的 end 参数即可:
# 示例:截取关键字之前的内容
email = "developer.support@domain.example.com"
separator = "@"

sep_index = email.find(separator)
if sep_index != -1:
    username = email[:sep_index]
    print("用户名部分:", username)
2.4 场景三:截取两个特定关键字之间的子串
这是数据清洗和报文解析中最常见的需求。实现要点在于:先查找前导关键字并计算内容起点,再从该起点向后搜索结尾关键字,确保结尾关键字不会错配到前面出现的同名字符。
# 示例:精准截取两个标记之间的子串
html_snippet = '<div class="content">目标关键指标数据: 98.6%</div>'
start_tag = '<div class="content">'
end_tag = '</div>'

# 1. 查找前导标记
start_idx = html_snippet.find(start_tag)
if start_idx != -1:
    content_start = start_idx + len(start_tag)

    # 2. 从 content_start 开始向后查找闭合标记,避免定位偏差
    end_idx = html_snippet.find(end_tag, content_start)

    if end_idx != -1:
        extracted = html_snippet[content_start:end_idx].strip()
        print("提取出的内部纯文本:", extracted)
    else:
        print("未找到闭合标记")
else:
    print("未找到起始标记")
三、结构化截取方案:partition、split 与正则表达式
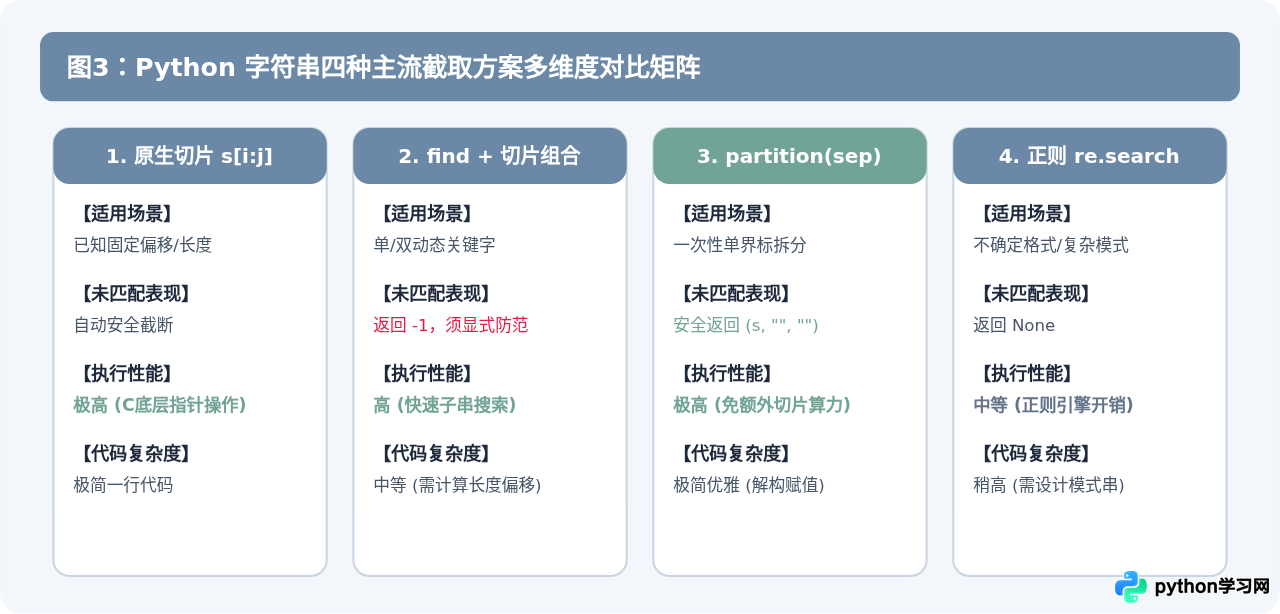
除了手动计算偏移量配合切片外,Python 还内置了面向特定格式的高阶处理工具。在合适的业务场景下使用这些工具,代码将更具表达力且更不易出错。
3.1 单一分隔符首选:str.partition()
如果目标仅是以某个固定关键字首次出现的位置为界,将原字符串拆成“关键字之前”、“关键字自身”以及“关键字之后”三部分,str.partition() 是最优雅的解决方案。它返回一个固定长度为 3 的元组:(head, sep, tail)。
# 示例:使用 partition 快速提取配置项
config_line = "database_host = 192.168.1.100:5432"

# 按照等号切分为三部分
key, sep, value = config_line.partition("=")

if sep:  # 如果找到了分隔符,sep 不为空字符串
    print("键名:", key.strip())
    print("键值:", value.strip())
else:
    print("行内未包含配置分隔符")
键值: 192.168.1.100:5432
partition() 最大的优势在于安全:若未找到关键字,它不会报错,而是返回 (原字符串, "", ""),极大简化了空值判断逻辑。
3.2 批量切分与片段提取:str.split()
当关键字在字符串中重复出现,或者我们需要按该关键字拆分成列表并提取特定序号的片段时,使用 str.split() 搭配 maxsplit 参数尤为有效。
# 示例:提取多段路径中的特定层级
path = "api/v1/users/profile/avatar"

# 1. 拆分全部节点并提取倒数第二级
segments = path.split("/")
print("倒数第二级分类:", segments[-2])

# 2. 限制最大拆分次数 (只拆第一处关键字)
route, sub_path = path.split("/", 1)
print("顶级路由:", route)
print("剩余子路径:", sub_path)
顶级路由: api
剩余子路径: v1/users/profile/avatar
3.3 复杂多变模式匹配:正则表达式(re 模块)
当关键字存在多种形态(如既可能是空格也可能是制表符、大小写不敏感、或关键字之间包含变动字符)时,硬编码切片往往难以满足需求。此时应使用 Python 内置的 re.search() 搭配分组捕获(Capture Groups)。
import re

# 示例:从非标准字符串中提取动态价格数据
text_data = "Item: UltraLaptop; Model: X1; Price: [¥12899.00]; InStock: Yes"

# 匹配 "Price: [" 与 "]" 之间的具体金额
pattern = r"Price:\s*\[([¥$]?[\d,]+(?:\.\d+)?)\]"
match = re.search(pattern, text_data)

if match:
    # group(1) 对应正则中第一个小括号捕获的内容
    price_str = match.group(1)
    print("提取出的价格子串:", price_str)
else:
    print("未匹配到价格信息")
四、关键细节与高频避坑指南
在生产环境下,字符串截取逻辑若缺少严密的边界校验,容易产生难以排查的隐蔽缺陷。以下是三处必须防范的高频陷阱:
4.1 陷阱一:find() 返回 -1 引发“意外倒数切片”
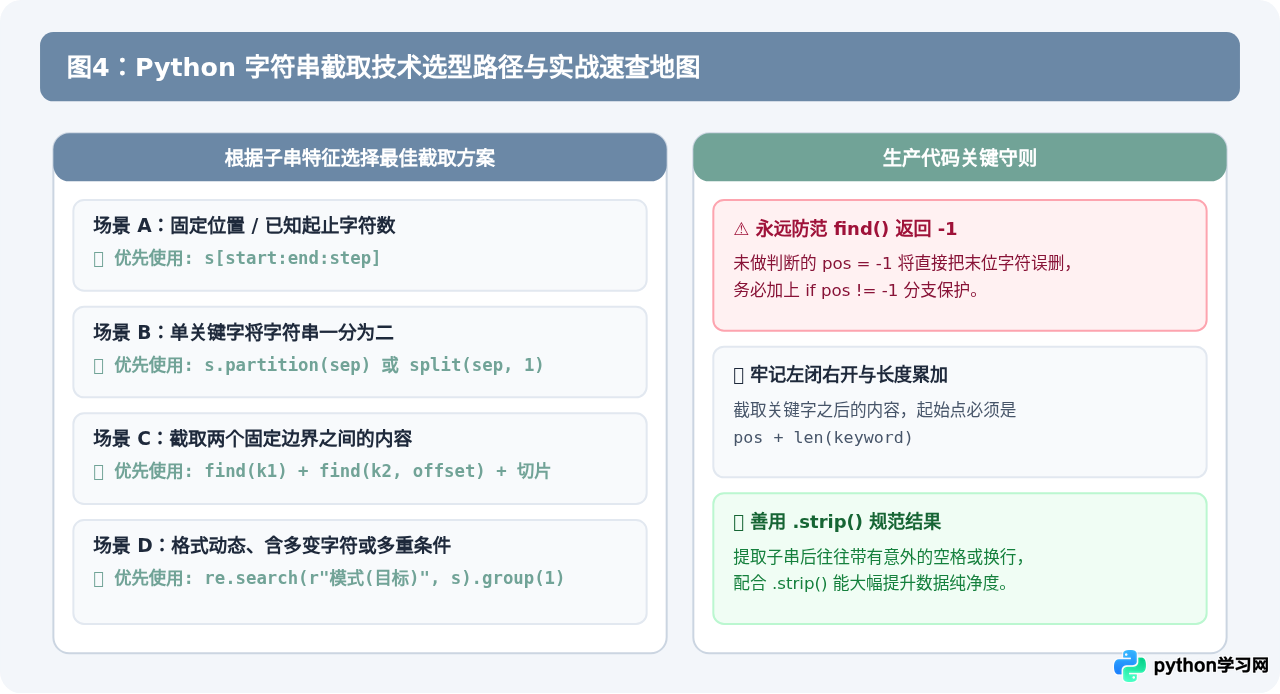
这是 Python 截取中最隐蔽的逻辑 Bug。当 find() 未找到目标时会返回 -1。如果不做条件判断,直接写出形如 text[:pos] 的切片,Python 会将其理解为 text[:-1],结果是静默删除了原字符串的最后一个字符,而不是报错,导致数据错误层层扩散。
# 错误示例:未判空的致命后果
raw_data = "OrderNumber#10293"
pos = raw_data.find("@")  # 字符串中根本没有 @,pos 为 -1

buggy_result = raw_data[:pos]  # 相当于 raw_data[:-1]
print("错误截取结果:", buggy_result)  # 输出 "OrderNumber#1029",末尾 3 被吃掉了!

# 正确写法:必须严谨判断 pos != -1
if pos != -1:
    correct_result = raw_data[:pos]
else:
    correct_result = raw_data  # 或针对业务逻辑抛出警告
4.2 陷阱二:忽略关键字自身跨度的“差一错误(Off-by-one)”
截取关键字之后的内容时,不少初学者常误写为 text[pos:] 或 text[pos + 1:]。请牢记:pos 指向的是关键字的第一个字符的下标。要想彻底排除关键字,必须偏移 pos + len(keyword)。
4.3 陷阱三:字符串不可变性(Immutability)与内存开销
Python 中的 str 是不可变对象(Immutable)。所有的切片与截取操作都会在内存中**分配新内存并构建新的子字符串对象**,绝不会直接修改原始字符串。如果在处理几十兆或几百兆的大文件日志时频繁产生大量切片,应当注意内存开销;若只需判断或遍历,可考虑使用 memoryview(配合 bytes)或迭代器来优化内存。
五、选型总结与决策指南
为便于开发者在面对不同需求时快速选型,建议遵循以下决策路径:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









