

Python爬虫实战:分页列表页与详情页数据抓取的完整代码逻辑
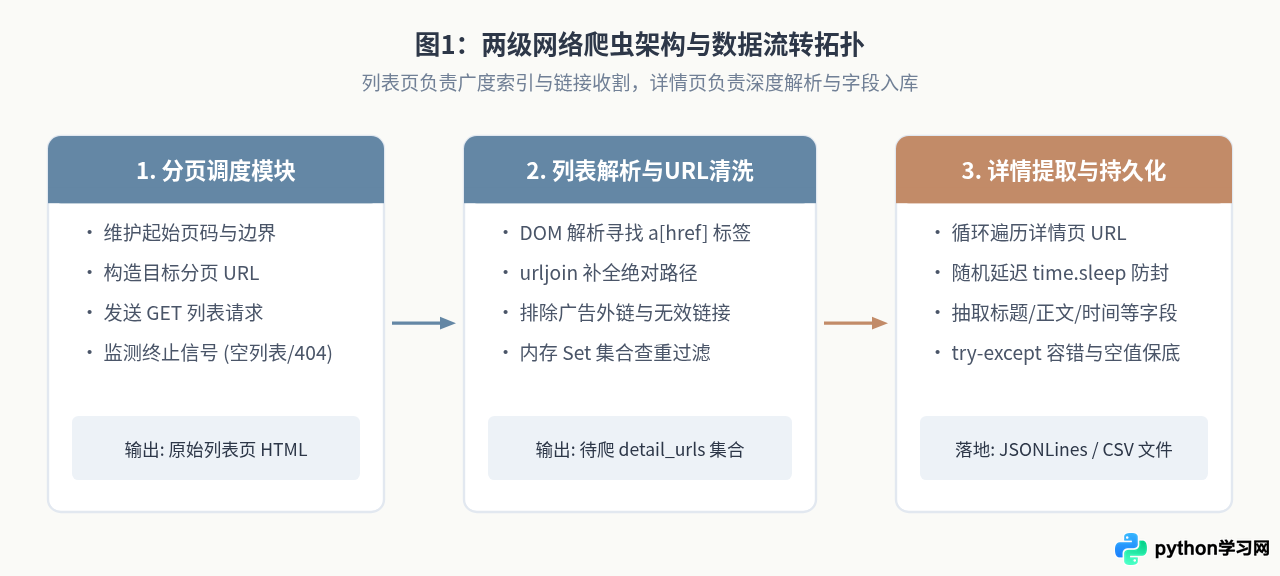
在网络数据采集场景中,“先遍历分页列表页提取条目链接,再深入详情页提取结构化字段”是最经典也是最常用的两级抓取模式。解决这一问题的核心路径在于将流程解耦为两大阶段:第一阶段负责翻页状态控制与URL标准化提取,第二阶段负责详情页内容下载、字段清洗与异常容错。本文将围绕这一核心逻辑,详细拆解从列表遍历到详情解析落地的完整代码实现与工程防御策略。
一、两级网络爬虫架构与数据流转拓扑
多数内容型网站(如资讯门户、电商目录、房产列表等)均采用“列表+详情”的信息组织方式。列表页只包含标题、缩略图和简要摘要,完整正文、发布时间、多维参数等高价值信息都存放在各自独立的详情页中。
如果将所有抓取逻辑堆叠在一个循环或函数中,一旦某一条详情页解析失败,便容易导致整个翻页循环中断。因此,工程上必须将两级抓取明确划分为“列表调度层”与“详情处理层”,两层之间通过标准URL进行解耦传递。
二、分页列表页遍历与链接提取机制
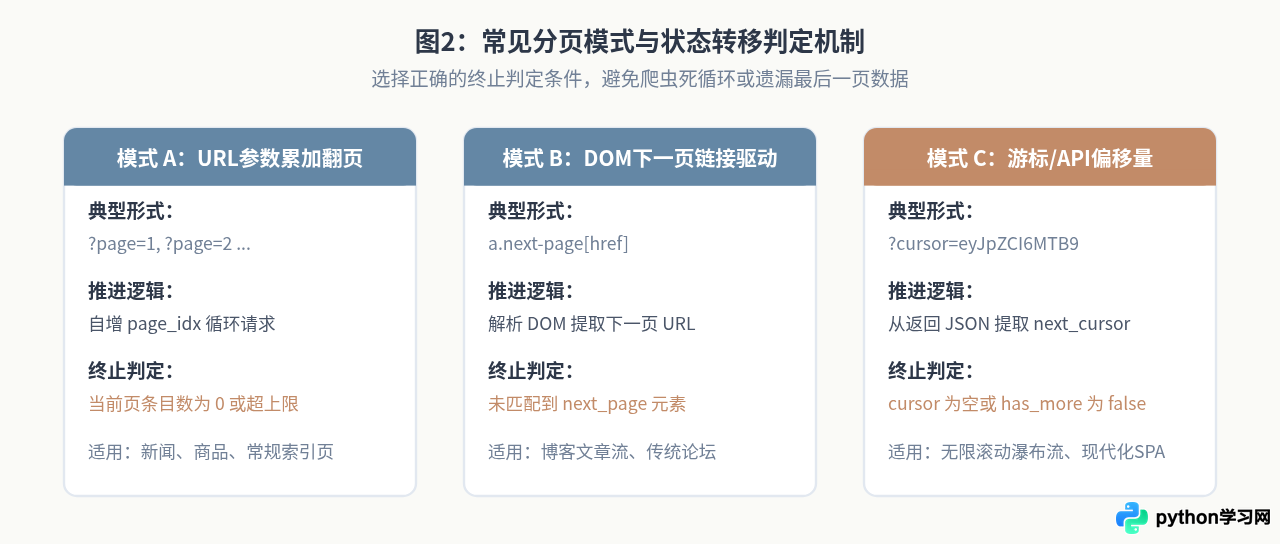
在实际工程中,翻页方式通常分为两类:一是参数规律型,通过在 URL 查询参数中递增 page=1, 2, 3... 或偏移量;二是游标驱动型,通过 DOM 中“下一页”按钮所指向的 href 获取后继链接。
处理分页列表页时,必须重点关注以下三个关键细节:
- 相对路径补全:列表页的
<a>标签往往包含相对路径(如/detail/1024.html或item_20.html)。如果不结合父级 URL 使用urllib.parse.urljoin转换为标准绝对地址,直接请求会抛出InvalidURL或MissingSchema错误。 - 列表页空内容判断:绝大多数网站对于超出末页的请求并不会返回 404,而是返回一个“没有任何条目的空页面”。若仅凭 HTTP 状态码 200 无法判断翻页结束,必须以解析出的详情链接数量为 0 作为终止信号。
- 链接去重过滤:同一列表页内可能存在多处指向同一详情页的链接(例如图片卡片和标题文本共用链接),必须在进入详情队列前进行集合去重。
三、详情页抓取时序与异常防护流程
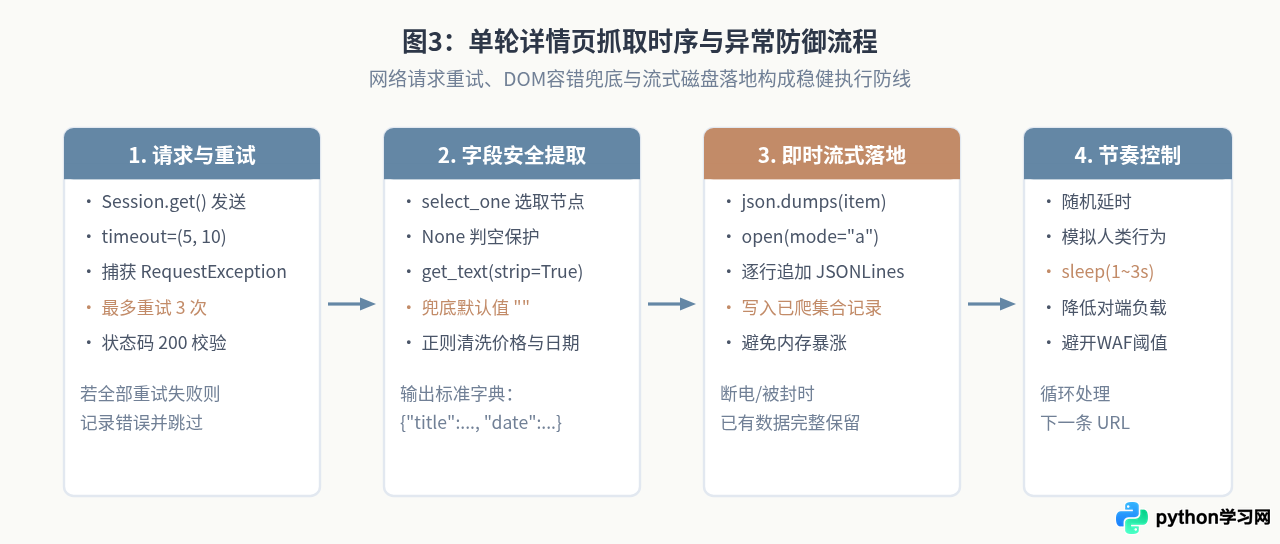
详情页抓取通常占据整个爬取过程 80% 以上的时间。因为每个列表页对应数十条详情页,HTTP 请求频次成倍上升。因此,详情页逻辑必须具备严谨的稳健性设计:
- 连接复用:使用
requests.Session()管理网络连接,启用 HTTP Keep-Alive,大幅降低频繁建立 TCP/TLS 握手的延迟开销。 - 超时与重试保护:网络抖动和服务器丢包属于常态,每个请求必须显式指定
timeout=(5, 15),配合重试计数器,避免线程无期限挂起。 - DOM 解析防御:网页字段可能存在缺失(如某些资讯没有副标题或标签)。使用 BeautifulSoup 选择器提取元素时,禁止直接使用
soup.select('...')[0],应当使用soup.select_one('...')并进行非空校验,未匹配时赋予默认空字符串或None,彻底杜绝IndexError。 - 流式即时落地:每抓取完一条详情页,立即将结构化数据以追加模式写入磁盘(如 JSONLines 格式)。切忌将所有数据缓存在内存中等全部翻页结束后一次性写入,否则一旦中途遭遇断网或被封禁,前面采集的所有数据都将化为乌有。
四、完整可运行代码实现
下面给出一段结构严谨、模块化划分的 Python 脚本。代码基于 requests 和 BeautifulSoup 构建,实现了列表翻页调度、链接提取与去重、详情解析与异常安全降级,并即时保存到本地 crawler_output.jsonl 文件中。
执行环境准备说明:需要 Python 3.8+ 环境,并安装基础依赖 pip install requests beautifulsoup4。
import json
import logging
import random
import time
from urllib.parse import urljoin
import requests
from bs4 import BeautifulSoup

# 配置日志输出格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)
logger = logging.getLogger("CrawlerEngine")

# 基础常量配置
BASE_URL = "https://example.com/blog/"
PAGE_TEMPLATE = "https://example.com/blog/?page={page}"
OUTPUT_FILE = "crawler_output.jsonl"
MAX_PAGES = 5  # 最大抓取页数控制
REQUEST_TIMEOUT = (5, 12)  # (连接超时, 读取超时)

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0.0.0 Safari/537.36"
    ),
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
}


def create_session() -> requests.Session:
    """初始化并配置持久化 HTTP 会话。"""
    session = requests.Session()
    session.headers.update(HEADERS)
    return session


def fetch_html(session: requests.Session, url: str, max_retries: int = 3) -> str | None:
    """
    通用页面下载函数,包含超时控制与指数退避重试。
    """
    for attempt in range(1, max_retries + 1):
        try:
            response = session.get(url, timeout=REQUEST_TIMEOUT)
            if response.status_code == 200:
                # 自动根据页面内容解析字符编码
                response.encoding = response.apparent_encoding
                return response.text
            elif response.status_code in (403, 429):
                logger.warning("触发访问限制状态码: %s, URL: %s", response.status_code, url)
                time.sleep(attempt * 3)
            else:
                logger.warning("请求异常状态码: %s, URL: %s", response.status_code, url)
                return None
        except requests.exceptions.RequestException as e:
            logger.warning("第 %d 次请求出错 [%s]: %s", attempt, url, e)
            time.sleep(attempt * 2)

    logger.error("超出最大重试次数,请求放弃: %s", url)
    return None


def parse_list_page(html_content: str, current_page_url: str) -> list[str]:
    """
    解析列表页,提取条目链接并完成绝对路径补全与同页去重。
    """
    soup = BeautifulSoup(html_content, "html.parser")
    detail_links: list[str] = []
    seen_in_page: set[str] = set()

    # 根据目标站点实际 DOM 规则微调选择器,例如文章卡片内的标题链接
    items = soup.select(".post-item a.post-title-link, .article-list a.title")
    for a_tag in items:
        raw_href = a_tag.get("href")
        if not raw_href or raw_href.startswith(("#", "javascript:")):
            continue

        # 核心逻辑:结合列表页当前 URL 补全绝对路径
        full_url = urljoin(current_page_url, raw_href)

        # 过滤站外无关链接与页内重复条目
        if full_url.startswith(BASE_URL) and full_url not in seen_in_page:
            seen_in_page.add(full_url)
            detail_links.append(full_url)

    return detail_links


def parse_detail_page(html_content: str, detail_url: str) -> dict | None:
    """
    解析详情页核心字段,包含完善的非空容错逻辑。
    """
    soup = BeautifulSoup(html_content, "html.parser")

    # 1. 标题提取 (带有降级备选选择器)
    title_node = soup.select_one("h1.article-title, h1.entry-title, .content h1")
    title = title_node.get_text(strip=True) if title_node else ""

    # 若标题无法抽取,很可能页面异常或触发了验证码页面
    if not title:
        logger.warning("未能提取到有效标题,跳过该详情页: %s", detail_url)
        return None

    # 2. 发布日期提取与容错
    date_node = soup.select_one(".post-meta time, .publish-date, span.date")
    publish_date = date_node.get_text(strip=True) if date_node else "未知"

    # 3. 作者提取
    author_node = soup.select_one(".author-name, a.author")
    author = author_node.get_text(strip=True) if author_node else "匿名"

    # 4. 正文提取
    content_node = soup.select_one(".article-body, .entry-content, #main-content")
    content = content_node.get_text(separator="\n", strip=True) if content_node else ""

    return {
        "url": detail_url,
        "title": title,
        "publish_date": publish_date,
        "author": author,
        "content_length": len(content),
        "content_preview": content[:120].replace("\n", " "),
        "scraped_at": time.strftime("%Y-%m-%d %H:%M:%S")
    }


def append_record_to_file(record: dict, filepath: str) -> None:
    """
    将单条结构化数据即时追加写入 JSONLines 格式文件。
    """
    with open(filepath, "a", encoding="utf-8") as f:
        line = json.dumps(record, ensure_ascii=False)
        f.write(line + "\n")


def run_crawler() -> None:
    """
    主控制循环:串联分页遍历、详情调度与流式存储。
    """
    session = create_session()
    global_crawled_urls: set[str] = set()
    total_saved_count = 0

    logger.info("爬虫引擎启动,开始抓取分页数据...")

    for page_idx in range(1, MAX_PAGES + 1):
        list_url = PAGE_TEMPLATE.format(page=page_idx)
        logger.info("正在获取第 %d 页列表: %s", page_idx, list_url)

        list_html = fetch_html(session, list_url)
        if not list_html:
            logger.warning("第 %d 页列表请求失败,终止后续翻页。", page_idx)
            break

        # 从列表页抽取详情 URL
        detail_urls = parse_list_page(list_html, list_url)
        if not detail_urls:
            logger.info("第 %d 页未解析到任何条目链接,判定已达末尾页,退出循环。", page_idx)
            break

        logger.info("第 %d 页解析成功,发现 %d 个目标详情链接。", page_idx, len(detail_urls))

        # 遍历详情页
        for idx, detail_url in enumerate(detail_urls, start=1):
            if detail_url in global_crawled_urls:
                logger.info("已跳过历史重复 URL: %s", detail_url)
                continue

            logger.info("  [%d/%d] 正在抓取详情: %s", idx, len(detail_urls), detail_url)
            detail_html = fetch_html(session, detail_url)

            if detail_html:
                record = parse_detail_page(detail_html, detail_url)
                if record:
                    append_record_to_file(record, OUTPUT_FILE)
                    total_saved_count += 1
                    global_crawled_urls.add(detail_url)

            # 礼貌爬取间隔,随机浮动避免固定频率被安全策略识别
            sleep_duration = random.uniform(1.0, 2.5)
            time.sleep(sleep_duration)

        # 列表页之间的过渡延时
        time.sleep(random.uniform(2.0, 3.5))

    logger.info("抓取任务结束!累计成功保存记录: %d 条,文件存放在 %s", total_saved_count, OUTPUT_FILE)


if __name__ == "__main__":
    run_crawler()
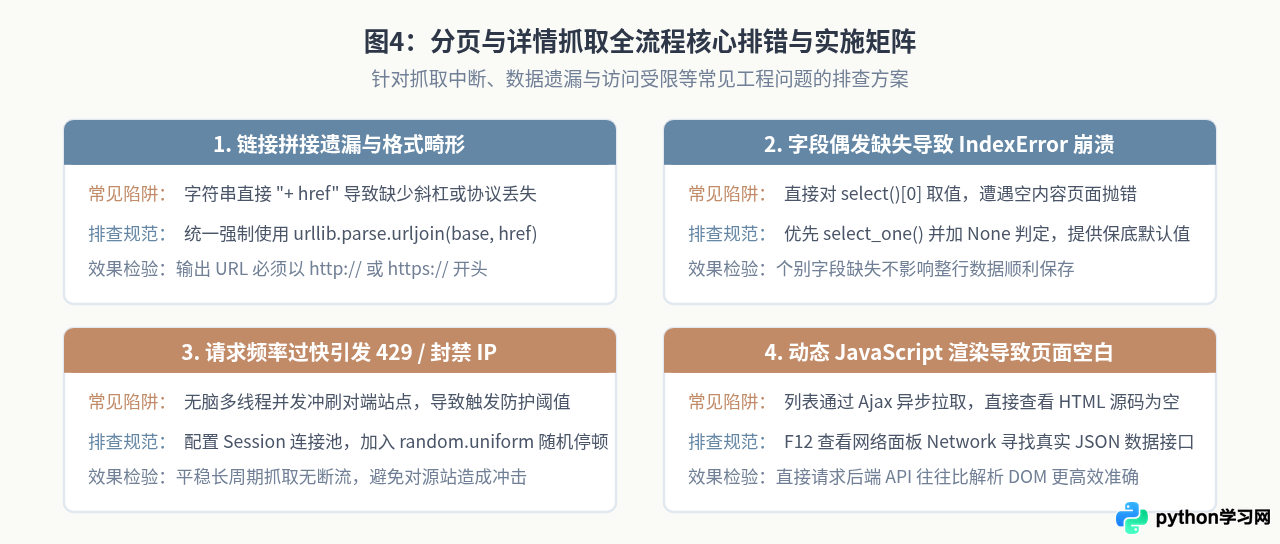
五、生产环境核心排错与设计要点总结
在将上述代码部署到具有更高安全策略或数据体量的真实环境时,通常会遇到各种非预期问题。以下总结了四种最常见的陷阱与对应的工程解决方案:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









