

自动化办公与数据分析:非程序员学Python的职业突破口

非程序员学习 Python 的核心目标并不是转型为专业软件工程师,而是将编程语言作为杠杆工具,解决日常业务中大量机械重复、高耗时且易出错的文件处理与报表统计工作。通过聚焦自动化办公与轻量数据分析两个场景,业务人员能够快速打通“读取数据、清洗计算、生成报告”的执行链路,在不改变既有岗位职责的前提下显著提升工作交付质量与单位时间产出。
一、定位差异:为什么办公自动化是最佳突破口
大多数非技术背景的职场人在尝试学习编程时,往往陷入照搬计算机专业课程体系的误区:从复杂的面向对象、设计模式、数据结构起步,耗费数月时间却无法解决手头的任何实际工作问题,最终因缺乏正向反馈而放弃。
对于运营、财务、市场、人力及业务分析等岗位而言,日常工作的瓶颈往往集中在繁琐的数据流转环节。例如:跨系统导出几十个格式相同的销售清单需要手工逐一合并;每月计算考勤和绩效需要大量机械的 VLOOKUP 与公式套用;或者需要对多份 Word 格式的合同进行批量修改与信息提取。
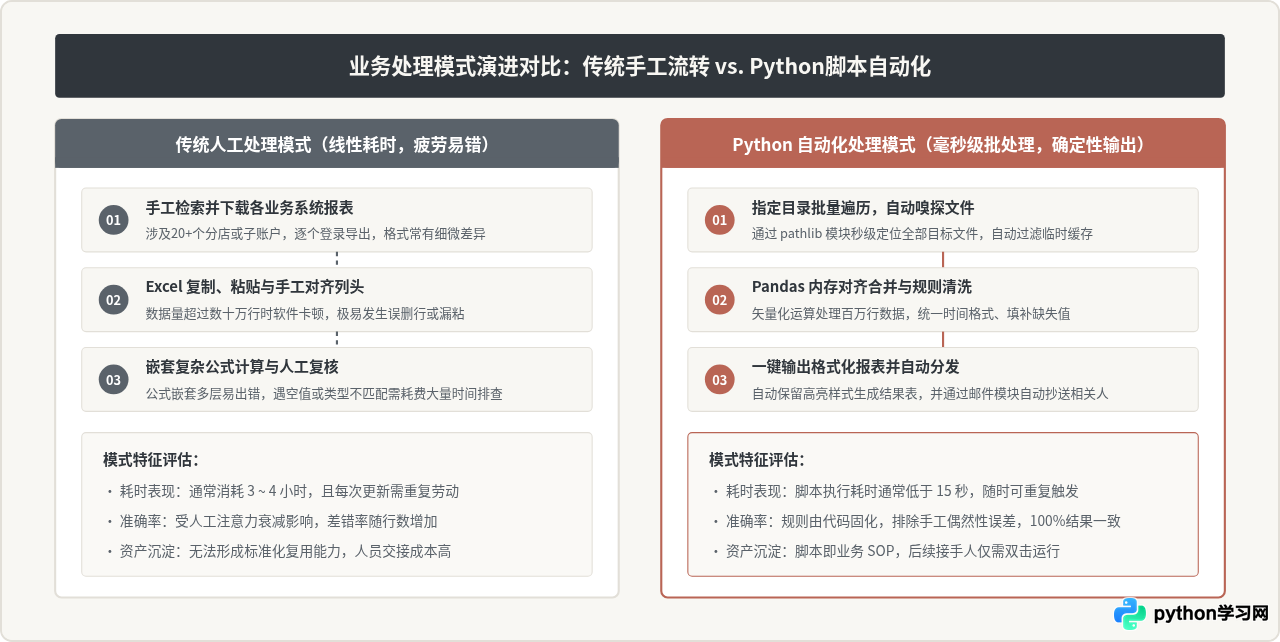
传统手工操作随着数据量膨胀呈现线性耗时增长,且极易因人为疲劳产生错漏。而 Python 脚本能够将既定的业务处理规则抽象为代码逻辑,使任务耗时从几小时压缩至数秒,并且具备严格的执行一致性。
二、非程序员的技能精简原则:只学 20% 的高频功能
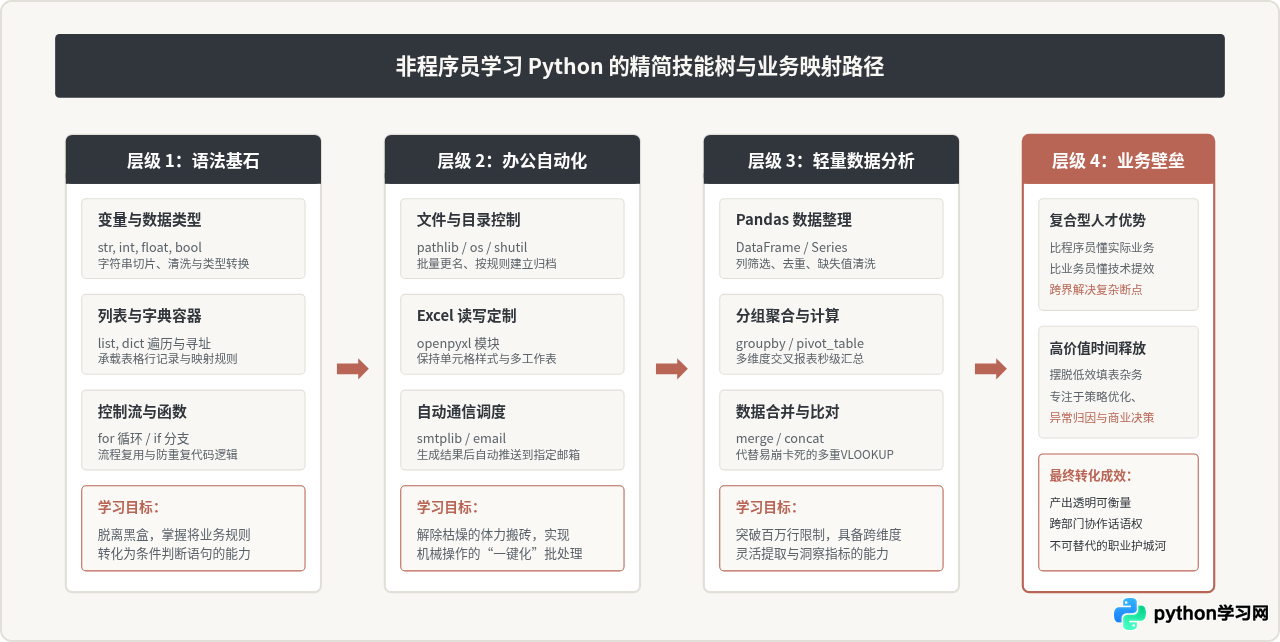
学习 Python 时必须明确边界:非技术人员不需要掌握网络底层协议、内存垃圾回收机制或算法复杂度优化。只要掌握一套精简的“胶水代码”组合,就能覆盖日常 80% 以上的办公自动化与分析场景。
1. 核心语法基础(控制流与容器)
在语法层面,仅需扎实理解四个基础构件:
- 基础变量类型:字符串(
str,用于文本拼接与清洗)、整数与浮点数(int,float,用于数值统计)、布尔值(bool,用于条件判断)。 - 核心数据容器:列表(
list,用于存储有序的项目或文件队列)、字典(dict,用于存储键值对映射,如员工工号与姓名的映射关系)。 - 循环遍历与条件控制:
for循环(处理每一个文件或每一行数据)与if/elif/else条件分支(根据业务规则实施分流判断)。 - 函数封装:将重复用到的 5-10 行逻辑包装为一个命名函数,传入参数并返回处理结果。
2. 核心类库精选(按场景划分)
针对常见的文件类型与操作,只需要熟悉以下三个维度的标准工具库:
- 本地文件系统与路径调度:标准库
pathlib与os。用于遍历指定目录、按扩展名筛选文件、新建分类文件夹及自动重命名。 - 表格数据与结构化计算:核心第三方库
pandas与openpyxl。Pandas 是数据分析的通用基石,支持一键读取海量 CSV/Excel,进行快速排序、过滤、分组聚合及透视;Openpyxl 则专精于保留 Excel 复杂单元格格式与样式批注。 - 通信与通知闭环:标准库
smtplib与email,在报表生成完毕后自动构建带附件的邮件发送给指定负责人。
三、实操步骤:多源表格自动合并与清洗示例
为了展示代码如何在真实办公场景中发挥作用,以下提供一个典型案例:某企业有 30 家门店,每天都会提交一份命名格式为 门店名_销售明细.xlsx 的表格。业务人员需要将这些分散的文件合并成总表,过滤掉测试订单,并计算各品类的销售总额与均价。
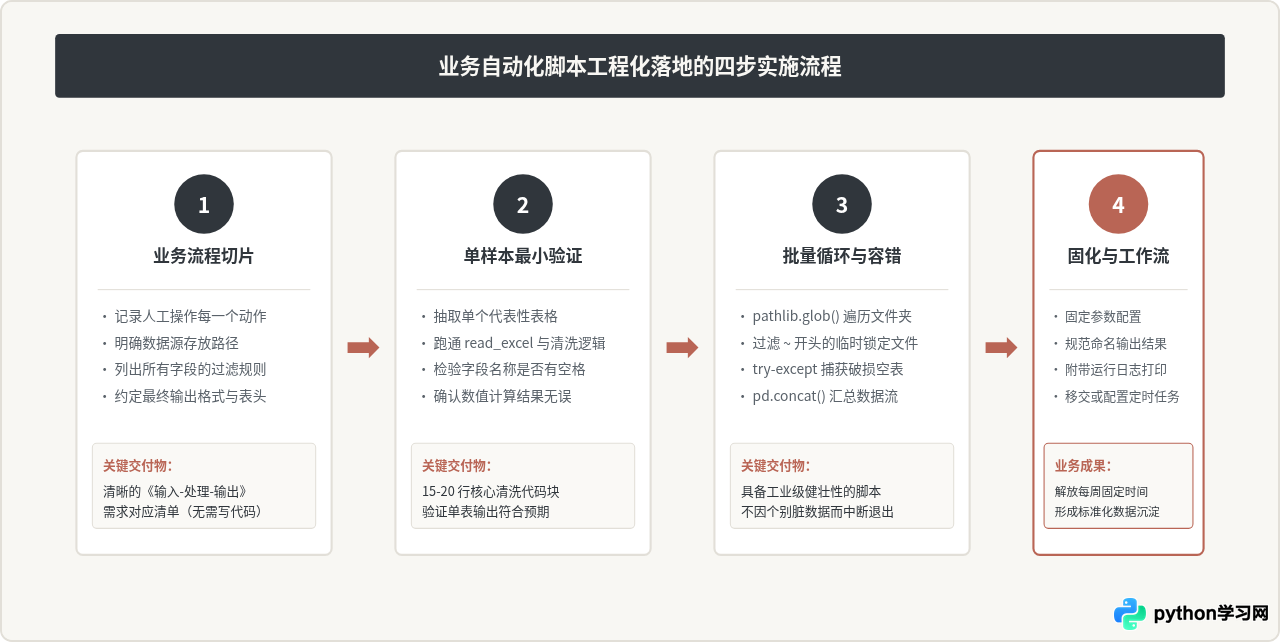
1. 脚本编写实施的四个阶段
任何自动化任务在动手写代码前,都应该遵循标准化的落地流程,避免边写边改导致逻辑混乱:
- 步骤一:业务逻辑拆解。明确输入(散落在特定文件夹内的几十个 Excel 文件)、过滤规则(“订单状态”列必须为“已完成”且“销售额”大于 0)以及输出结构(按产品品类汇总的统计表)。
- 步骤二:单文件逻辑跑通。只拿一个样本文件进行开发,测试数据读取、列名匹配与类型转换是否正确。
- 步骤三:批量循环与容错处理。引入循环读取全部文件,添加
try...except机制跳过损坏或打不开的文件,记录异常日志。 - 步骤四:成果输出与自检。将合并结果输出为带有日期的汇总表,并打印处理文件数及总耗时。
2. 完整合并清洗代码
执行环境要求:Python 3.8 及以上版本,安装有 pandas 和 openpyxl 库。在终端或命令行运行 pip install pandas openpyxl 即可准备完毕。
import os
from pathlib import Path
import pandas as pd
from datetime import datetime

# 1. 明确路径定义与配置
DATA_DIR = Path("./sales_reports")
OUTPUT_FILE = Path(f"./daily_summary_{datetime.today().strftime('%Y%m%d')}.xlsx")

def process_daily_sales():
    all_data = []
    processed_count = 0
    error_count = 0

    # 2. 遍历指定目录下所有的 xlsx 文件
    print(f"[{datetime.now().strftime('%H:%M:%S')}] 开始扫描销售文件目录: {DATA_DIR}")
    if not DATA_DIR.exists():
        print(f"错误: 目标目录 {DATA_DIR} 不存在,已终止运行。")
        return

    for file_path in DATA_DIR.glob("*.xlsx"):
        # 排除 Excel 生成的隐藏临时文件(以 ~$ 开头)
        if file_path.name.startswith("~$"):
            continue

        try:
            # 读取当前表格
            df = pd.read_excel(file_path)

            # 从文件名中提取门店标识(例如 "海淀店_销售明细.xlsx" 提取 "海淀店")
            store_name = file_path.stem.split("_")[0]
            df["门店名称"] = store_name

            # 数据清洗:仅保留已完成的正常业务订单,且销售额必须大于0
            filtered_df = df[(df["订单状态"] == "已完成") & (df["销售额"] > 0)].copy()

            all_data.append(filtered_df)
            processed_count += 1
            print(f"成功处理: {file_path.name} (有效数据: {len(filtered_df)} 行)")
        except Exception as e:
            print(f"读取异常: {file_path.name},原因: {e}")
            error_count += 1

    # 3. 数据集纵向拼接与透视汇总
    if not all_data:
        print("未检测到有效数据,退出处理。")
        return

    merged_df = pd.concat(all_data, ignore_index=True)

    # 按品类统计汇总:销售额总计、订单数量与客单价
    summary_report = merged_df.groupby("商品品类").agg(
        销售总额=("销售额", "sum"),
        订单总量=("订单编号", "count"),
        平均客单价=("销售额", "mean")
    ).reset_index()

    # 格式化数值展示
    summary_report["销售总额"] = summary_report["销售总额"].round(2)
    summary_report["平均客单价"] = summary_report["平均客单价"].round(2)

    # 4. 输出到 Excel 的多个工作表中
    with pd.ExcelWriter(OUTPUT_FILE, engine="openpyxl") as writer:
        summary_report.to_excel(writer, sheet_name="品类汇总统计", index=False)
        merged_df.to_excel(writer, sheet_name="清洗后全量明细", index=False)

    print(f"\n[{datetime.now().strftime('%H:%M:%S')}] 执行完毕!")
    print(f"成功合并文件数: {processed_count},异常跳过数: {error_count}")
    print(f"汇总全量行数: {len(merged_df)},已保存至: {OUTPUT_FILE}")

if __name__ == "__main__":
    process_daily_sales()
代码执行关键点说明:
file_path.name.startswith("~$"):自动忽略 Excel 编辑过程中生成的临时锁定文件,这是很多脚本在他人正在打开文件时报错退出的常见原因。pd.concat(all_data, ignore_index=True):一次性在内存中合并所有 DataFrame,性能比逐次读取并追加到 Excel 快百倍以上。pd.ExcelWriter:支持同时把汇总指标卡和底层明细写入同一个工作簿的不同 Sheet 中,便于管理层看总结、业务人员查明细。
四、从办公提效迈向业务数据分析
自动化脚本解决的是“时间被琐事占满”的问题,而数据分析解决的是“业务决策缺乏依据”的问题。当繁重的机械流程被自动化接管后,非程序员的精力应当逐步转移到数据指标的深入挖掘上。
1. 发现隐藏在平均值背后的业务异动
手工制作 Excel 透视表时,业务人员通常习惯只看“均值”或“总和”。但这种宏观指标往往会掩盖深层次的运营异动。例如,某类商品整体销售额保持平稳,但在细分客群中可能已经出现了严重流失,仅仅是因为少数几个大单掩盖了下降趋势。
利用 Pandas,非技术人员可以低成本地实现更敏锐的分析手段:
- 多维度交叉对比:按时间窗口、门店区域、客户等级进行三维交叉聚合,迅速定位负向增长的异常单元。
- 四分位数与离群点识别:借助
quantile()或描述性统计函数,快速筛查退款率过高或客单价极度异常的异常交易记录。 - 用户生命周期价值计算(RFM):根据最近一次购买时间(R)、消费频率(F)和消费金额(M),为几十万用户打上层级标签,指导差异化营销。
2. 业务理解是非程序员的核心护城河
很多初学者常有一个顾虑:“专业程序员的技术比我好得多,我学这些简单的脚本能有竞争力吗?”
事实恰恰相反:在绝大多数业务场景中,最困难的环节往往不是代码语法,而是对业务规则、流程逻辑与指标内涵的深刻理解。专业开发团队通常远离一线业务场景,沟通成本高,且极难有精力响应日常运营中琐碎且瞬息万变的小型报表需求。
一个懂业务痛点、能够独立写出轻量级数据处理脚本的运营或财务专家,既能免去漫长的跨部门提需求排期等待,又能结合业务直觉迅速验证假设,这种复合能力构成了极高的职业壁垒。
五、避坑指南:非程序员必须警惕的三个误区
在实际学习与落地过程中,非技术人员往往会面临一些非技术性的阻力。保持以下清醒的认知准则,能少走数月弯路:
误区 1:试图写出“完美无瑕、工业级架构”的代码
专业软件开发需要考虑多线程并发、高可用容灾与复杂接口安全,但个人办公自动化脚本的核心标准只有一条:能否稳定、准确地完成当前业务并输出正确结果。哪怕代码写得直白、只有三四十行、没有封装高级类,只要它把 3 小时的工作缩减到 10 秒,它就是优秀的办公工具。不要因为“代码不够优雅”而产生畏难情绪。
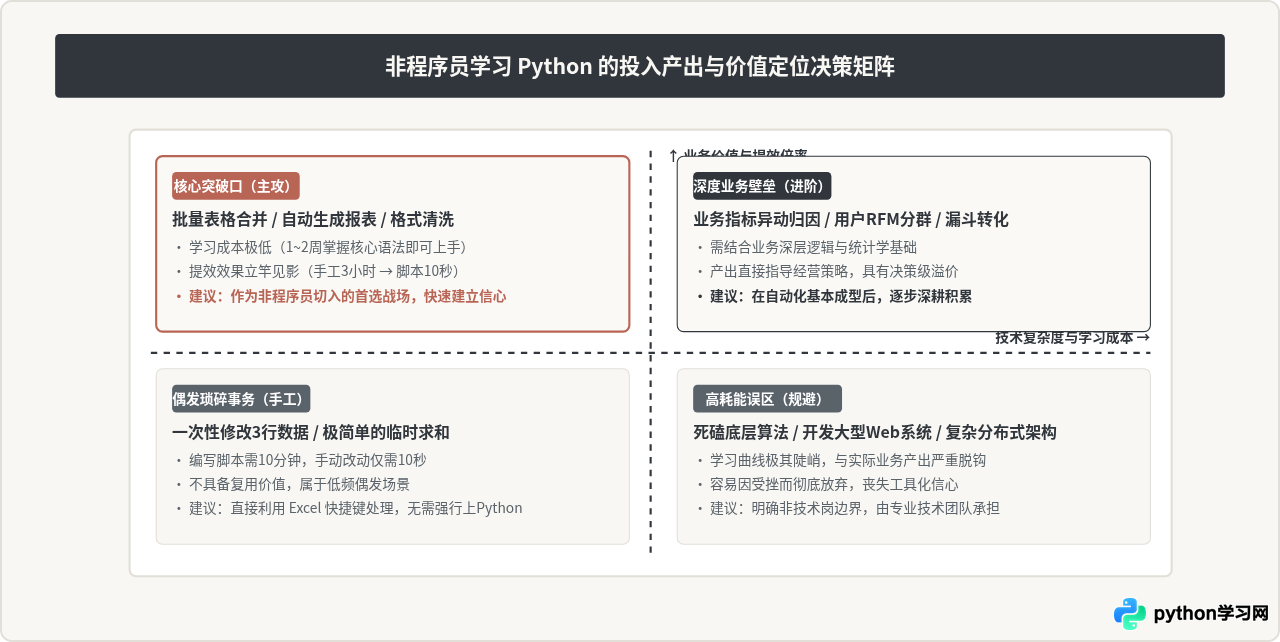
误区 2:为了写代码而写代码,忽视投入产出比
并非所有的工作都值得自动化。如果一项工作半年只出现一次,总共只需点击鼠标操作两分钟,花费三个小时去写脚本就属于过度工程化。评估是否自动化的标准是:该任务是否高频重复(每日/每周/每月)?规则是否明确稳定?手工操作是否有不可忽视的错误风险? 只有符合这些特征的任务,编写脚本才能获得超额的时间复利。
误区 3:忽视数据安全与原始底表保护
脚本批量修改文件的威力极大,一旦逻辑写错(例如没有加判断就执行覆盖写入),可能瞬间损毁全部文件。因此必须树立铁律:永远不要直接在原始文件上做覆盖操作(In-place Modification)。所有脚本读取的数据必须作为“只读”源文件,处理后的结果统一输出到新的文件夹或新的文件命名中,保留随时回溯核对的能力。
六、总结
对于非程序员而言,Python 从来不是一门用来炫耀底层技术的学科,而是一副为业务赋能的“外骨骼机甲”。从解决日常多表合并、自动汇总与格式排版起步,业务人员能够快速摆脱无休止的机械体力劳动;进而依托业务敏感度,运用轻量数据分析工具探寻业务增长点,完成从“执行层工具人”向“数据驱动决策者”的关键职业跨越。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









