

写Python爬虫前必读:robots.txt协议解析与法律合规边界
在编写任何网络数据爬虫脚本前,最关键的第一步并非配置请求头或解析HTML节点,而是明确目标站点的爬虫访问授权与法律合规红线。数据采集技术本身是中立的工具,但未经授权的大规模抓取、突破技术防线或商业转售,极易引发民事侵权乃至刑事责任。本文将系统拆解 robots.txt 协议的语法规则与匹配机制,展示如何使用 Python 标准库自动判定抓取权限,并对照分析技术约束与法律责任之间的实际边界,帮助开发者建立清晰的合规自查路径。
一、认识 robots.txt:爬虫与站长之间的技术倡导协议
robots.txt(全称为机器人排除协议,Robots Exclusion Protocol)是网站管理者用于声明搜索引擎蜘蛛及自动化抓取程序访问权限的文本文件。它必须存放在网站域名的根目录下,访问路径固定为 https://example.com/robots.txt。如果存放在子目录中(例如 /blog/robots.txt),主流爬虫均不予承认。
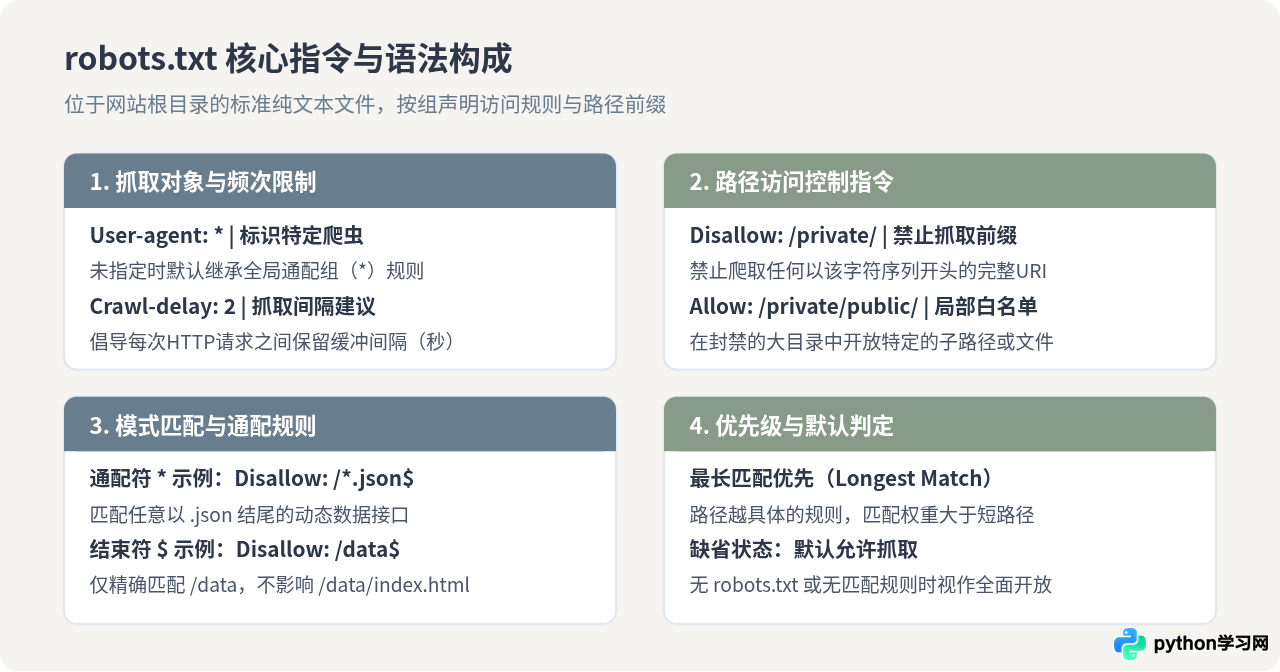
协议主要由若干字段组成,按组(Record)划分生效范围,核心指令包括:
- User-agent:指定该规则块适用的抓取客户端标识。使用
*表示匹配所有未单独列出的爬虫程序,也可以明确指定如Baiduspider、Googlebot或自定义的爬虫名称。 - Disallow:声明禁止访问的 URL 路径前缀。例如
Disallow: /admin/禁止爬取任何以/admin/开头的资源;若值为空(Disallow:),则表示允许访问所有路径。 - Allow:声明允许访问的具体子路径,通常用于在 Disallow 的大目录中开放特定只读资源,例如先声明
Disallow: /static/,再声明Allow: /static/public.css。 - Crawl-delay:倡导爬虫在两次连续请求之间休眠的秒数,用于防止过高并发导致目标服务器压力过载。
- Sitemap:提供网站 XML 格式的站点地图完整 URL,告知爬虫有效内容的索引入口。
在匹配规则上,协议采用前缀匹配与通配符机制:* 匹配任意字符序列,$ 匹配 URL 的结尾。当多条指令同时匹配一个 URL 时,通常遵循最长路径匹配原则(规则路径更长者优先级更高);若长度相同,Allow 优先于 Disallow。
二、在 Python 中标准解析 robots.txt:urllib.robotparser 实战
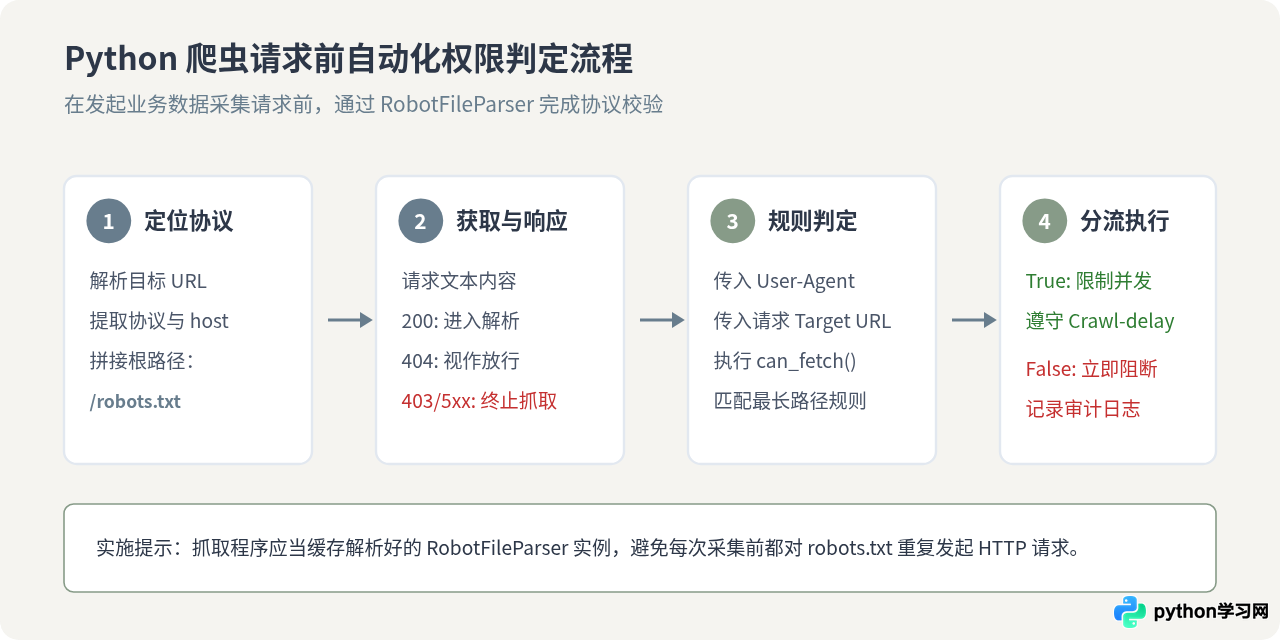
在 Python 中,不需要手动编写正则表达式拆解 robots.txt。Python 标准库自带了 urllib.robotparser 模块,提供了一套符合标准 RFC 规范的解析类 RobotFileParser。
通过该模块,程序可以在发起请求前完成自动化判定。以下是标准实现代码,包含异常捕获与抓取判定逻辑:
import urllib.robotparser
import urllib.error
from urllib.parse import urljoin

def check_crawler_permission(target_url: str, user_agent: str = "MyResearchBot") -> bool:
    """
    检查指定 URL 是否允许当前爬虫抓取
    """
    # 提取协议与域名,定位根目录 robots.txt
    from urllib.parse import urlparse
    parsed = urlparse(target_url)
    base_url = f"{parsed.scheme}://{parsed.netloc}"
    robots_url = urljoin(base_url, "/robots.txt")

    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)

    try:
        # 读取并解析远端 robots.txt 文件
        rp.read()
    except urllib.error.HTTPError as e:
        # 若返回 404/410 说明网站未设置限制,默认允许抓取
        if e.code in (404, 410):
            print(f"[{robots_url}] 返回 {e.code},视作允许抓取。")
            return True
        # 若返回 5xx 服务器错误,通常建议暂时停止抓取以示尊重
        elif 500 <= e.code < 600:
            print(f"[{robots_url}] 发生服务端错误 {e.code},建议推迟采集。")
            return False
        return False
    except urllib.error.URLError:
        print(f"无法连通 [{robots_url}],网络超时或连接失败。")
        return False

    # 判定当前 User-Agent 是否允许抓取目标 URL
    can_fetch = rp.can_fetch(user_agent, target_url)

    # 获取可选的爬取间隔
    rate = rp.crawl_delay(user_agent)
    if rate:
        print(f"目标站点针对 {user_agent} 建议的抓取间隔为 {rate} 秒。")

    return can_fetch

if __name__ == "__main__":
    # 示例测试
    test_target = "https://www.python.org/doc/"
    bot_name = "MyAuditBot/1.0"
    allowed = check_crawler_permission(test_target, bot_name)
    print(f"抓取权限判定结果: {'允许抓取' if allowed else '禁止抓取'}")
在实际工程中,需要特别注意网络容错与状态码映射规则:
- 404 Not Found:网站不存在该文件,协议默认为全站无抓取限制。
- 401 Unauthorized / 403 Forbidden:网站明确禁止读取规则文件,主流标准均视作全站禁止抓取。
- 5xx 内部错误:服务器暂时不可用,爬虫应当立即休眠或中断操作,不可直接当成“允许抓取”强行发起大流量请求。
三、两种典型情境对比:技术遵守与法律风险的关键差异
很多初学者容易产生一种危险的误解:“只要目标网站的 robots.txt 没有写 Disallow,或者我的爬虫严格遵循了 robots.txt,我的爬取行为就绝对合法”。为了清晰阐明这一关键认知误区,我们在相同的爬取主体和数据环境下对比两种典型情境:
| 对比维度 | 情境 A:遵循 robots.txt 但触犯法律边界 | 情境 B:网站未设 robots.txt 但涉及侵权 |
|---|---|---|
| 技术状态 | 目标路径未禁止(或属于 Allow),程序按协议正常请求 | 目标站点缺少 robots.txt 文件(返回 404) |
| 数据性质与行为 | 抓取平台全部商户评价、用户原创文章,打包用于商业竞品建设或付费 API 出售;高并发造成源站服务延迟 | 抓取用户注册信息、公开简历中的手机号、邮箱,或带有独创性且声明版权的图片资源 |
| 法律定性 | 构成不正当竞争 / 侵犯著作权:属于不当掠夺他人核心商业成果,并造成实质性替代或破坏服务器运营 | 侵犯个人信息权益 / 侵犯著作权:违反《个人信息保护法》,公开信息的使用仍不得违背个人明确意志或过度收集 |
| 关键启示 | robots.txt 仅是技术层的“君子协定”,不能作为商业侵权或服务破坏行为的豁免盾牌 | 技术未设防(无 robots.txt)绝不等于法律上的公开授权许可,数据权利归属仍受实体法保护 |
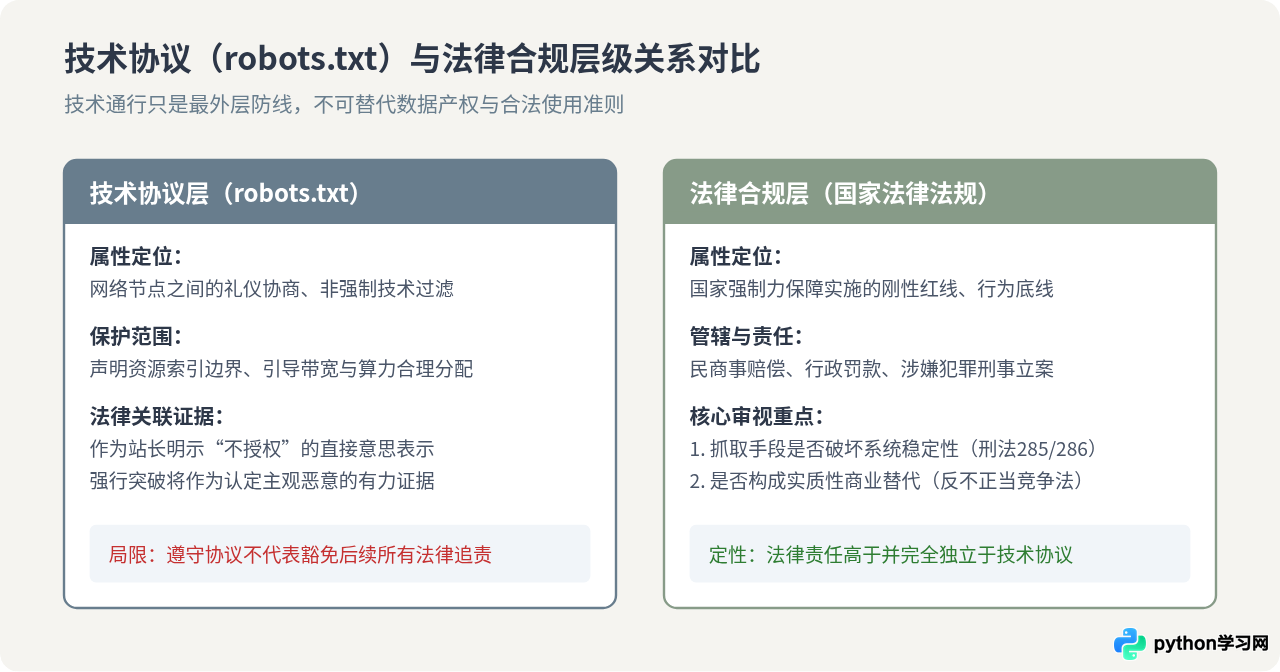
这一差异之所以至关重要,是因为法律评价与技术协议运行在完全不同的层级:
- robots.txt 的本质是自愿遵循的行业技术习惯。它并不具有直接的法定行政约束力,没有国家法律条文直接规定“违反 robots.txt 即构成违法”;
- 但 robots.txt 可以作为核心的司法事实证据。在不正当竞争或网络入侵侵权诉讼中,如果原告在 robots.txt 中明确声明了
Disallow,而被告爬虫修改 User-Agent 或强行抓取,法院将直接把此举认定为“被告主观上明知原告禁止访问、且恶意突破权利人意愿”,成为认定被告具有主观恶意和不正当竞争性质的关键证据。
四、爬虫开发者必须警惕的三大法律合规红线
在我国现行法律法规与司法判例体系中,爬虫开发涉及的主要法律风险集中在以下三个领域:
1. 刑事风险:《刑法》第二百八十五条与第二百八十六条
《刑法》第285条规定了“非法侵入计算机信息系统罪”与“非法获取计算机信息系统数据罪”。当网站部署了防爬机制(如登录鉴权、Token动态签名、验证码校验或频率限制)时,如果开发者通过逆向反编译、破解加密算法、撞库或者伪造身份等手段绕过技术防护,获取其后台非公开数据,极易被认定为“侵入”或“采用其他技术手段非法获取计算机信息系统数据”。
此外,若爬虫使用极端的高并发请求导致目标网站带宽耗尽、服务器宕机或正常业务中断,可能触犯第286条“破坏计算机信息系统罪”。因此,爬虫必须严格限制单秒并发与总请求频率。
2. 民事与反不正当竞争风险:《反不正当竞争法》第十二条(互联网专条)
在商业场景下,即使数据是公开可见的,也不意味着竞争对手可以全量抄袭。《反不正当竞争法》明确禁止经营者利用技术手段妨碍、破坏其他经营者合法提供的网络产品或者服务的正常运行。在“百度诉奇虎360违反Robots协议案”、“大众点评诉爱帮网案”等知名判例中,法院均确立了“实质性替代原则”与“不当获取原则”:如果爬取方把目标平台经过巨大商业投入沉淀的核心数据(如用户点评、真实房源、独家商品库)原封不动搬运至自己平台,直接分流了源站用户或造成商业替代,将构成不正当竞争,承担巨额经济赔偿。
3. 数据合规红线:《个人信息保护法》与《数据安全法》
爬虫一旦触及个人数据,必须格外审慎。即使个人信息(如社交账号、公开主页、求职简历)在网络上公开,根据《个人信息保护法》第二十七条,处理已公开的个人信息仍应在合理的范围内,且个人明确拒绝或侵害个人重大利益的除外。将批量抓取的公民个人信息用于精准画像、营销骚扰或转售牟利,属于严重的违法行为。
五、Python 爬虫合规四步落地检查清单
为确保爬虫项目的工程实现规范且合规,开发前应严格按照以下四个步骤逐项核对与落实:
- 目标与权限审视:定位目标 URL 的
/robots.txt,通过urllib.robotparser自动化验证权限。查看网站的用户服务协议(ToS),确认是否明确载有排他性禁止抓取条款。 - 技术礼仪与身份标识:在请求头
User-Agent中如实标注程序名称、版本以及管理员联系邮箱(例如MyAuditBot/1.0 (+http://example.com/bot; bot@example.com)),便于源站排查。严格限制请求并发,通常单 IP 单秒请求控制在 1~2 次以内,并根据返回的Retry-After或Crawl-delay动态调整休眠时间。 - 数据范围过滤与脱敏:在解析代码中实施数据清洗逻辑,严禁收集身份证号、手机号、家庭住址等敏感个人信息;对于带有著作权保护性质的长文、摄影作品或图表,避免全量镜像存储。
- 使用目的留痕与归档:严格限定采集数据的用途。如果是用于个人研究或内部数据分析,应将分析模型与源数据物理隔离;严禁将采集数据未经处理直接上架公开网站或向第三方打包变现。
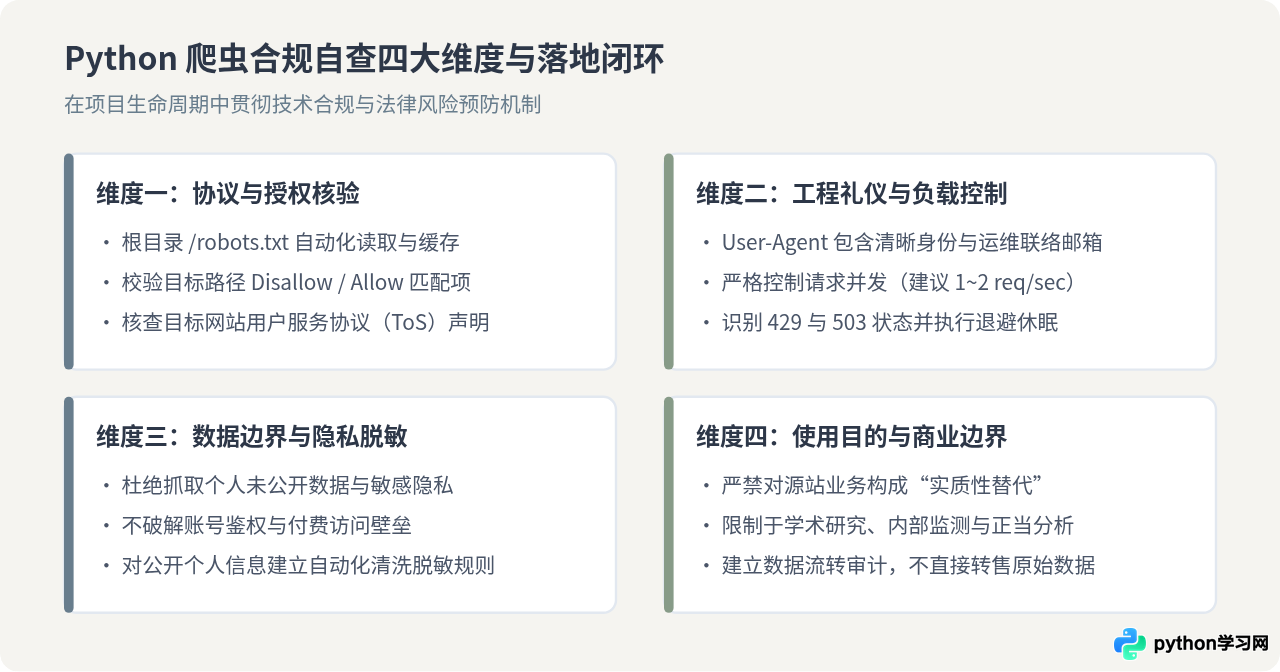
总结:编写网络爬虫不仅是一项关于网络协议、HTML解析与异步并发的技术活动,更是一项涉及数据资产权属与网络服务秩序的法律实践。技术上的“可实现”绝不等于法律上的“可允许”。在每写下一行请求代码前,主动校验 robots.txt,自觉保持对源站服务器的克制与礼让,严格划清数据使用的商业与隐私边界,才是每一个专业开发者持久前行的根本保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









