

从脚本到工程化:Python进阶必掌握的代码规范与设计模式

一、分水岭:单文件脚本思维与工程化架构的本质差异
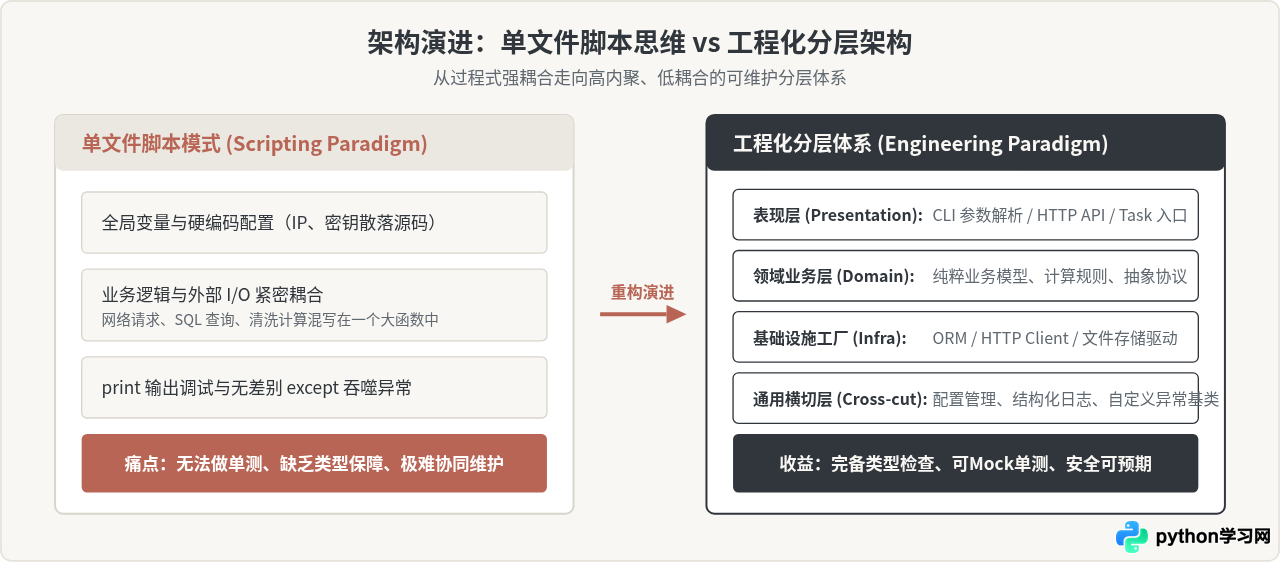
很多 Python 开发者在日常工作中积累了大量处理数据、自动化运维或爬取接口的 .py 脚本。这些脚本通常具备相同的初级特征:全局变量散落在各处、配置与业务逻辑硬编码在一起、通过 print() 观察执行过程、异常处理使用笼统的 except Exception: pass 掩盖故障。当脚本只需要执行一次或由作者本人单次调用时,这类实现能快速达成目标。
然而,一旦需求发生变动、业务逻辑增加分支,或者需要由团队多人协作维护与部署到线上服务环境时,脚本思维的局限性就会迅速暴露。工程化代码的核心目标不是追求“代码看起来更深奥”,而是保障系统的可预测性、可测试性、可扩展性与可维护性。其分水岭主要体现在三个维度:
- 职责边界清晰:工程化代码遵循单一职责原则,数据获取、核心计算、外部持久化与参数配置分别由独立的层级承载,杜绝混杂在主流程中。
- 防御性与可观测性:不再依赖控制台打印,而是通过明确的分级日志(Logging)与结构化异常体系记录系统行为,使线上排障有据可查。
- 依赖倒置与可测试性:核心业务逻辑不直接绑定具体的数据库连接或第三方网络请求库,而是依赖抽象契约,使得单元测试可以在脱离网络与实体数据库的环境下秒级运行。
二、现代代码规范与自动化质量防线
代码规范绝不仅仅是关于“代码排版好不好看”,更核心的价值在于消除由于动态弱约束导致的隐蔽运行时缺陷。Python 语言以灵活性著称,但如果缺少规范与静态类型约束,灵活就可能转化为维护灾难。
1. 全面落实现代类型提示(Type Hints)
自 Python 3.9 起,标准库原生支持通用类型(如 list[str]、dict[str, int]),不再强制依赖 typing.List。工程化项目中,所有公共函数、类方法以及关键中间变量必须完整标注输入与返回值类型。这不仅为 IDE 提供了精准的自动补全,更使得静态类型检查器能够在部署前截获 90% 以上的 AttributeError 与 TypeError。
2. 工具链现代化升级:Ruff 统一代码分析与格式化
过去 Python 社区通常需要分别配置 Flake8(语法检查)、Black(自动排版)、isort(导入排序)和 pyupgrade(语法升级)。多个工具不仅配置文件碎片化,而且在大型项目中执行速度较为迟缓。当前业内已广泛转向使用基于 Rust 开发的 Ruff,它实现了对 Black、Flake8 等工具的全套规则兼容,且执行速度提升数十倍。
3. 标准化配置:基于 pyproject.toml 集中管理
工程化项目应当将工具配置统一收纳于项目根目录的 pyproject.toml 中,避免根目录堆积多余的 .flake8、.black、setup.cfg 等遗留文件。以下是经过生产检验的标准工程配置示例:
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"

[project]
name = "data_pipeline"
version = "0.1.0"
authors = [{ name = "Engineering Team", email = "dev@example.com" }]
requires-python = ">=3.10"
dependencies = [
    "pydantic>=2.5.0",
    "httpx>=0.25.0",
]

[tool.ruff]
line-length = 88
target-version = "py310"

[tool.ruff.lint]
select = [
    "E",   # pycodestyle 错误
    "W",   # pycodestyle 警告
    "F",   # Pyflakes 代码逻辑问题
    "I",   # isort 导入排序
    "B",   # flake8-bugbear 常见代码缺陷
    "C4",  # flake8-comprehensions 列表推导优化
    "UP",  # pyupgrade 现代语法规范
]
ignore = ["E501"] # 单行超长由格式化器处理

[tool.mypy]
python_version = "3.10"
strict = true
warn_return_any = true
warn_unused_configs = true
disallow_untyped_defs = true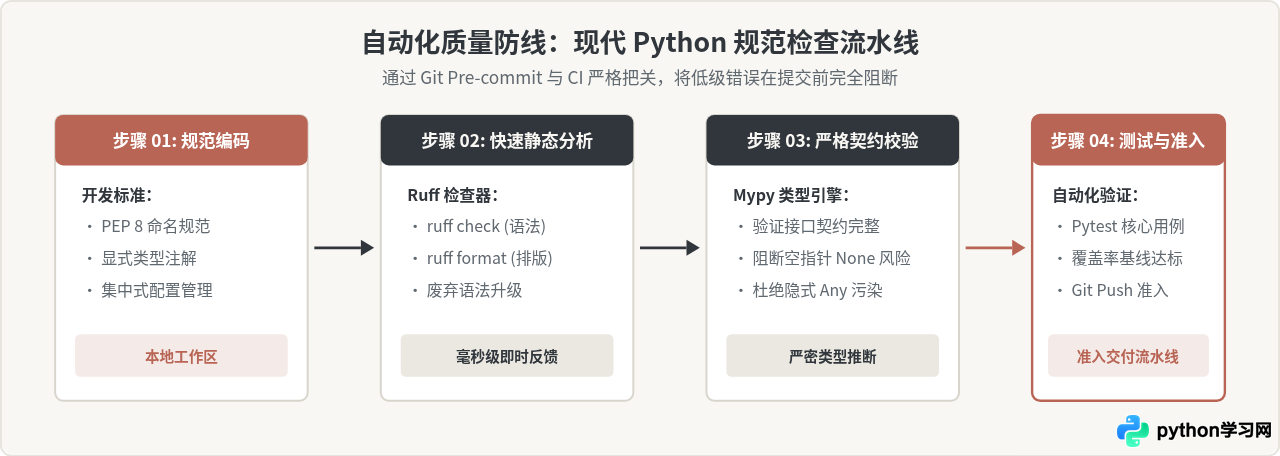
三、契合 Python 哲学的核心设计模式实战
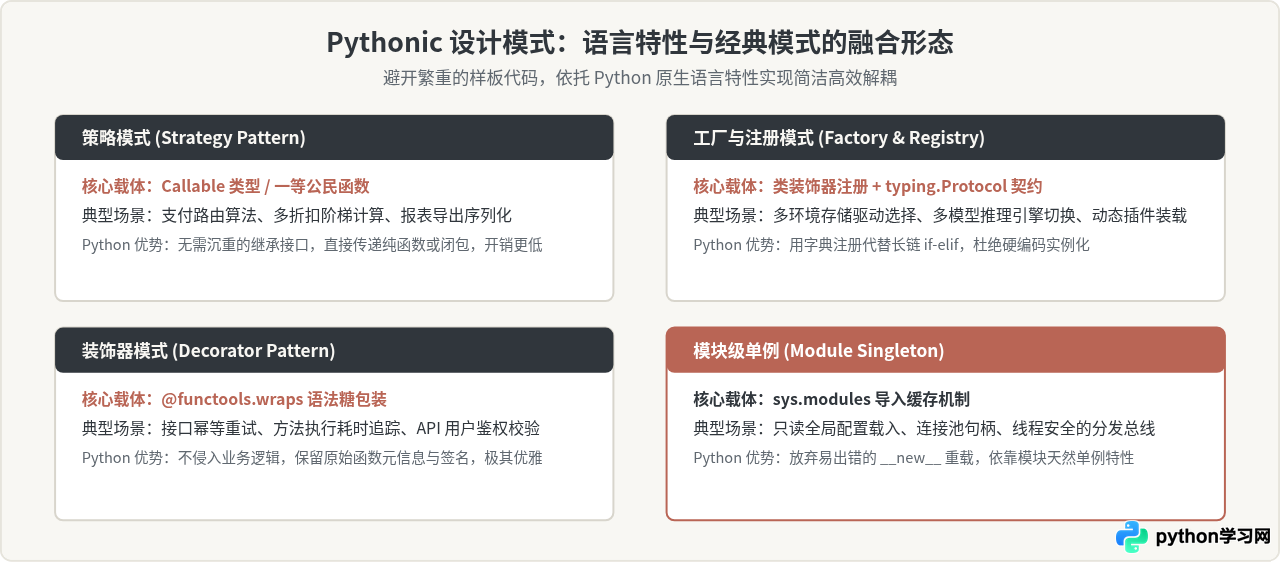
设计模式是面向对象工程经验的总结,但在很多静态面向对象语言(如 Java/C++)中形成的沉重模板,往往不适合直接套用在 Python 中。Python 具有动态类型、一等公民函数(First-class Functions)以及结构化子类型(Duck Typing / Protocol)等特性。因此,掌握设计模式的关键在于领会其解耦本质,并以 Pythonic 的方式简洁表达。
1. 单例模式(Singleton):优先选择模块级单例
在其他语言中,实现单例通常需要私有化构造函数并重载静态实例方法。在 Python 中,重写 __new__ 方法虽然可以实现单例,但在多线程并发初始化时容易隐藏细微 Bug。实际上,Python 的模块导入机制本身就是天然的线程安全单例。当一个模块首次被 import 时,解释器会执行该文件并将生成的对象缓存至 sys.modules 中,后续所有导入均直接复用同一引用。
# config.py (模块级单例实践)
from dataclasses import dataclass
import os

@dataclass(frozen=True)
class AppConfig:
    env: str
    db_url: str
    timeout: int

# 模块加载时完成唯一实例初始化
settings = AppConfig(
    env=os.getenv("APP_ENV", "production"),
    db_url=os.getenv("DATABASE_URL", "sqlite:///prod.db"),
    timeout=int(os.getenv("TIMEOUT_SECONDS", "30")),
)

# 其他模块使用时直接导入
# from config import settings
2. 工厂模式与 Protocol 结构化子类型
在单文件脚本中,我们常常见到大量的 if-elif-else 语句用于根据参数决定创建哪个客户端。当新增第三方集成时,必须不断修改原有函数,违反开闭原则(OCP)。
工程化推荐的做法是:利用 Python 3.8+ 的 typing.Protocol 定义结构化接口契约,无需继承,只要求行为一致;并通过工厂字典注册机制动态解耦实例化逻辑:
from typing import Protocol, Type
from abc import abstractmethod

class StorageDriver(Protocol):
    """存储抽象契约:只要实现了这些方法的类均视作符合协议"""
    def save(self, path: str, content: bytes) -> bool:
        ...

class LocalDiskStorage:
    def save(self, path: str, content: bytes) -> bool:
        # 本地写盘逻辑
        return True

class S3CloudStorage:
    def save(self, path: str, content: bytes) -> bool:
        # S3 上传逻辑
        return True

class StorageFactory:
    """可扩展的注册式驱动工厂"""
    _drivers: dict[str, Type[StorageDriver]] = {}

    @classmethod
    def register(cls, name: str, driver_cls: Type[StorageDriver]) -> None:
        cls._drivers[name] = driver_cls

    @classmethod
    def create(cls, name: str) -> StorageDriver:
        driver = cls._drivers.get(name)
        if not driver:
            raise ValueError(f"未支持的存储驱动类型: {name}")
        return driver()

# 驱动注册
StorageFactory.register("local", LocalDiskStorage)
StorageFactory.register("s3", S3CloudStorage)
3. 策略模式(Strategy):函数作为一等公民
在传统面向对象设计中,策略模式需要定义抽象策略基类与多个具体的策略子类。但在 Python 中,函数是第一类对象,可以作为变量传递与返回。因此,策略模式在 Python 中最优雅的实现形态就是接受符合签名的 Callable 对象,完全不需要繁冗的类继承:
from typing import Callable

# 定义策略签名:接收原始金额,返回折后金额
DiscountStrategy = Callable[[float], float]

def regular_discount(price: float) -> float:
    return price

def vip_discount(price: float) -> float:
    return price * 0.85

def promotional_discount(price: float) -> float:
    return max(0.0, price - 50.0)

class OrderProcessor:
    def __init__(self, discount_strategy: DiscountStrategy) -> None:
        self.discount_strategy = discount_strategy

    def calculate_total(self, original_price: float) -> float:
        # 运行时调用注入的具体计算策略
        return self.discount_strategy(original_price)
4. 装饰器模式(Decorator):非侵入式横切关注点
工程项目中,诸如调用耗时统计、接口自动重试、权限校验等横切逻辑,严禁直接硬编码散落在业务函数体内。通过 Python 的装饰器语法糖,可以实现高度纯粹的装饰器模式,且必须使用 functools.wraps 保持原始函数元信息完整。
四、演进实战:单文件脚本重构为工程化包的四步法
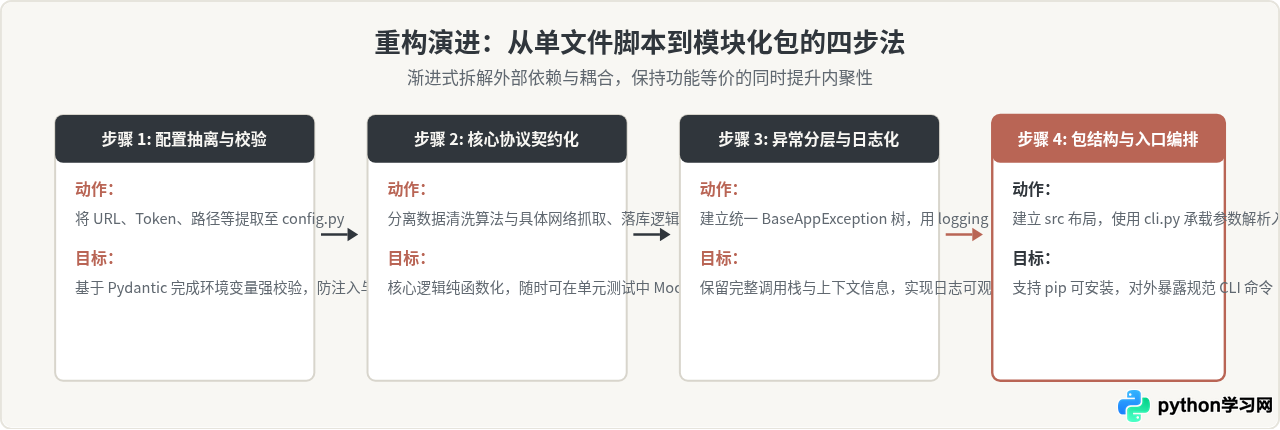
假设我们有一个初级数据抓取并保存的脚本 sync_data.py,其全部逻辑混在一个 100 行的文件内。我们通过明确的四步操作,将其重构为生产级可维护模块。
实战步骤说明与代码重构示范
不要在业务服务类内部直接实例化底层的网络 Client 或数据库链接。将依赖项通过 __init__ 参数传入,让调用方决定使用真实实现还是用于测试的假数据桩(Mock/Stub)。
重构后的目录结构推荐采用标准的 src 布局:
project_root/
├── pyproject.toml
├── README.md
├── src/
│   └── data_sync/
│       ├── __init__.py
│       ├── config.py       # 步骤1: 强类型配置
│       ├── exceptions.py   # 步骤3: 统一业务异常
│       ├── protocols.py    # 步骤2: 接口契约
│       ├── client.py       # 基础设施: 网络访问具体实现
│       ├── service.py      # 核心领域: 数据处理业务逻辑
│       └── cli.py          # 步骤4: 命令行参数入口
└── tests/
    ├── test_service.py     # 秒级执行的单元测试
    └── test_client.py
以下是 service.py 中重构后的核心服务实现,展示了依赖注入与错误处理的结合:
import logging
from dataclasses import dataclass
from data_sync.protocols import StorageDriver, DataFetcher
from data_sync.exceptions import DataSyncProcessingError

logger = logging.getLogger(__name__)

@dataclass
class CleanedRecord:
    record_id: str
    normalized_value: float

class DataSyncService:
    """业务服务核心:只依赖接口契约,不与具体的网络库或文件系统耦合"""
    def __init__(self, fetcher: DataFetcher, storage: StorageDriver) -> None:
        self._fetcher = fetcher
        self._storage = storage

    def execute_sync(self, source_url: str, dest_path: str) -> int:
        logger.info("开始执行数据同步流程", extra={"url": source_url})
        raw_items = self._fetcher.fetch_all(source_url)

        cleaned_records: list[CleanedRecord] = []
        for item in raw_items:
            try:
                # 纯粹的数据清洗计算
                norm_val = float(item["amount"]) * 1.05
                cleaned_records.append(
                    CleanedRecord(record_id=str(item["id"]), normalized_value=norm_val)
                )
            except (KeyError, ValueError) as err:
                logger.warning("跳过异常数据项: %s, 原因: %s", item, err)
                continue

        if not cleaned_records:
            raise DataSyncProcessingError("未能清洗出有效记录,终止持久化流程")

        payload = "\n".join(f"{r.record_id}:{r.normalized_value}" for r in cleaned_records).encode()
        self._storage.save(dest_path, payload)

        logger.info("同步流程圆满完成,落盘记录数: %d", len(cleaned_records))
        return len(cleaned_records)
五、工程化进阶自查清单与常见反模式
进入工程化阶段后,开发者需要建立持续自查的习惯。下表总结了工业级 Python 项目在日常评审中必须核查的核心标准:
| 评估维度 | 及格线(初级工程化) | 优秀线(成熟生产级) | 需警惕的反模式 |
|---|---|---|---|
| 代码规范 | 通过 PEP 8 检查,无多余未引用变量 | 通过 Ruff 全量规则,格式与导入完全自动化 | 手动在 IDE 中调整缩进,提交大面积无意义排版 Diff |
| 类型安全 | 公共函数带有基础入参和返回值注解 | Mypy 严格模式全绿,泛型与 Protocol 契约严密 | 滥用 Any 或 # type: ignore 掩盖类型问题 |
| 依赖管理 | 提供 requirements.txt 并固定版本 | 基于 pyproject.toml 声明,分环境锁定依赖哈希 | 直接在服务器上 pip install 未锁版本的包 |
| 异常与日志 | 使用 logging 模块打印关键节点日志 | 结构化日志,自带 TraceID;定制有继承关系的异常树 | 使用 except: pass 吞掉未知崩溃,日志中堆满 print |
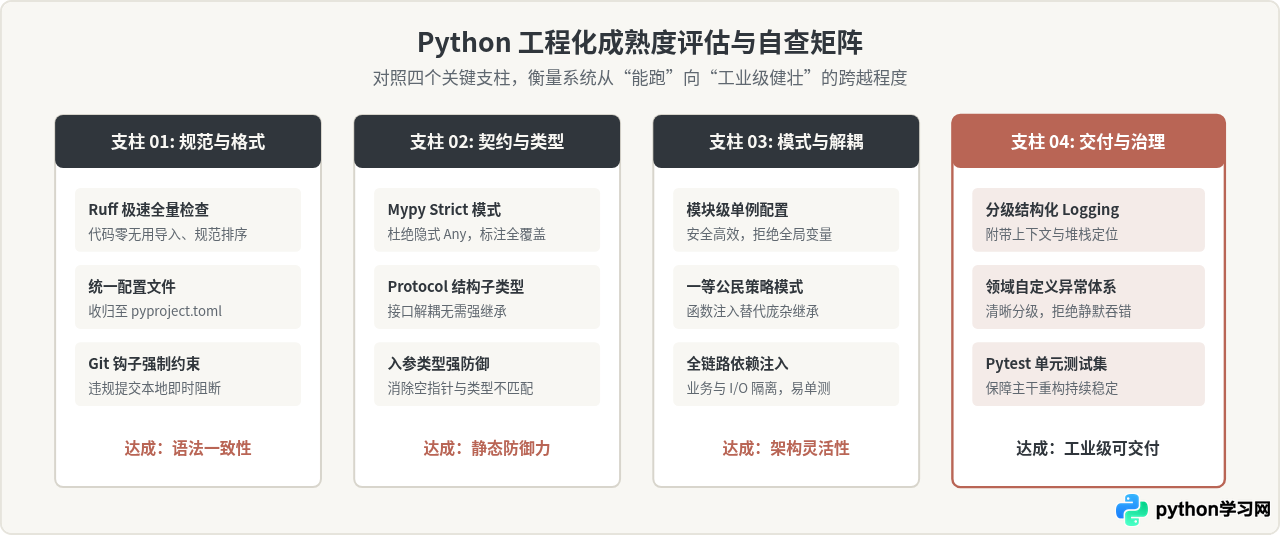
从脚本到工程化的进阶,不是一次性的形式翻新,而是一场编码思维的转变。通过将规范检查委托给现代静态工具链,把架构解耦交给符合 Python 特性的设计模式,开发者能够将更多的精力聚焦于核心业务逻辑的推演与创新,编写出经得起生产环境与团队协作长期考验的高质量系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









