

Python科学计算库怎么选:math、NumPy、SciPy与SymPy对比
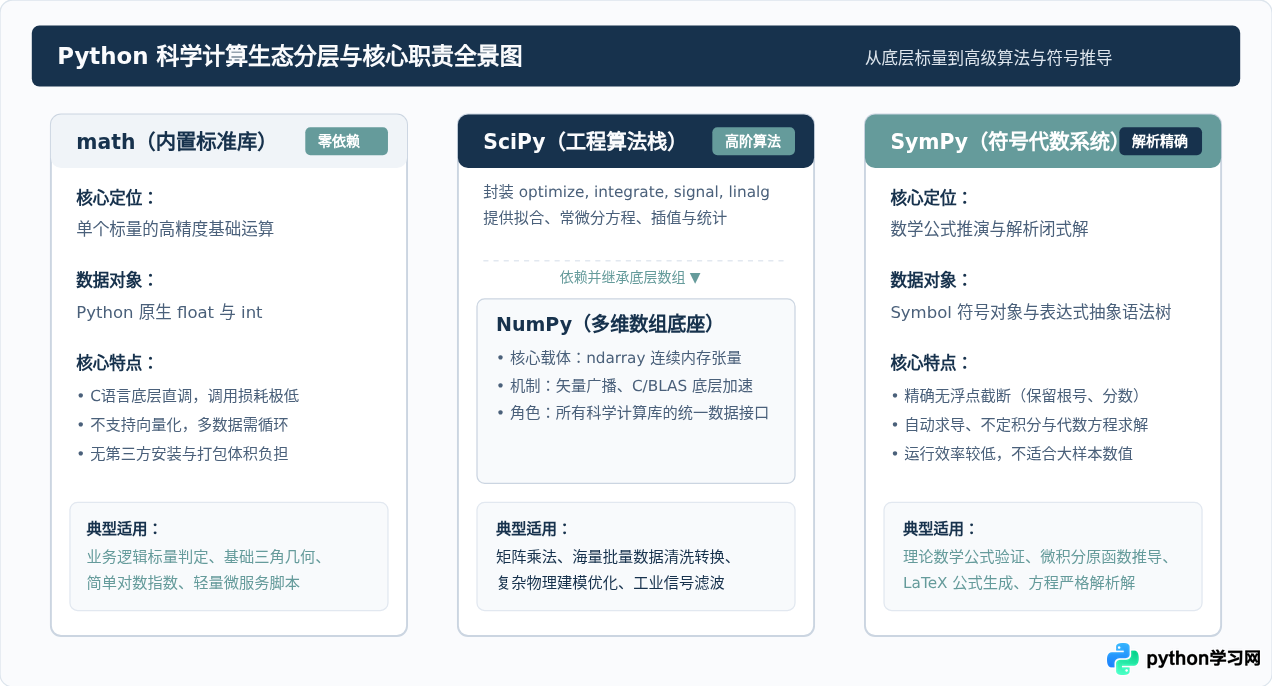
math 专攻轻量标量计算,零依赖且无启动开销;NumPy 是多维数组与矢量化计算的基础底座;SciPy 建立在NumPy之上,提供数值积分、优化寻优和信号处理等高级工程算法;SymPy 则是符号代数系统,用于精确解析推导与公式化简。实际工程开发中,它们不是互斥的单选项,而是在不同计算环节各司其职的协同工具。
一、四库核心定位与分层架构
很多初学者在面对数学计算需求时,常常困惑于何时该引入外部依赖,何时该坚持原生写法。理解这四个库的本质差别,首先要看它们在Python科学计算生态中的分层定位与数据承载形式。
math 是Python的内置标准库,它直接映射了C语言标准数学库(libm),只针对Python原生的 int 和 float 单个标量数据工作。只要你不需要矩阵操作,只求两点欧氏距离、开方或三角函数,math 就是速度最快、内存开销最小的选择。
NumPy 则引入了核心数据结构 ndarray。它在连续内存块中存储同构数据,并通过底层C/Fortran实现的线性代数库(如OpenBLAS或MKL)提供SIMD向量化加速。它是Python整个数据分析与机器学习生态的绝对基石。
SciPy 不重新发明数组结构,而是完全基于 NumPy 构建。它专注于高阶应用算法,将经典数值分析方法按子模块组织,如最优化(scipy.optimize)、数值微积分(scipy.integrate)、信号处理(scipy.signal)等,解决的是“算法工程化”问题。
SymPy 走的是截然不同的“符号代数(CAS)”路线。它的核心对象不是数字,而是数学符号(如符号变量 x、表达式树 sin(x) + cos(x))。它的目标不是求出近似的浮点数值,而是像数学家手算一样,推导解析通解、化简公式、计算精确分数与极限。
二、选型决策树:按问题属性精准定位
很多工程失误源于在错误阶段使用了不恰当的工具。例如:在需要进行100万次快速求值的循环里使用 SymPy 导致耗时飙升数十秒;或者在计算两个简单数字的正弦值时专门引入 NumPy 带来额外的内存开销与依赖包袱。
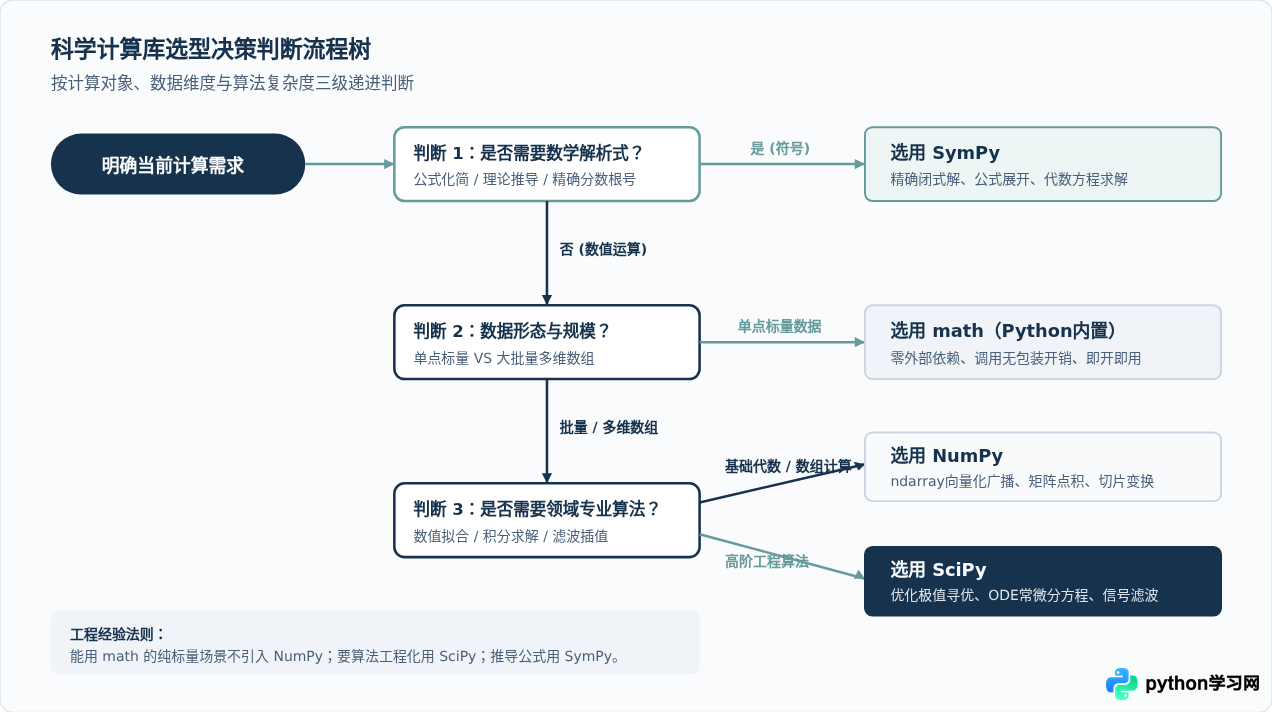
根据具体的工程要求,可以遵循下面的判断顺序快速锁定库选择:
- 看计算目标是“解析公式”还是“数值结果”:如果你需要得到形如
x^2 + 2x的导函数解析式,或者要求出方程的精确代数根(如\sqrt{2}而非1.41421356...),直接选SymPy。 - 看数据组织形式是“标量”还是“批量数组”:如果计算发生在单一输入点,且不涉及复杂的线性代数运算,直接使用标准库
math;如果有成千上万个数据点需要相同的计算逻辑,必须选NumPy的向量化操作。 - 看算法需求是“基础矩阵计算”还是“高级工程领域求解”:如果只是做矩阵相乘、转置、分块、广播乘加,
NumPy足矣;若需要求解复杂的非线性常微分方程(ODE)、执行曲线拟合、或者调用Butterworth滤波器,应该直接进入SciPy。
三、核心维度横向对比矩阵
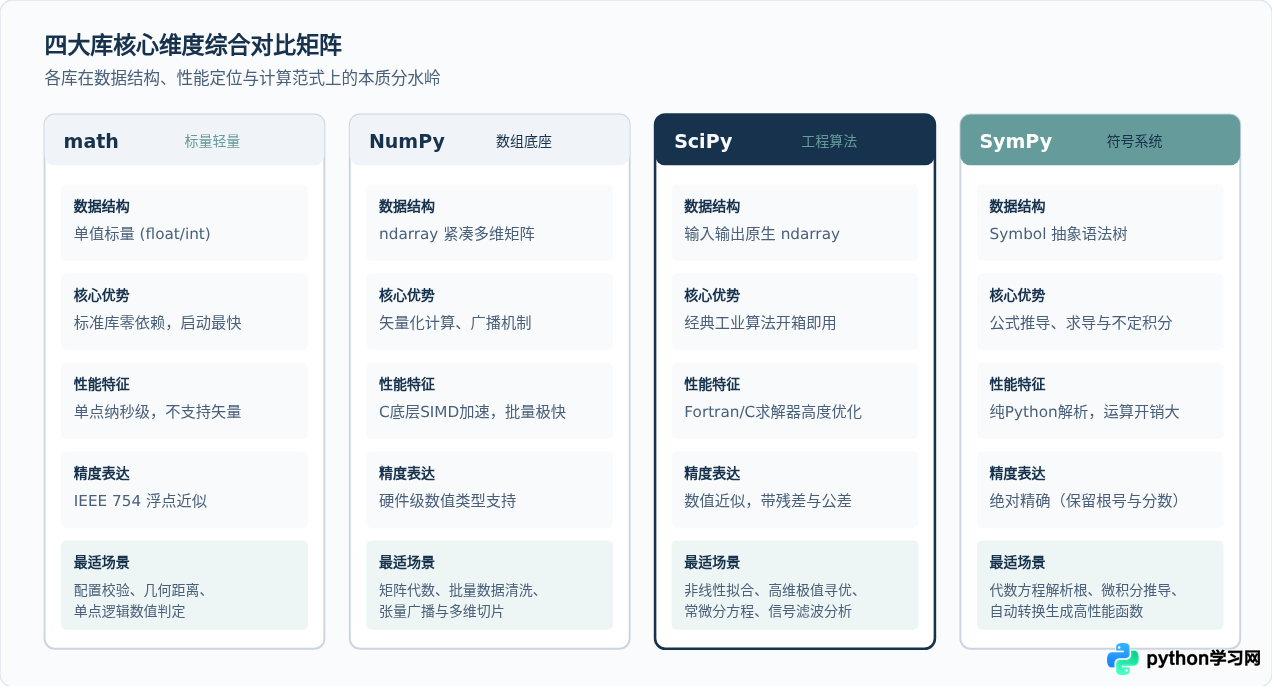
为了更直观地理解四个库在工程实践中的表现差异,下表汇总了从底层机制到运行特性的核心指标:
| 对比维度 | math | NumPy | SciPy | SymPy |
|---|---|---|---|---|
| 库性质与依赖 | 标准库,零外部依赖 | 第三方包,底层C/BLAS | 第三方包,强依赖NumPy | 第三方包,纯Python实现 |
| 基本数据对象 | 原生 int / float |
ndarray(连续多维数组) |
基于 ndarray 的算法封装 |
Symbol / 表达式树 |
| 计算机制 | 标量逐个执行 | SIMD向量化、无循环广播 | 经典数值算法求解器 | 模式匹配、符号树递归化简 |
| 执行速度与开销 | 标量单次执行最快(微秒) | 大批量数据极快;标量有包装开销 | 高维/复杂算法效率极高 | 运行较慢,算力消耗大 |
| 计算精度范式 | IEEE 754 双精度浮点 | 支持多种定长浮点/整数类型 | 数值近似收敛精度控制 | 解析精确(分数、根号原样保留) |
| 典型核心函数 | sin, sqrt, log |
array, dot, linspace |
optimize.minimize, quad |
symbols, diff, integrate |
四、代码实战:同一问题的不同实现风格
为了加深理解,我们来看同一个具体数学任务——计算函数 f(x) = \sin(x) + x^2 在 x = \pi/4 处的值与导数,四个库呈现出完全不同的实现思路:
1. 使用 math:手动推导导数后进行标量求值
import math

# math 只能做数值求值,必须人工推导其导数 f'(x) = cos(x) + 2x
x_val = math.pi / 4

# 计算函数值
val = math.sin(x_val) + x_val ** 2

# 计算导数值
diff_val = math.cos(x_val) + 2 * x_val

print(f"[math] 函数值: {val:.6f}, 导数值: {diff_val:.6f}")
# 运行输出:[math] 函数值: 1.723829, 导数值: 2.277896
2. 使用 NumPy:对批量离散网格点进行向量化计算
import numpy as np

# 一次性生成 1000 个采样点,进行全量向量化运算
x_arr = np.linspace(0, np.pi, 1000)
f_arr = np.sin(x_arr) + x_arr ** 2

# 通过有限差分近似求整个区间的导数数组
df_arr = np.gradient(f_arr, x_arr)

# 取 pi/4 附近点的导数近似值
idx = np.abs(x_arr - np.pi / 4).argmin()
print(f"[NumPy] pi/4 处数值导数近似: {df_arr[idx]:.6f}")
# 运行输出:[NumPy] pi/4 处数值导数近似: 2.277899
3. 使用 SciPy:自动进行数值导数计算与极值优化
from scipy.misc import derivative
import numpy as np

def f(x):
    return np.sin(x) + x ** 2

# SciPy 使用高阶中心差分算法,免去手动推导或构建网格的繁琐
diff_scipy = derivative(f, np.pi / 4, dx=1e-6)

print(f"[SciPy] 自动数值微分结果: {diff_scipy:.6f}")
# 运行输出:[SciPy] 自动数值微分结果: 2.277896
4. 使用 SymPy:全自动符号求导并保留精确解析式
import sympy as sp

# 声明符号变量
x = sp.Symbol('x')
f_expr = sp.sin(x) + x ** 2

# 解析求导:得到真正的代数表达式 cos(x) + 2*x
df_expr = sp.diff(f_expr, x)
print(f"[SymPy] 解析导函数公式: {df_expr}")

# 精确代入 pi/4(保留精确符号形式)
exact_val = df_expr.subs(x, sp.pi / 4)
print(f"[SymPy] 精确解析解: {exact_val}")

# 按需转换为浮点数
print(f"[SymPy] 浮点近似: {exact_val.evalf():.6f}")
# 运行输出:
# [SymPy] 解析导函数公式: 2*x + cos(x)
# [SymPy] 精确解析解: sqrt(2)/2 + pi/2
# [SymPy] 浮点近似: 2.277896
五、工程闭环:多库协同最佳实践
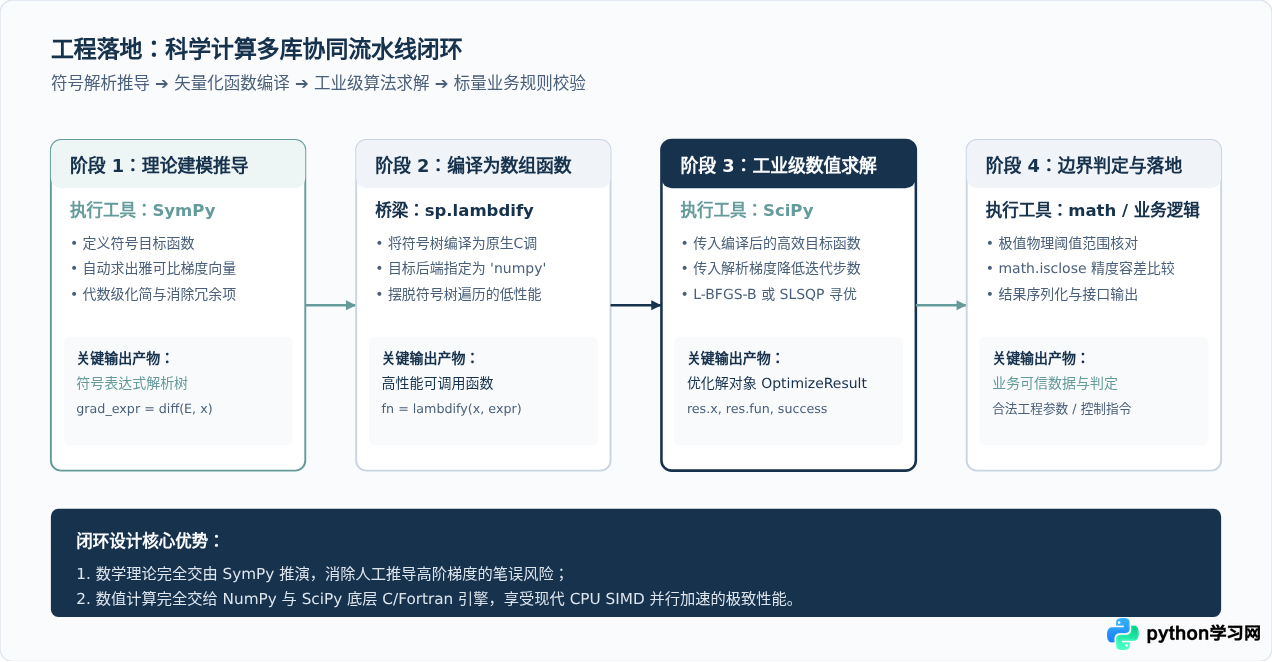
在严肃的科学研究和工程项目中,我们很少孤立地使用某一个库,而是将它们的优势组合起来构建闭环。其中最经典且高效的工作流是:SymPy推导解析公式 ➔ lambdify编译为NumPy函数 ➔ SciPy进行大规模优化寻优。
这种配合避免了人类手工推导复杂高维导数极易出错的问题,同时规避了SymPy计算速度慢的短板,让最终计算完全运行在C底层的SIMD矩阵引擎上。
六、常见误区与避坑指南
NumPy 的性能优势源自批量向量化计算和底层连续内存的批量读取。如果你只是在业务中做单次判断(如 np.sqrt(a**2 + b**2)),NumPy 在把Python标量包装为 numpy.float64 对象并进行类型分发时产生的开销,反而比原生标准库 math.sqrt 慢 3 到 5 倍。单点标量计算优先保留 math。
SymPy 的 subs() 和 evalf() 必须递归遍历符号语法树并执行模式替换,单次替换耗时在毫秒级。若拿它遍历 10 万个样本点,程序将直接卡死数分钟。正确做法:使用 sympy.lambdify(x, expr, 'numpy') 将符号表达式预先编译为NumPy函数,再传入整个数组一次性计算,耗时仅需数毫秒。
使用 scipy.integrate.quad 或 scipy.optimize.minimize 时,传递的目标函数如果内部包含了高开销的 Python for 循环,将严重阻碍底层 C 求解器的迭代速度。尽可能确保回调函数内部完全使用 NumPy 数组运算或已经向量化的数学表达式。
七、总结清单
回顾四者的定位,可以总结为四句口诀:
- 单值标量无依赖,首选原生 math;
- 多维批量搞矩阵,底座必须 NumPy;
- 高阶工程求算法,开箱即用 SciPy;
- 精确公式要推导,全能解析 SymPy。
结合具体的输入数据形态、性能敏感度与是否需要解析推导,你就能在架构设计与日常编码中做出清晰、合理且高效的库选型决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









