

学术研究用R还是工程部署用Python?基于任务场景的语言选择指南
一、底层诉求解构:学术探索与工程落地的核心分歧
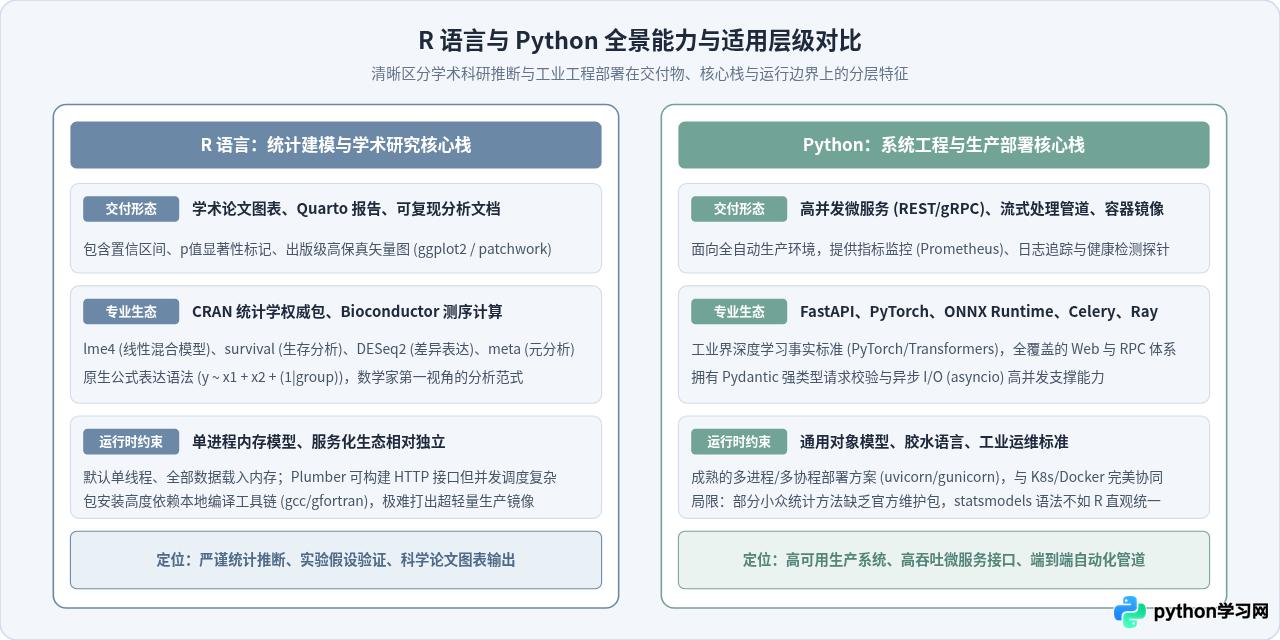
学术研究与工程部署代表了数据处理生命周期中两个截然不同的阶段。理解这两种场景的本质差异,是避免技术选型踩坑的前提。
在学术科研场景下,核心目标是“发现事实与严谨验证”。研究人员高度关注假设检验的置信区间、混合效应回归的残差诊断、高维生物测序数据的差异表达分析,以及图形是否符合顶级期刊的出版要求。在此类任务中,数据量通常为中小型表格数据(可完全装入单机内存),交互式探索(REPL)体验和统计理论的数学实现精度高于一切。
在工程部署场景下,核心目标转变为“高可用、低延迟与系统可维护性”。工程师需要考虑服务并发QPS、输入参数严格校验、分布式追踪、跨团队接口契约(API Contract)、Docker容器尺寸优化以及CI/CD自动化测试。此时,算法的数学前沿性往往需要让位于系统稳健性与吞吐量。
二、关键任务场景横向对比与选型判断
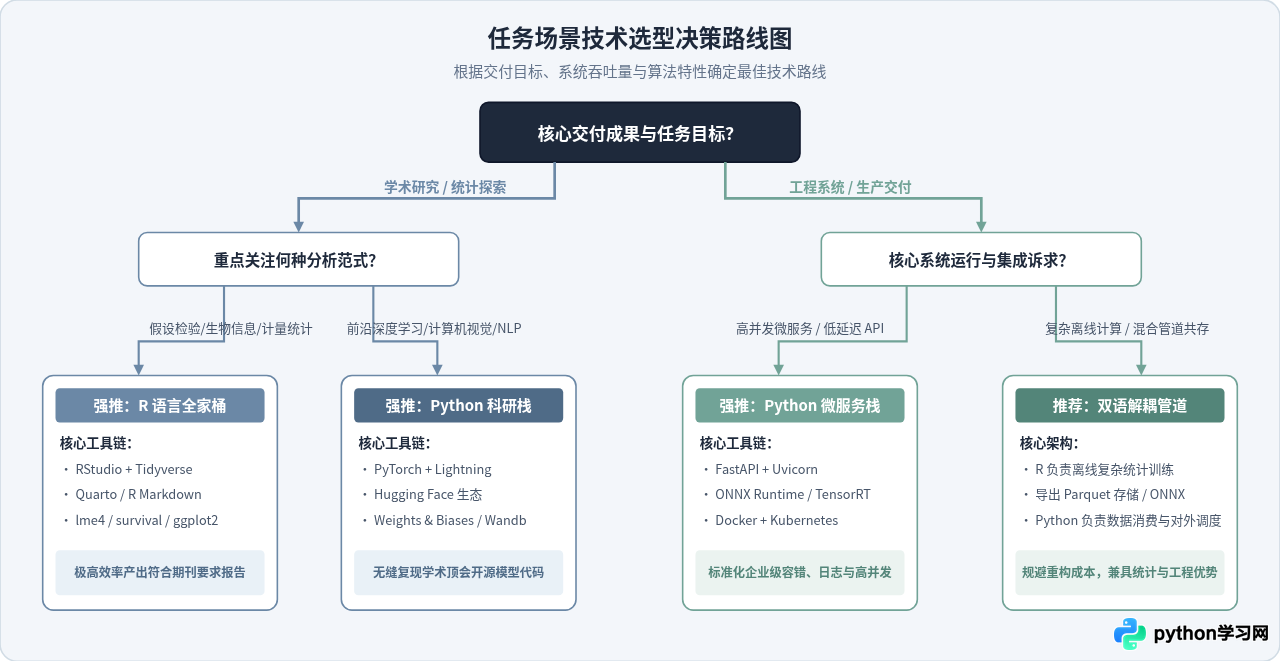
为了让选型逻辑切实落地,我们梳理了科研与工业界最典型的四类任务场景,分析各自在两种语言下的实现体验与技术代价。
场景 1:生物医学统计、生存分析与小样本试验设计
在临床试验、流行病学调查或生物信息学测序分析中,研究者不仅需要拟合模型,还需要完整的危险比(Hazard Ratio)、95% 置信区间、方差分析(ANOVA)表以及符合 FDA/同行评议标准的统计诊断输出。
- R 的优势:原生提供了极简且严谨的公式接口。调用
survival::coxph()或lme4::lmer()即可直接输出标准显著性检验。CRAN 上每个包的更新都受到严格的向前兼容测试。 - Python 的局限:Python 中的
lifelines或statsmodels虽能完成基础拟合,但在复杂多层嵌套随机效应、事后多重比较校正(Post-hoc tests)及特殊分布族支持上,API 分散且维护活跃度参差不齐。 - 建议结论:果断选 R。在该领域使用 Python 往往需要自己额外编写大量统计量计算与格式化逻辑。
场景 2:前沿深度学习、大语言模型与多模态开发
涉及神经网络结构探索、视觉识别、大模型微调(Fine-tuning)或检索增强生成(RAG)。
- Python 的优势:PyTorch、TensorFlow、Hugging Face Transformers、vLLM 等前沿框架均以 Python 为第一宿主语言。几乎所有最新开源论文模型都在第一时间放出 Python 代码。CUDA 硬件加速、量化库(bitsandbytes)与分布式训练(DeepSpeed)生态完全建立在 Python 之上。
- R 的局限:虽然 R 提供了
torch原生绑定或基于reticulate封装的 Keras,但在分布式显存管理、自定义算子扩展及前沿模型权重加载上存在严重滞后。 - 建议结论:绝对选择 Python。这是深度学习领域的工业与学术统一标准。
场景 3:在线实时推理服务(微服务化部署)
需要将训练好的分类、回归或预测模型接入业务系统,接受 HTTP/gRPC 请求并在数十毫秒内返回预测结果。
- Python 的优势:通过
FastAPI与Uvicorn,可以轻而易举地搭建异步高并发微服务;配合Pydantic完成自动参数验证和 OpenAPI 文档生成;使用Docker可构建极小尺寸的 Linux 生产容器,并轻松配置探针、链路追踪和集中日志。 - R 的局限:R 的
Plumber可以生成 REST API,但底层为单进程单线程模型。应对并发时需要借助外部进程管理器(如 PM2)或多容器反向代理,内存开销大且排查并发锁死困难;同时 R 环境在 Alpine Linux 等轻量基础镜像中编译极为繁琐。 - 建议结论:首选 Python。如果模型最初在 R 中训练,建议导出参数或转为开放格式,由 Python 服务承载对外接口。
场景 4:探索性数据分析(EDA)与自动化业务报表
面向业务部门或管理层,定期输出包含交互式图表、统计推断摘要与排版精良的数据分析报告。
- R 的优势:
Tidyverse系列(dplyr,tidyr,ggplot2)拥有业内设计最统一的数据规整语法。结合Quarto(或传统 R Markdown),可以一条命令渲染出包含代码、文本、矢量图、LaTeX 公式的高品质 PDF 或 HTML 报告。 - Python 的体验:
Pandas语法相对冗长且多处索引行为容易引起混淆,Jupyter Notebook适合阶段性探索,但转为规范出版排版时配置门槛显著高于 Quarto。 - 建议结论:单人或小团队进行纯离线报告撰写时,R 的人效更高;若报告需要直接从微服务数据库管道自动化触发并推送到运维监控大屏,Python 更易集成。
三、落地实操:从科研原型到工程部署的四步改造法
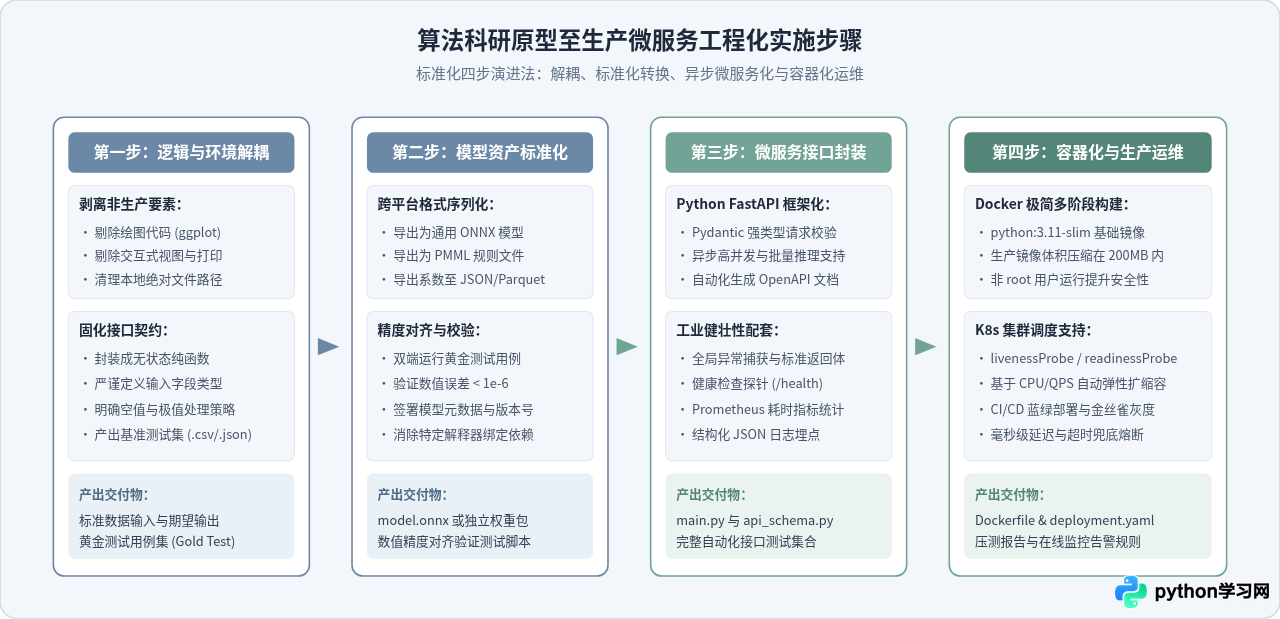
当科研团队在 R 中验证了算法逻辑,而工程团队需要将其发布为企业级服务时,盲目“全盘重写”或“简单粗暴用 R 直接接对外流量”往往会引发灾难。标准工程化迁移流程包括四个严谨阶段:
代码对照:原型验证与服务化封装的具体差异
为了直观体会两者的代码组织逻辑,我们以一个标准的风险预测模型为例:在科研探索中,研究人员关注的是公式表达与系数检验;而在生产接口中,工程师关注的是参数契约、类型容错与服务性能。
# R 语言环境:执行模型训练与诊断分析
library(survival)

# 读取临床随访数据
clinical_data <- read.csv("clinical_trial.csv")

# 拟合 Cox 比例风险回归模型
cox_model <- coxph(Surv(time, status) ~ age + biomarker_a + treatment_group, data = clinical_data)

# 打印完整的学术统计学摘要(含 p 值、置信区间、似然比检验)
summary(cox_model)

# 提取关键风险比(Hazard Ratio)用于论文写作
hr_table <- data.frame(
  Feature = names(coef(cox_model)),
  HR = exp(coef(cox_model)),
  CI_Lower = exp(confint(cox_model))[, 1],
  CI_Upper = exp(confint(cox_model))[, 2],
  P_Value = coef(summary(cox_model))[, 5]
)
print(hr_table)# Python 3.11 环境:使用 FastAPI 与 ONNX Runtime 进行微服务化封装
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
import numpy as np
import onnxruntime as ort
app = FastAPI(title="Risk Scoring Inference Service", version="1.0.0")
# 启动时加载模型资产,避免单次请求重复 IO
session = ort.InferenceSession("models/risk_model.onnx")
# 定义严格的输入数据校验模型
class InferenceRequest(BaseModel):
age: float = Field(..., ge=0, le=120, description="患者年龄")
biomarker_a: float = Field(..., ge=0.0, description="生物标志物浓度")
treatment_group: int = Field(..., ge=0, le=1, description="治疗组标识 (0 或 1)")
class InferenceResponse(BaseModel):
risk_score: float
risk_level: str
status: str
@app.get("/health", status_code=status.HTTP_200_OK)
def health_check():
return {"status": "healthy"}
@app.post("/api/v1/predict", response_model=InferenceResponse)
async def predict_risk(payload: InferenceRequest):
try:
# 组装输入向量
input_data = np.array([[payload.age, payload.biomarker_a, float(payload.treatment_group)]], dtype=np.float32)
# 执行低延迟推理
outputs = session.run(None, {"input": input_data})
score = float(outputs[0][0])
return InferenceResponse(
risk_score=round(score, 4),
risk_level="HIGH" if score > 0.65 else "LOW",
status="success"
)
except Exception as e:
raise HTTPException(status_code=500, detail=f"Inference execution failed: {str(e)}")四、双语协同架构:避免非黑即白的最佳实践
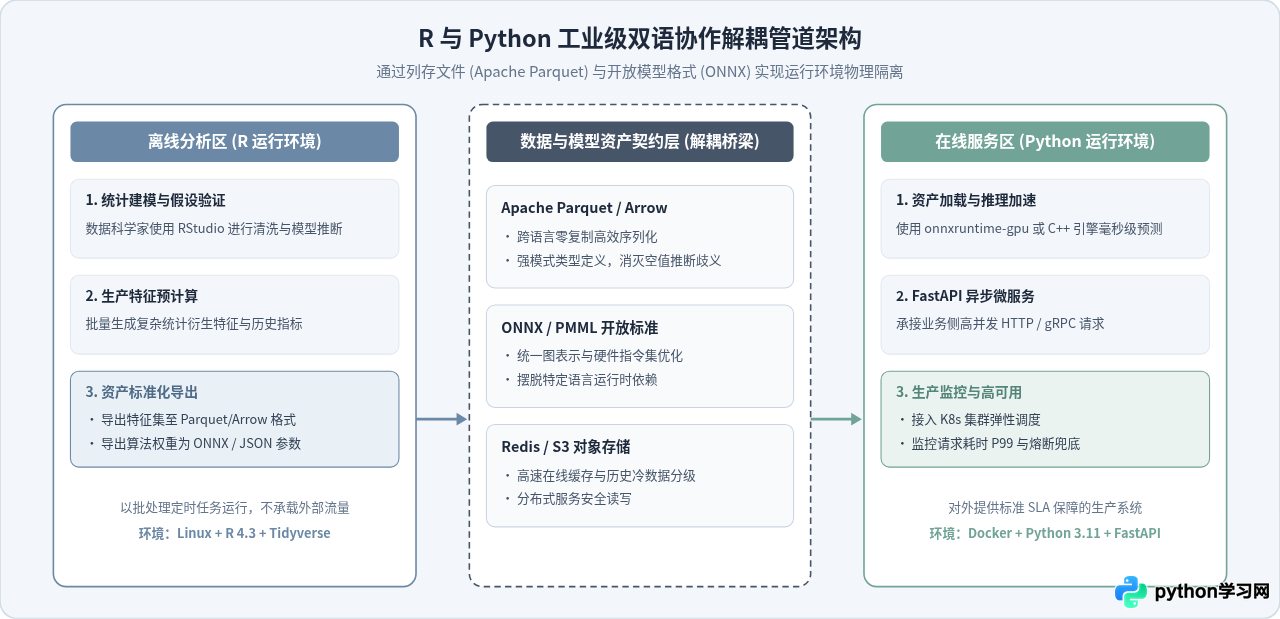
现实企业与科研机构中,往往存在“算法科学家擅长 R,后端架构师精通 Python”的客观情况。此时最忌讳的是强迫某一方抛弃既有优势,或者试图在一个进程内强行混合调用。
不推荐的做法:进程内重度黏合。例如在生产 Python 服务中使用 rpy2 动态唤起 R 引擎处理并发请求,或者在 R 中通过 reticulate 嵌套运行大型 Python 服务。这种做法会导致:
- 跨语言垃圾回收(GC)冲突,易引发难以复现的内存泄漏与核心转储(Core Dump);
- Docker 镜像体积剧增(需同时打包完整的 R 编译环境与 Python 运行时,镜像通常超过 2GB);
- 线程模型冲突:Python 的 GIL 与 R 的单线程事件循环在并发环境下极易产生死锁。
推荐的做法:基于“标准数据总线与微服务解耦”的流水线架构。
五、常见选型误区与避坑建议
事实分析:在通用计算机科学和深度学习领域,Python 的确占据压倒性优势;但在前沿统计学、临床医学评估、生态学和生物信息学领域,顶级统计学家通常直接向 CRAN 贡献原创方法包。如果你的课题核心依赖前沿小样本检验、复杂生存模型或特定的多重假设检验校正,强行在 Python 中复现往往需要团队耗费数月重写底层公式,且极易因缺少同行检验引发不可挽回的学术质疑。
事实分析:对于企业内部仅供数位分析师使用的低频工具后台,Plumber 能够快速工作。但如果面向用户端高并发请求,R 的单线程架构和内存管理机制将迅速暴露出瓶颈:一旦某次计算触发长耗时阻塞或内存溢出(OOM),整个服务容器将瞬间宕机且无法有效隔离请求。线上高并发服务应坚决由专业的 Python 异步框架或编译型语言承载。
事实分析:生产工程中真正需要在线实时执行的,往往仅是最终特征变换与模型点积计算(Inference Pass),其核心逻辑通常不足百行。复杂的统计推断、迭代优化与历史数据清洗完全可以保留在 R 环境中离线运行,仅将训练出的模型权重(或 ONNX 中间表达)与预计算特征传递给 Python 接口。这种架构既保护了科研人员的产出速度,又满足了工程系统对简洁可维护的要求。
六、选型决策总结表
为了方便团队快速达成共识,下表汇总了不同维度的语言选型建议:
| 决策考量维度 | 推荐选择 | 核心判定理由与实施建议 |
|---|---|---|
| 核心交付为学术期刊论文 | R 语言优先 | ggplot2 拥有工业出版级排版精度,CRAN 统计学检验具备权威可复现性。 |
| 生物信息学与基因组学分析 | R 语言优先 | Bioconductor 汇集了全球主流组学分析工具链,生态高度集中且兼容。 |
| 实时高并发预测 API(QPS > 100) | Python 优先 | FastAPI + Uvicorn 异步高并发处理能力极佳,支持完备的 Docker 运维体系。 |
| 计算机视觉与自然语言大模型 | Python 优先 | PyTorch、vLLM、Hugging Face 构建了现代 AI 的基石,硬件加速生态完备。 |
| 跨部门混合团队(科研+工程) | 双语解耦管道 | R 负责离线批处理计算与特征导出,Python 负责实时微服务与线上接口集成。 |
归根结底,优秀的技术选型从来不是寻找“唯一完美的语言”,而是让每种工具在其最具杠杆效应的领域发挥极致:让 R 专注于严谨的统计推断与科学发现,让 Python 承载高效的系统集成与工程落地。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









