

Python调用外部脚本时怎么传递参数和获取返回值

在 Python 开发中,调用外部脚本(无论是另一个 Python 脚本、Shell 脚本,还是已编译的二进制可执行文件)的标准现代化解决方案是标准库中的 subprocess.run()。传参的关键在于将命令与参数组织为纯字符串列表直接传入,以避免 Shell 注入和解析歧义;而获取返回值则区分为两层:一层是操作系统层面的执行状态码(returncode),另一层是子进程输出到标准输出(stdout)或标准错误(stderr)的实际业务数据流。
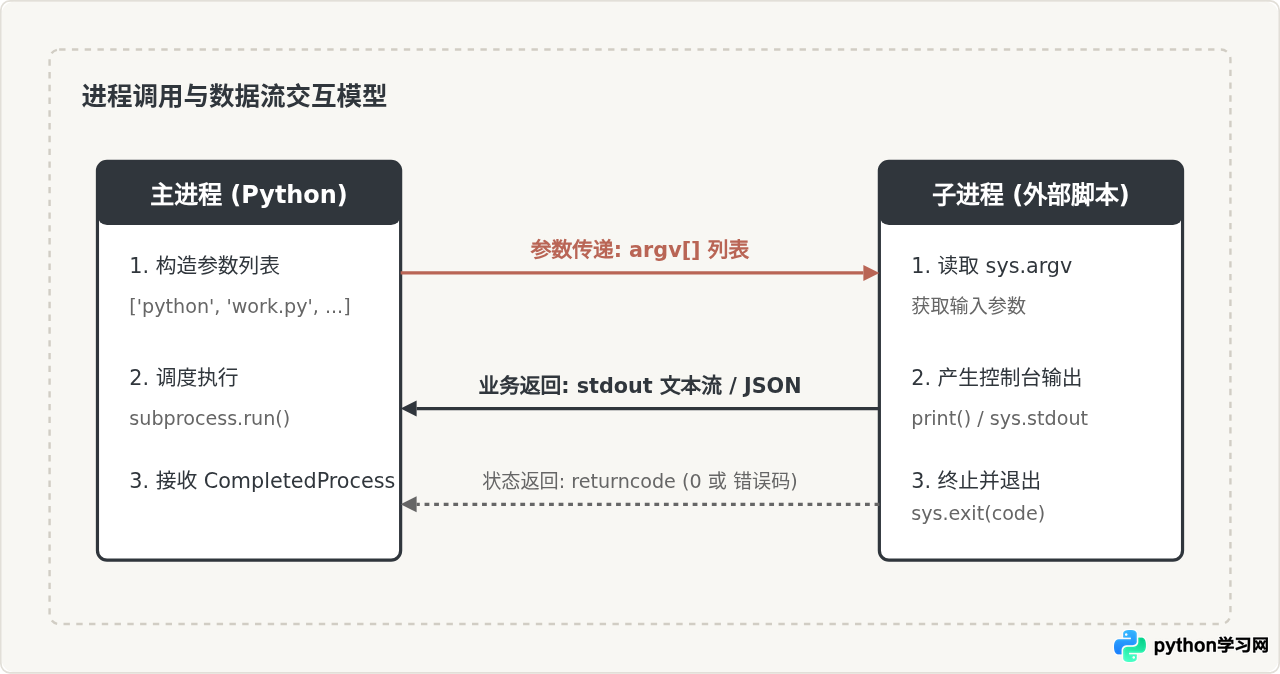
一、核心机制:进程如何传递参数与产生返回
在操作系统的进程树模型中,父进程启动子进程时,参数通过进程创建 API(在类 Unix 系统中为 execve,在 Windows 中为 CreateProcess)传递。子进程被注入一个指针数组,对应 Python 语言中的 sys.argv 列表。
当外部脚本完成工作后,它不能直接向父进程返回 Python 内存对象(例如字典或列表)。外部脚本能够留给父进程的信息仅有两类:
- 进程退出状态码(Exit Code):一个 0 到 255 范围的整数。按照工业标准,
0表示进程正常退出,非 0 值(如 1、2、127 等)表示遇到异常或特定错误分支。 - 标准输出与标准错误流(stdout / stderr):子进程在终端打印的所有文本数据。父进程可以通过管道捕获并解析为字符串或反序列化为结构化对象。
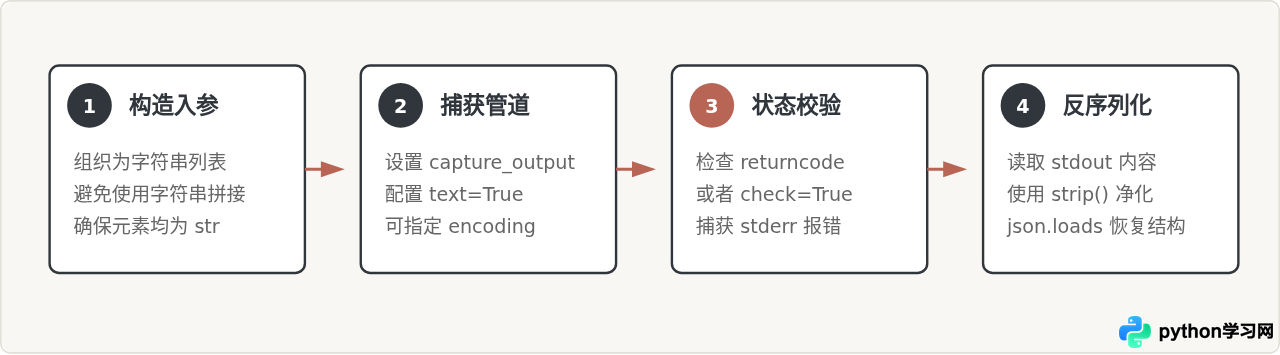
二、标准调用四步实现法
为了让交互流程清晰可测,我们分别编写被调用的目标脚本 worker.py 和负责调度的主控脚本 caller.py。
步骤一:编写外部脚本 worker.py
外部脚本通过 sys.argv 接收参数。由于参数在操作系统层面都是纯字符串,如果需要数值必须手动转换类型;脚本使用标准输出(print)输出业务处理结果,通过 sys.exit(code) 返回状态码。
# 文件名:worker.py
import sys
import json

def calculate():
    # sys.argv[0] 是脚本名称自身,后续元素才是真正传入的参数
    if len(sys.argv) < 3:
        sys.stderr.write("错误:需要提供至少两个数值参数。\n")
        sys.exit(1)  # 状态码 1 表示参数缺失异常

    try:
        num1 = float(sys.argv[1])
        num2 = float(sys.argv[2])
    except ValueError:
        sys.stderr.write("错误:参数必须能转换为数字。\n")
        sys.exit(2)  # 状态码 2 表示参数格式非法

    # 业务处理
    result = {
        "status": "success",
        "inputs": [num1, num2],
        "sum": num1 + num2,
        "product": num1 * num2
    }

    # 将结果转换为 JSON 格式打印到标准输出
    print(json.dumps(result))
    sys.exit(0)  # 状态码 0 表示成功

if __name__ == "__main__":
    calculate()
步骤二:编写主控脚本 caller.py 发起调用
在主进程中使用 subprocess.run() 来执行 worker.py,通过指定 capture_output=True 和 text=True 将输出自动解码为 Python 字符串。
# 文件名:caller.py
import sys
import json
import subprocess

def run_external_worker():
    # 推荐使用 sys.executable 获取当前相同的 Python 解释器路径
    cmd = [sys.executable, "worker.py", "15.5", "4"]

    print(f"正在执行命令: {' '.join(cmd)}")

    # 调用外部脚本并捕获输出
    result = subprocess.run(
        cmd,
        capture_output=True,  # 捕获 stdout 和 stderr
        text=True,            # 以文本字符串形式返回(而非 bytes)
        check=False           # 先不抛出 CalledProcessError,手动判定状态
    )

    # 1. 检查退出状态码
    if result.returncode != 0:
        print(f"执行失败,退出码: {result.returncode}")
        print(f"错误输出 (stderr):\n{result.stderr.strip()}")
        return

    # 2. 获取并解析标准输出内容
    raw_output = result.stdout.strip()
    try:
        data = json.loads(raw_output)
        print("调用成功,收到解析后的返回值:")
        print(f"两数之和: {data['sum']}")
        print(f"两数之积: {data['product']}")
    except json.JSONDecodeError:
        print(f"输出非合法 JSON: {raw_output}")

if __name__ == "__main__":
    run_external_worker()
在终端运行 python caller.py 后的控制台示例输出如下:
正在执行命令: /usr/bin/python3 worker.py 15.5 4
调用成功,收到解析后的返回值:
两数之和: 19.5
两数之积: 62.0
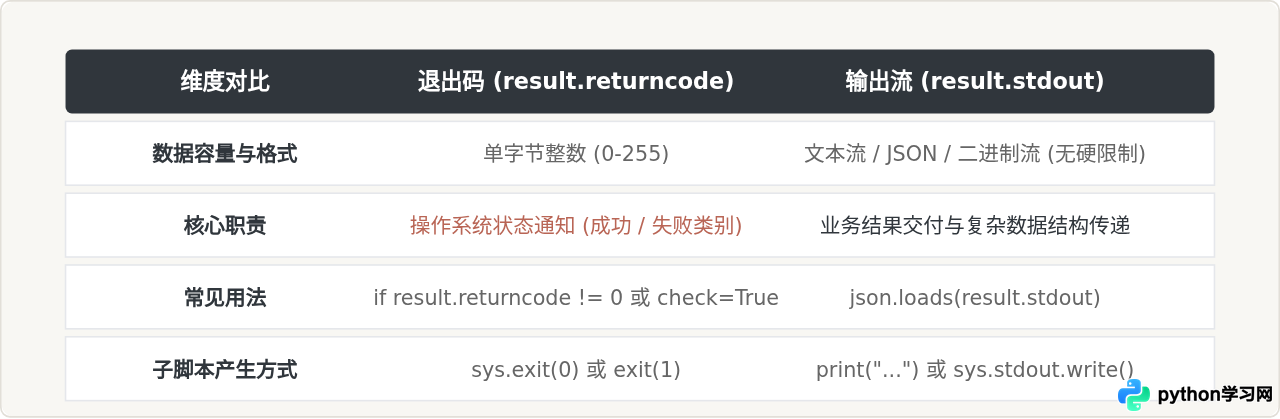
三、两种返回值的本质区别与选择依据
许多初学者容易混淆 returncode 和 stdout。下表清晰列举了两者的定义、承载能力及适用场景:
四、关键细节与避坑指南
当设置 shell=True 时,Python 会启动系统的 Shell(如 /bin/sh 或 cmd.exe)来执行命令字符串。如果传递的参数来自用户输入,且包含 ;、&& 或 |,攻击者就可以随意拼接执行任意恶意指令(Shell 注入漏洞)。
通过使用列表参数传递(shell=False 为默认值),操作系统会把每个列表元素直接作为独立参数送给子进程,无需经过 Shell 解析拆解,从底层彻底根除了参数注入风险。
1. 命名参数与标志位的传递
如果被调用脚本采用类似 argparse 的规范解析参数,传参列表需按顺序将参数名与值拆分成两个元素:
# 错误示例:不要把标志与值拼在一个字符串中
cmd = [sys.executable, "task.py", "--batch-size 64"]

# 正确示例:每个标志与值作为独立的列表项
cmd = [
    sys.executable,
    "task.py",
    "--mode", "production",
    "--batch-size", "64",
    "--verbose"
]
2. 编码与换行符处理
在 Windows 环境下,外部脚本如果打印中文字符,子进程默认可能使用 GBK 或 CP936 编码,而主进程若假定 UTF-8 可能导致 UnicodeDecodeError。此时应显式声明编码:
result = subprocess.run(
    cmd,
    capture_output=True,
    text=True,
    encoding="utf-8",       # 明确指定编码,避免跨平台解析错乱
    errors="replace"        # 遇到无法解码的字符时替换,不中断主流程
)
3. 自动化异常抛出与超时控制
如果外部脚本可能出现死循环,调用时应设置 timeout。若希望在外部脚本非 0 退出时直接中断报错,可开启 check=True:
try:
    # 限制外部脚本必须在 10 秒内执行完毕
    res = subprocess.run(cmd, capture_output=True, text=True, check=True, timeout=10)
    print(res.stdout)
except subprocess.TimeoutExpired:
    print("错误:外部脚本执行超时!")
except subprocess.CalledProcessError as e:
    print(f"脚本执行失败,退出码: {e.returncode}")
    print(f"错误内容: {e.stderr}")
五、场景选型总结
根据具体工程需求的不同,选择最合适的数据通信方式:
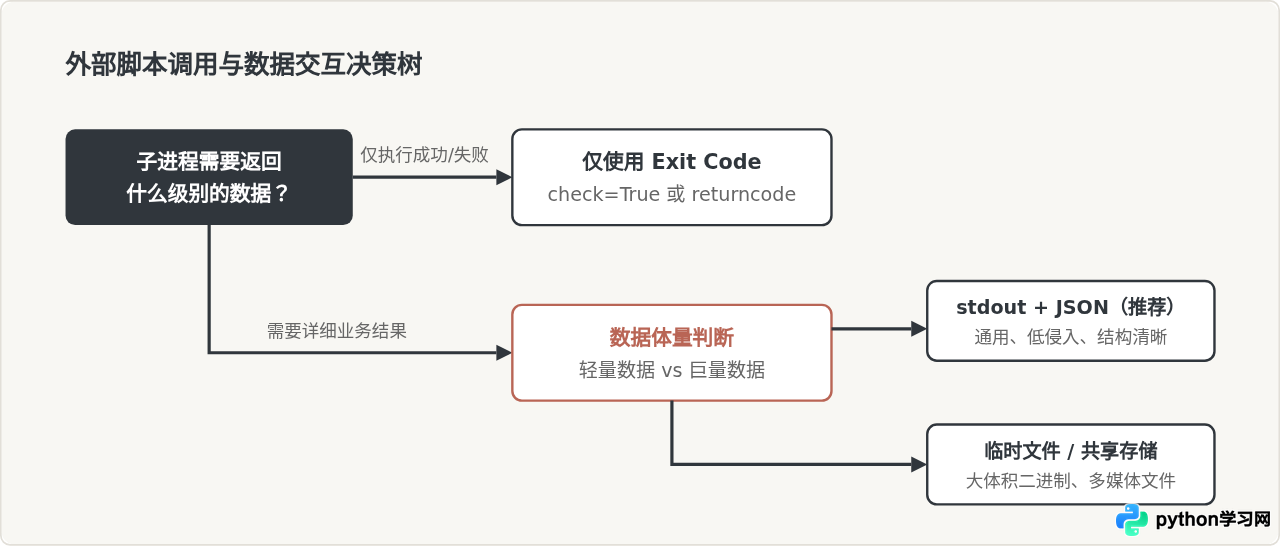
综上所述,Python 调用外部脚本的最佳实践可概括为三点:列表形式传参确保安全、capture_output 搭配 text=True 捕获文本输出、通过 returncode 和 JSON stdout 组合实现可靠的异常与数据流处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









