

Python多进程与多线程怎么选:CPU密集型任务的并行方案

一、为什么多线程救不了 CPU 密集型任务
在许多编程语言(如 C++、Java 或 Go)中,只要启动多个线程,操作系统调度器就会将这些线程自然分派到多核 CPU 上同时运算。但在主流的 CPython 解释器中,情况截然不同。
CPython 的内存管理并不是线程安全的,为了保护内部对象引用计数及内部状态,解释器引入了全局解释器锁(Global Interpreter Lock,简称 GIL)。GIL 是一把互斥锁,它的核心约束是:在任何给定时刻,同一个 Python 进程内只允许一个线程持有 GIL 并执行 Python 字节码。
这意味着,即便你的计算机拥有 16 个甚至 64 个 CPU 物理核心,一个 Python 进程里启动的多个线程在执行密集运算时,依然是在同一个核心上“排队轮流运行”。当一个线程耗尽分配的时间片(由 sys.getswitchinterval() 控制,默认约 5 毫秒),它会被迫释放 GIL 并触发操作系统上下文切换,随后多个线程重新争抢这把锁。
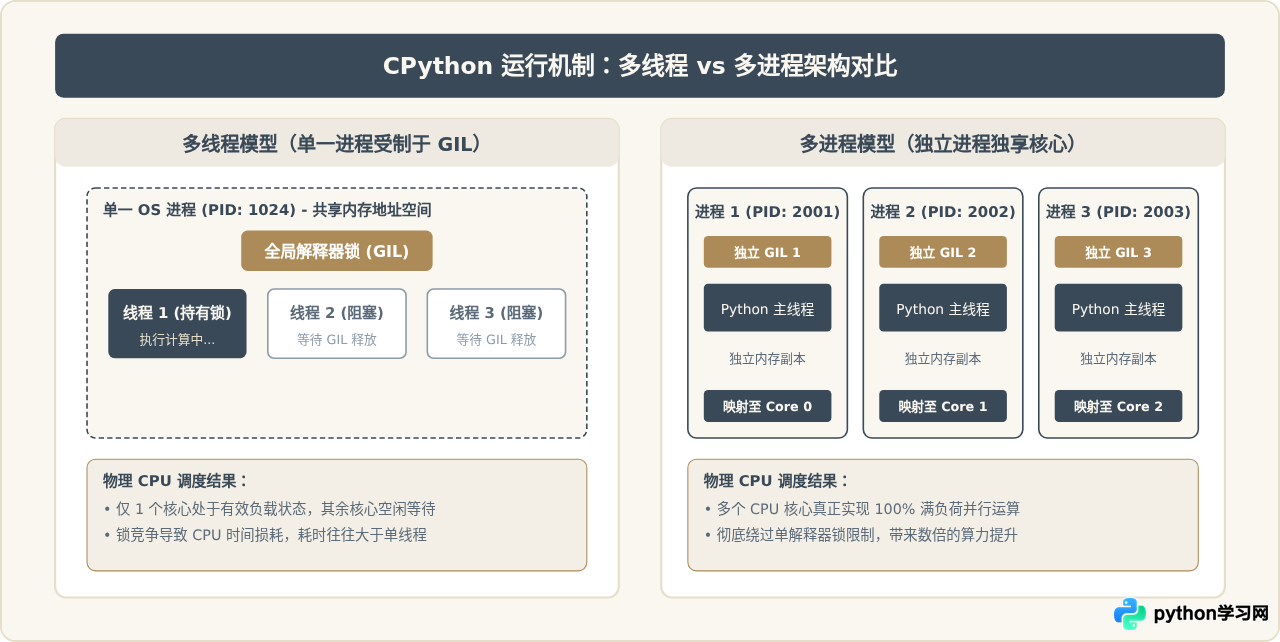
二、真实测试:单线程、多线程与多进程性能实测对比
为了直观验证理论,我们设计一个纯粹的 CPU 密集型任务示例:计算大整数质数或执行大规模哈希摘要计算。以下代码对比了三种模式在相同计算负载下的运行表现。
import time
import os
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

# 典型的 CPU 密集型计算任务
def cpu_bound_task(n):
    count = 0
    for i in range(n):
        count += i * i
    return count

if __name__ == '__main__':
    tasks = [10_000_000] * 8
    cores = os.cpu_count() or 4
    print(f"可用物理逻辑核心数: {cores}")

    # 1. 顺序执行(单线程 Baseline)
    t0 = time.perf_counter()
    res1 = [cpu_bound_task(t) for t in tasks]
    t1 = time.perf_counter()
    print(f"[单线程顺序执行] 耗时: {t1 - t0:.2f} 秒")

    # 2. 多线程执行 (ThreadPoolExecutor)
    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=cores) as pool:
        res2 = list(pool.map(cpu_bound_task, tasks))
    t1 = time.perf_counter()
    print(f"[多线程并发执行] 耗时: {t1 - t0:.2f} 秒")

    # 3. 多进程并行执行 (ProcessPoolExecutor)
    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=cores) as pool:
        res3 = list(pool.map(cpu_bound_task, tasks))
    t1 = time.perf_counter()
    print(f"[多进程并行执行] 耗时: {t1 - t0:.2f} 秒")
可用物理逻辑核心数: 8
[单线程顺序执行] 耗时: 4.82 秒
[多线程并发执行] 耗时: 5.14 秒 (不仅没有提速,反而因频繁锁切换慢了 6.6%)
[多进程并行执行] 耗时: 0.98 秒 (接近 5 倍真实加速比)
测试结果清楚地表明:在 CPU 密集场景下,多线程不仅无法提速,反倒引入了额外的 GIL 争抢开销;而多进程能够充分调动全部 CPU 物理核心,实现接近线性的加速比。
三、什么时候选多进程?清晰的选择决策流
既然多进程可以突破多核限制,是否意味着所有 Python 并发任务都该直接上多进程?并不是。
进程是操作系统资源分配的基本单位。创建进程需要复制虚拟内存映射、重新初始化 Python 解释器、加载模块依赖;更重要的是,进程之间内存空间完全隔离,数据传递必须通过 pickle 序列化和管道(Pipes/Sockets)通信。如果任务本身是网络阻塞或磁盘等待,或者任务单次计算耗时极短而数据量极大,多进程的额外开销将反客为主。
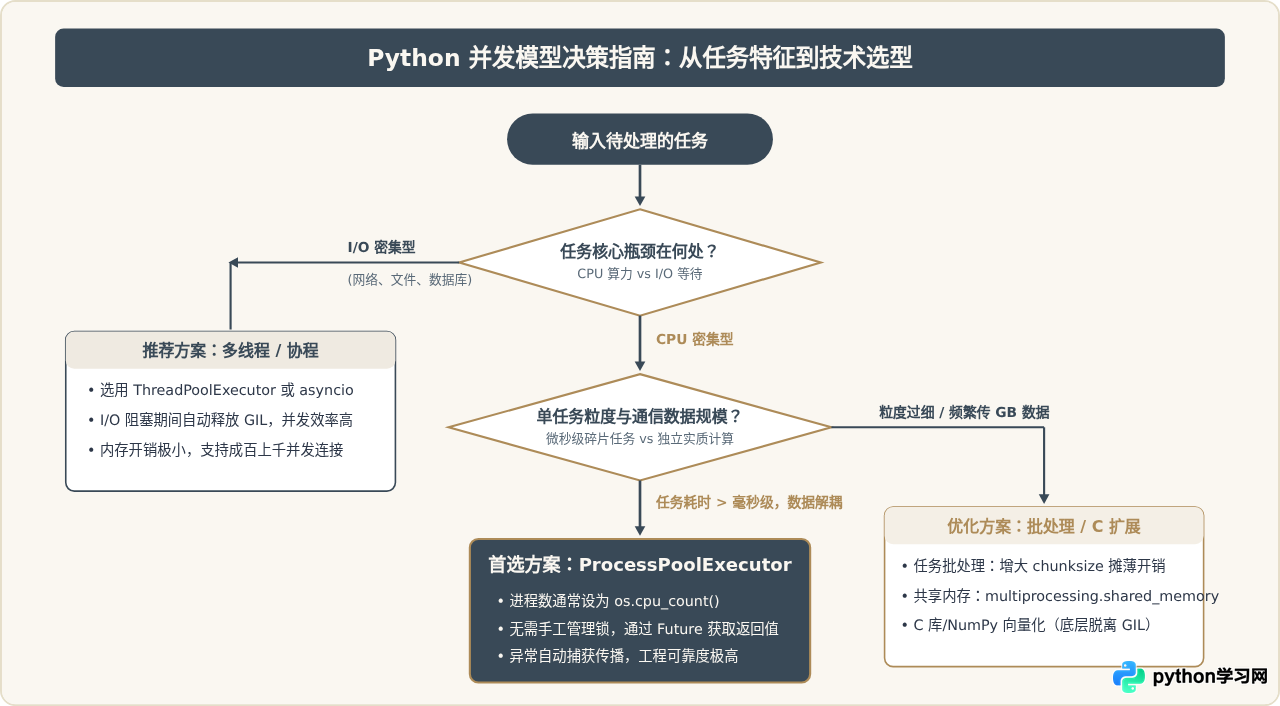
四、CPU密集型多进程并行方案的标准实施四步法
编写多进程代码有严格的工程规范。如果忽略平台特性或参数调优,很容易遭遇进程无限递归启动(Windows/macOS spawn 机制)、内存暴增或 Pickle 序列化失败报错。
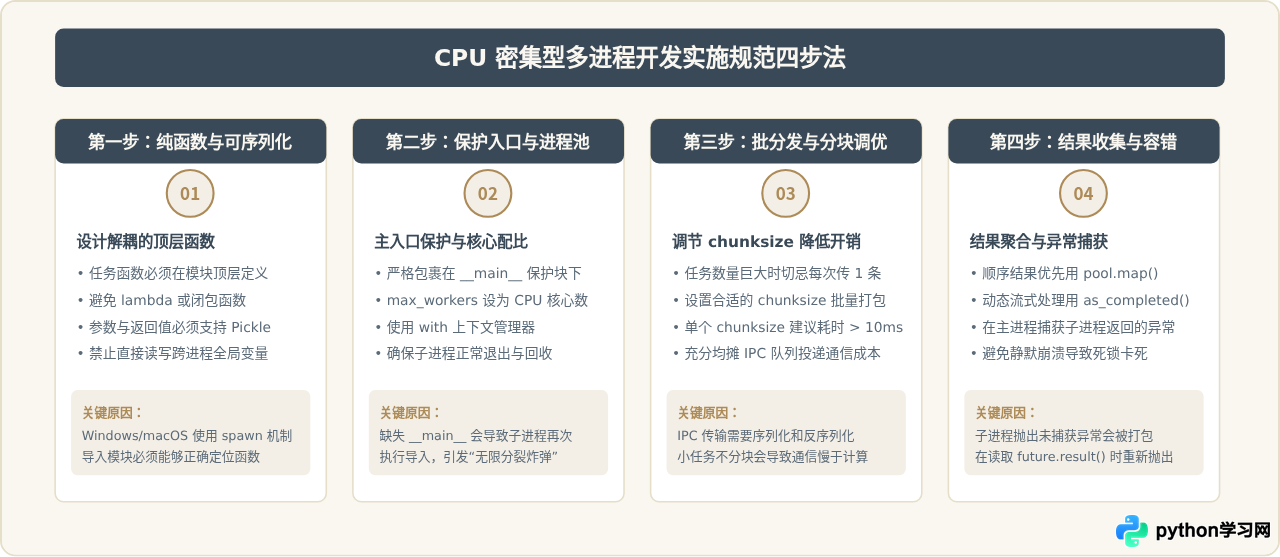
完整工程实现示范:批量哈希碰撞与质因数分解
下面是一个具备完整异常处理、分块调优和核心控制的标准生产级代码模板:
import hashlib
import os
import math
from concurrent.futures import ProcessPoolExecutor, as_completed

# 1. 顶层纯函数:输入输出明确,无全局依赖
def compute_heavy_hash(data_chunk):
    """模拟 CPU 密集型任务:对文本进行多轮哈希加盐加密"""
    results = []
    for item in data_chunk:
        h = hashlib.sha256(item.encode('utf-8'))
        for _ in range(50_000):
            h = hashlib.sha256(h.digest())
        results.append((item, h.hexdigest()[:12]))
    return results

# 辅助函数:将大列表按批次切分
def chunk_list(lst, chunk_size):
    for i in range(0, len(lst), chunk_size):
        yield lst[i:i + chunk_size]

# 2. 保护入口:必须写在 __name__ == '__main__' 下
if __name__ == '__main__':
    # 准备数据集:2000 个待处理字符串
    items = [f"payload-string-index-{i}" for i in range(2000)]

    # 3. 参数规划:核心数与批量大小
    num_workers = os.cpu_count() or 4
    batch_size = 50  # 每个子任务处理 50 项,共 40 个批次任务
    batches = list(chunk_list(items, batch_size))

    print(f"启动进程池,工作进程数: {num_workers},待分配批次数: {len(batches)}")

    final_results = []

    # 4. 执行与异常安全收集
    with ProcessPoolExecutor(max_workers=num_workers) as executor:
        # 提交所有批次任务
        future_to_batch = {
            executor.submit(compute_heavy_hash, b): idx
            for idx, b in enumerate(batches)
        }

        # 随着任务完成,实时流式回收
        for future in as_completed(future_to_batch):
            batch_idx = future_to_batch[future]
            try:
                batch_res = future.result()
                final_results.extend(batch_res)
            except Exception as exc:
                print(f"批次 #{batch_idx} 处理出现异常: {exc}")

    print(f"全部计算完毕,成功收集到 {len(final_results)} 项结果")
五、工程避坑指南:必须掌握的四项底层细节
-
1. 必须遵守
if __name__ == '__main__':规范:
在 Windows 和较新版本的 macOS(从 Python 3.8 起默认改用spawn启动模式)中,启动子进程实际上是重新运行一个全新的 Python 解释器并重新import主脚本。如果不在__main__保护区内创建进程池,子进程导入时又会再次尝试创建子进程,导致无限递归启动子进程,最终耗尽系统 PID 和内存导致系统假死。 -
2. 规避 Pickle 序列化瓶颈:
进程间传递的数据都必须经由pickle转成二进制流。不要把打开的文件句柄、数据库连接、未绑定的生成器、lambda 匿名函数传给子进程。如果任务需要读取数 GB 的全局只读矩阵,频繁在参数中传递会导致数倍的内存占用;此时推荐使用 Python 3.8+ 的multiprocessing.shared_memory机制,建立零拷贝的共享内存段。 -
3. 控制 Worker 数量与上下文颠簸:
针对纯 CPU 密集型任务,max_workers设置为物理核心数(或者os.cpu_count())最为理想。进程数绝不是越多越好。设置远超 CPU 核心数量的进程数,只会让操作系统调度器把宝贵的 CPU 时钟周期白白浪费在核心间进程上下文切换与 TLB 刷新上。 -
4. 警惕科学计算库内部的多线程冲突:
许多底层 C/Fortran 科学计算库(如 NumPy、PyTorch、OpenBLAS、MKL)在其内部本身就开启了 OpenMP 多线程运算。如果在 Python 层启动了 8 个多进程,而每个子进程内的 NumPy 又默认占用 8 个 OpenMP 线程,总共就会有 64 个活跃线程争抢 8 个核心,导致严重的性能崩塌。在脚本最开头加入以下环境变量即可解决:import os os.environ["OMP_NUM_THREADS"] = "1" os.environ["MKL_NUM_THREADS"] = "1" os.environ["OPENBLAS_NUM_THREADS"] = "1"
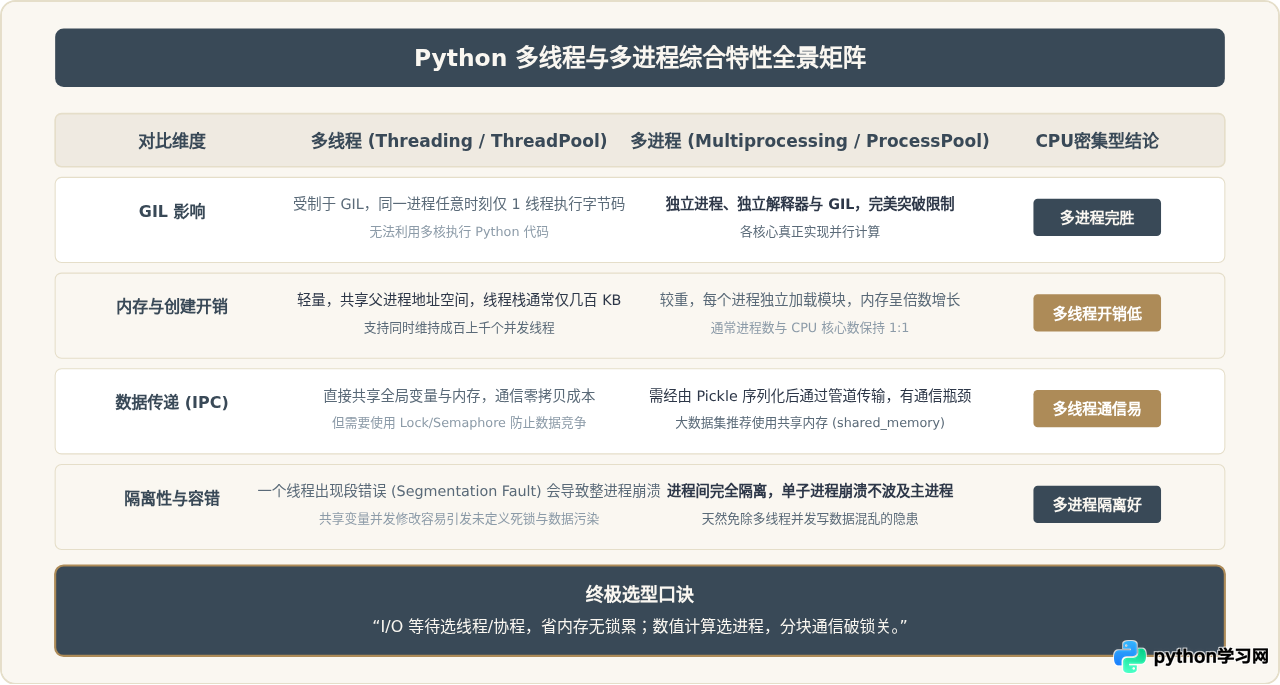
六、全景对比与技术选型速查总结
为了在架构设计和技术评审中快速确定选型,以下将多线程与多进程的关键维度汇总为全景对比图表。
结语
在面对 Python 任务性能优化时,首先要通过性能分析(Profiling)明辨瓶颈的本质。若任务耗时主要花在网络请求、磁盘 I/O 或数据库调用上,多线程或异步协程(asyncio)能以极低的系统开销提供优异的高并发能力。
但只要任务属于纯 Python 编写的 CPU 密集型任务(如大规模数值计算、图像滤波渲染、自定义加密压缩或海量文本解析),多进程是 CPython 体系下唯一能释放多核 CPU 潜能的官方内置解决方案。采用 concurrent.futures.ProcessPoolExecutor 配合良好的模块解耦、保护入口以及合理的 chunksize 批处理,便能在保障系统稳定性的同时最大化计算吞吐量。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









