

Python自动检测CSV文件编码并读取的代码实现

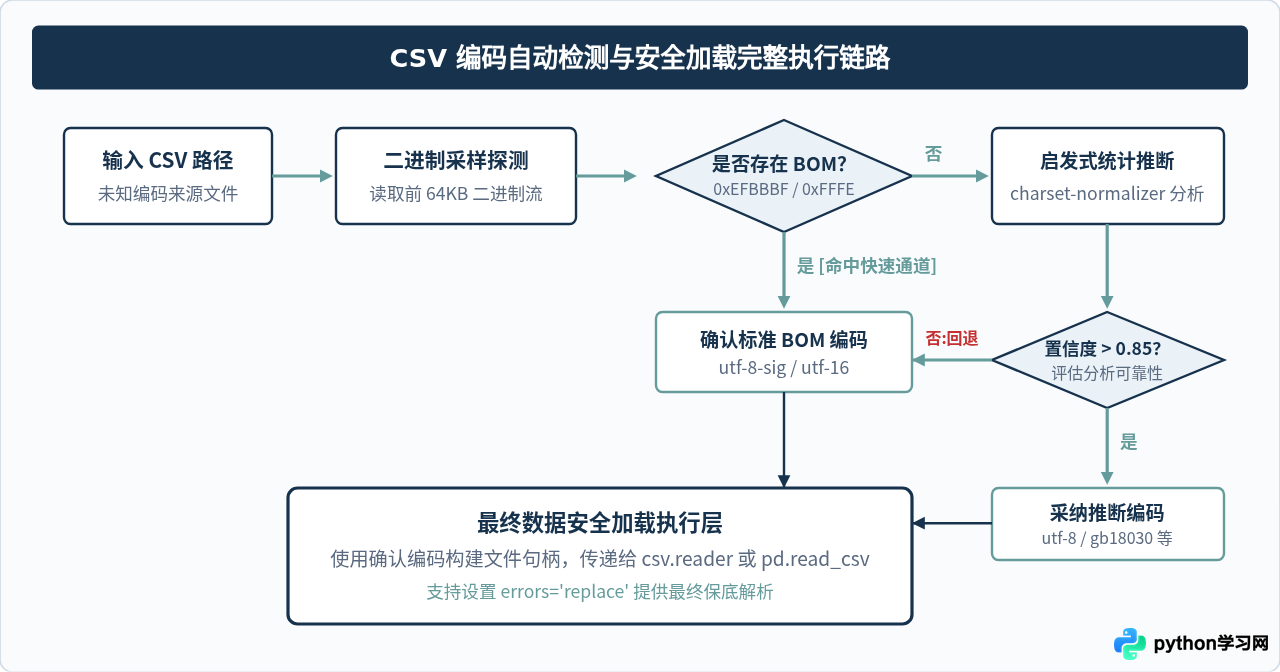
在数据处理任务中,直接使用固定编码(如 encoding='utf-8')读取来源多样的 CSV 文件,是触发 UnicodeDecodeError 的主要根源。不同平台与软件导出的 CSV 格式规范各异:现代开发环境多输出标准无 BOM 的 UTF-8,Windows 版 Excel 常输出本地化 ANSI 编码(如中文环境下的 GBK/GB2312),而部分跨平台报表又会带有 UTF-8-SIG(带 BOM 字节标记)。解决这一问题的根本路径是构建一套两阶段处理机制:先对文件头部字节流进行快速特征嗅探与统计学推断,确定高置信度编码后,再按该编码流式读取数据并设置安全回退机制。
一、CSV 编码冲突的表现与检测原理
CSV 纯文本文件本身并不包含存储其编码类型的元数据。系统或应用程序在读取文件时,必须依赖外部指定的解码规则将连续的二进制字节序列还原为字符文本。一旦解码规则与写入规则不一致,就会出现两类典型问题:
- 字节截断与解码崩溃:当使用 UTF-8 去解码包含 GBK 编码中文字符的字节流时,GBK 的高位双字节序列无法匹配 UTF-8 的多字节头部规范,解释器会立即抛出
UnicodeDecodeError并中断程序。 - BOM 字符隐式污染:当使用基础
utf-8读取由 Windows Excel 导出的带 BOM 文件时,文件开头的\xef\xbb\xbf字节会被当成正文字符读取,导致 CSV 数据的首个字段名变为\ufeffid,破坏后续的字典键索引和数据对齐。
二、常见编码特性与兼容矩阵
处理中文数据时,经常遇到的编码方案主要分为 Unicode 家族与国标家族两大类。理解它们在字节维度的结构特征,有助于在编写检测逻辑时设定合理的判断优先级。
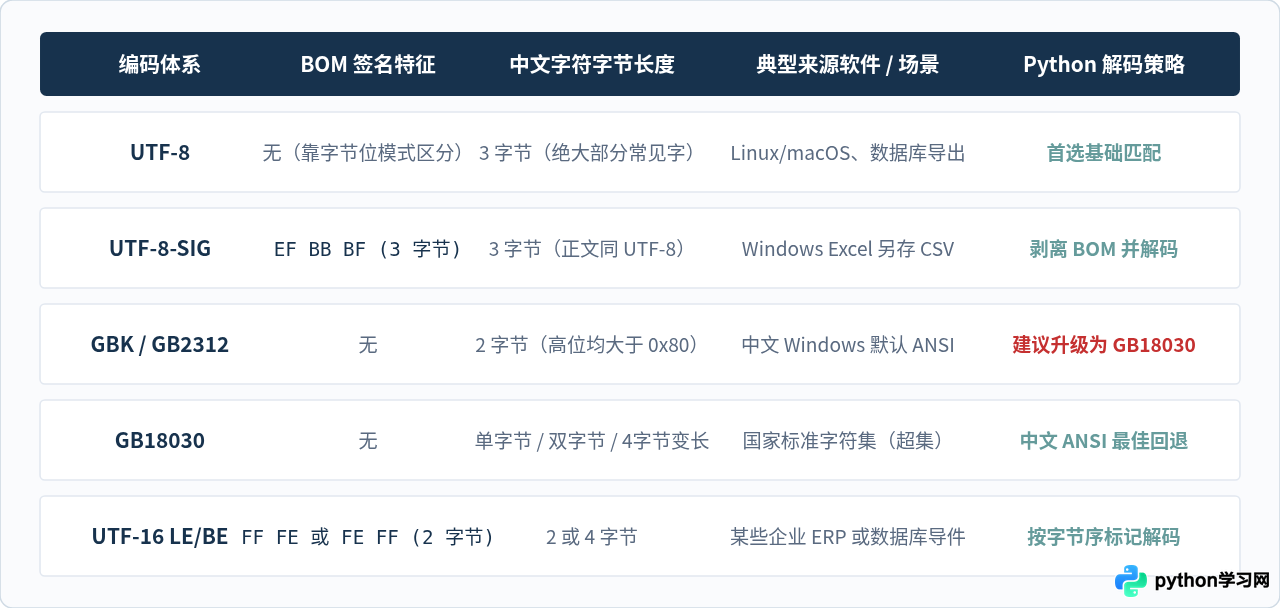
在 Python 解码环节中,
GB18030 是 GBK 和 GB2312 的严格超集。许多历史系统声称导出的是 GBK 格式,但往往包含生僻字、少数民族文字或特定标点。若指定 encoding='gbk' 会因越界无法解析,而使用 encoding='gb18030' 则能完全向前兼容并成功解码。
三、基于第三方库的自动检测实现(推荐方案)
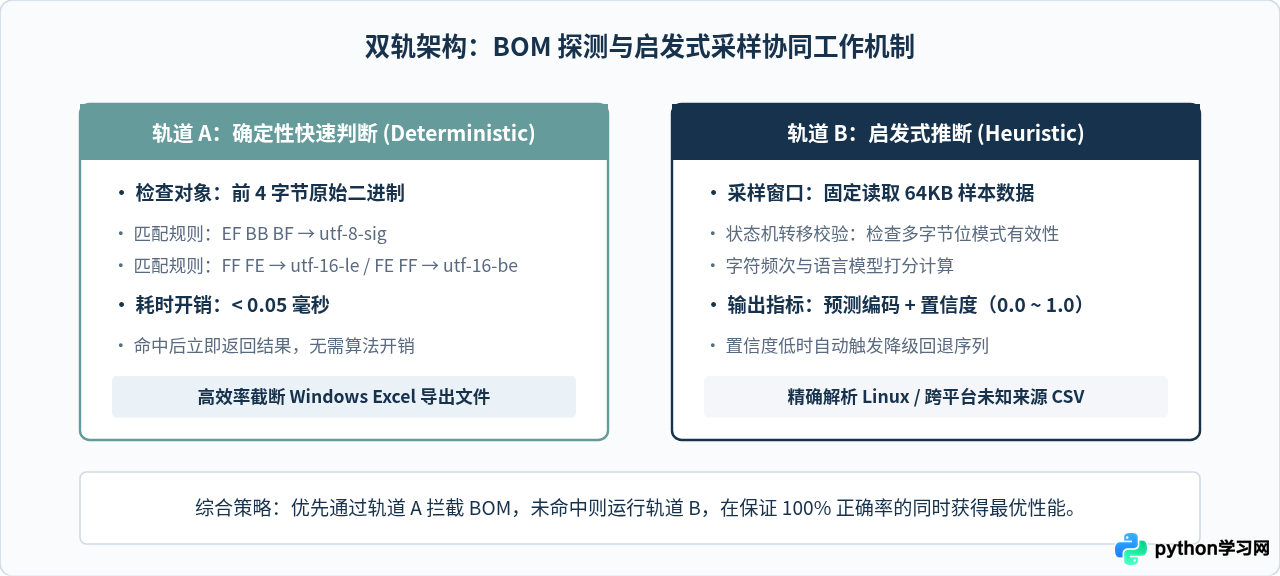
目前在 Python 生态中,进行文本编码推断的主流库有两个:早期的 chardet 与现代的 charset-normalizer。charset-normalizer 也是 requests 官方采用的核心依赖,其优点在于推断速度更快、支持更多语言模型与置信度评价指标,且完全兼容 chardet 的 API 风格。
1. 采样检测避免大文件性能陷阱
对体积较大的 CSV 文件(如几百兆到数吉字节),绝不能使用 file.read() 读取全部字节后丢入检测器。全量加载不仅占用庞大内存,而且文本的编码规则在前部数万字节中早已充分暴露。工程实践中,采样前 64KB(65536 字节)即可达到 99% 以上的检测准确率。
2. 完整检测与读取封装代码
下面给出生产环境可以直接复用的通用读取模块,整合了 BOM 拦截、样本分析以及 Pandas/标准库读取逻辑:
import os
import csv
from typing import Optional, Tuple, Dict, Any
from charset_normalizer import from_bytes
import pandas as pd


def detect_csv_encoding(file_path: str, sample_size: int = 65536) -> str:
    """
    自动检测 CSV 文件的字符编码。

    参数:
        file_path: 目标 CSV 文件的本地路径
        sample_size: 采样字节数,默认为 64KB
    返回:
        检测到的编码名称字符串
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"未找到目标文件: {file_path}")

    with open(file_path, "rb") as f:
        # 首先检查最前方的 4 个字节,快速识别常见 BOM
        raw_prefix = f.read(4)
        if raw_prefix.startswith(b"\xef\xbb\xbf"):
            return "utf-8-sig"
        elif raw_prefix.startswith(b"\xff\xfe"):
            return "utf-16-le"
        elif raw_prefix.startswith(b"\xfe\xff"):
            return "utf-16-be"

        # 回退指针并读取前 sample_size 字节进行启发式分析
        f.seek(0)
        sample = f.read(sample_size)

    # 如果文件为空,直接返回 utf-8
    if not sample:
        return "utf-8"

    # 使用 charset_normalizer 进行探测
    results = from_bytes(sample)
    best_match = results.best()

    if best_match is not None:
        encoding = best_match.encoding.lower()
        # 兼容性归一化:若判断为 gbk 或 gb2312,建议提升为 gb18030
        if encoding in ("gbk", "gb2312"):
            return "gb18030"
        return encoding

    # 无法推断时的兜底编码
    return "utf-8"


def read_csv_auto(file_path: str, as_dataframe: bool = False, **kwargs) -> Any:
    """
    自动检测编码并读取 CSV 文件内容。

    参数:
        file_path: CSV 文件路径
        as_dataframe: 是否返回 pandas.DataFrame(需安装 pandas)
        **kwargs: 透传给 csv.reader 或 pandas.read_csv 的其他参数
    """
    detected_encoding = detect_csv_encoding(file_path)
    print(f"[信息] 文件 '{os.path.basename(file_path)}' 自动识别编码为: {detected_encoding}")

    if as_dataframe:
        # 使用 pandas 读取,并传递检测出的 encoding
        return pd.read_csv(file_path, encoding=detected_encoding, **kwargs)

    # 使用 Python 原生标准库 csv.reader 读取
    rows = []
    with open(file_path, "r", encoding=detected_encoding, errors="replace", newline="") as f:
        reader = csv.reader(f, **kwargs)
        for row in reader:
            rows.append(row)
    return rows


if __name__ == "__main__":
    # 使用示例
    target_csv = "test_data.csv"
    if os.path.exists(target_csv):
        # 方案 A: 获取普通列表数据
        data = read_csv_auto(target_csv)
        print(f"读取行数: {len(data)}")

        # 方案 B: 直接读取为 DataFrame
        # df = read_csv_auto(target_csv, as_dataframe=True)
        # print(df.head())
四、零外部依赖的纯标准库回退方案
在无法安装第三方包(如处于受限沙箱、轻量容器或嵌入式环境)时,可利用 Python 内置的 codecs 与 try-except 构造优先级递进的回退链。该方案利用了 UTF-8 严格的字节序校验规则,以及 GB18030 的高容错性:
import csv


def read_csv_pure_python(file_path: str):
    """
    无任何第三方依赖的 CSV 编码自动嗅探与安全加载函数
    回退顺序: utf-8-sig -> gb18030 -> utf-16 -> latin-1
    """
    # 候选编码列表,按命中概率与兼容性排序
    candidate_encodings = ["utf-8-sig", "gb18030", "utf-16", "latin-1"]

    for enc in candidate_encodings:
        try:
            with open(file_path, "r", encoding=enc, newline="") as f:
                # 尝试预读取一行或前若干行进行编码验证
                sample_lines = [f.readline() for _ in range(20)]
                if not any(sample_lines):
                    # 文件为空
                    return []

                # 重新定位到开头完整读取
                f.seek(0)
                reader = csv.reader(f)
                return list(reader)
        except (UnicodeDecodeError, UnicodeError):
            # 当前编码不匹配,尝试下一个候选编码
            continue

    raise ValueError(f"无法使用候选编码解析文件: {file_path}")
1.
utf-8-sig 置于首位:如果文件带 BOM,它能完美剔除 BOM 并解析;如果文件是不带 BOM 的标准 UTF-8,它完全等同于 utf-8。2.
gb18030 置于第二位:若 UTF-8 校验失败(抛出 UnicodeDecodeError),说明包含了不符合 UTF-8 规范的单/多字节,在中文场景下绝大多数为 GBK/GB18030。3.
latin-1 置于最终兜底:该编码将每个字节映射为单个字符,绝不会抛出解码异常,但需注意它可能将中文还原为乱码,仅作为极端排错时的保底方案。
五、生产场景下的决策矩阵与工程建议
在实际开发与数据流水线中,针对不同体积与业务频率的文件,应采取适度的优化策略以平衡 CPU 资源与吞吐量。
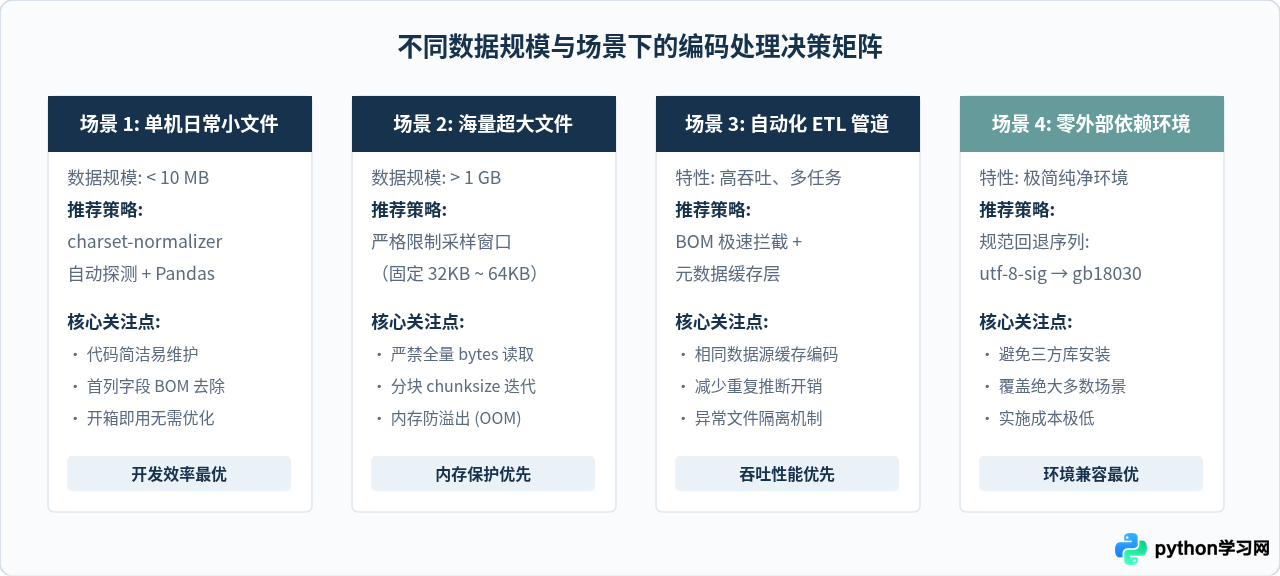
总结来说,处理未知编码 CSV 的核心不是单纯碰运气切换参数,而是遵循“前缀 BOM 拦截 ➔ 固定窗口字节采样 ➔ 算法推断编码 ➔ 超集与回退保障”的确定性工程链路。通过将 utf-8-sig 与 gb18030 融入检测流程,可以彻底解决大多数中文环境下的乱码与程序崩溃异常,大幅提升自动化数据处理管道的鲁棒性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









