

大模型微调后效果怎么评估?准确性、鲁棒性及幻觉检测

微调只是让模型适应特定领域数据的第一步,真正的挑战在于确认模型是否真的“学会”了,而不是仅仅记住了训练样本或产生了新的偏差。评估微调效果不能仅凭肉眼观察几个问答案例,需要建立一套包含准确性、鲁棒性和事实一致性的多维评价体系。
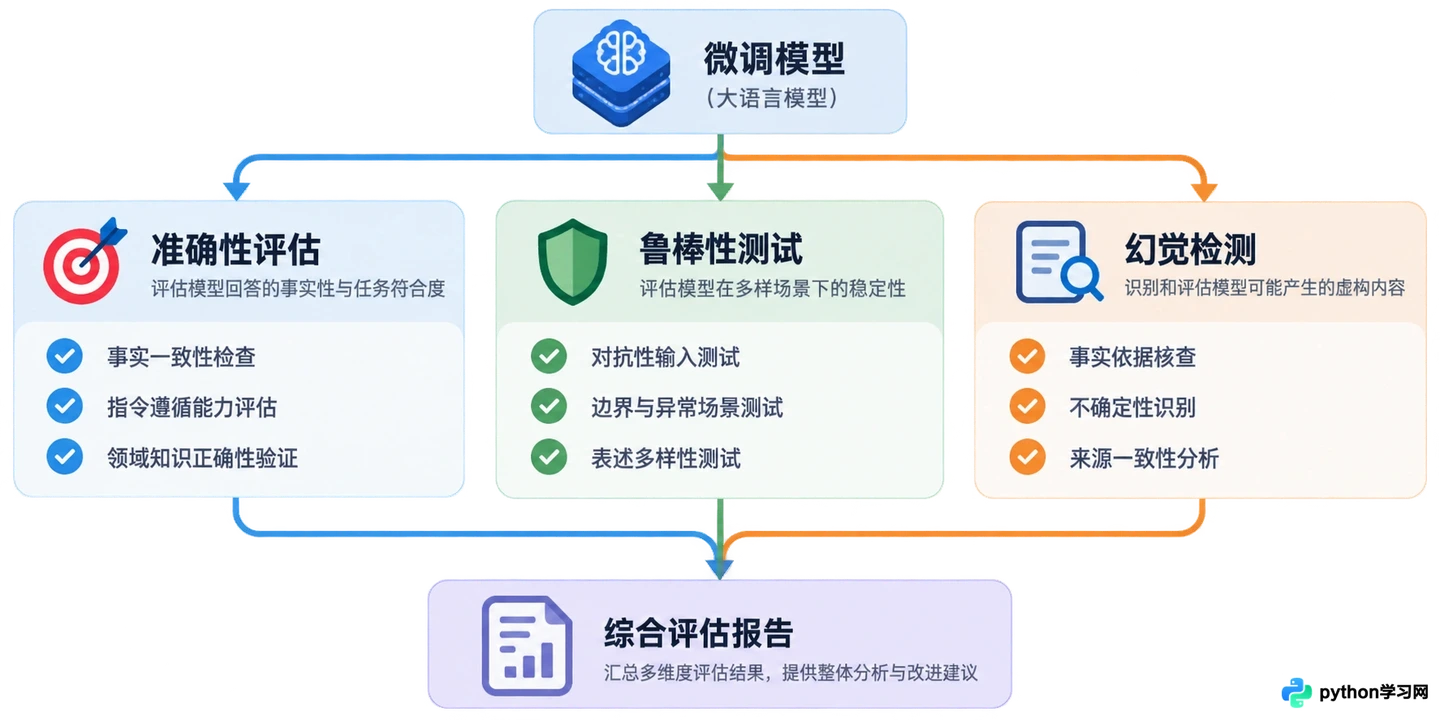
大模型微调评估流程概览
概述评估工作通常分为离线评估和在线评估两个阶段。离线评估侧重于在封闭测试集上的量化指标,如准确率、召回率和F1分数;在线评估则关注真实场景下的用户反馈和长尾问题。对于大多数开发团队而言,构建一个高质量的黄金测试集(Golden Test Set)是起步的关键。这个测试集应包含典型业务问题、边界案例以及已知易错点,且必须与训练数据完全隔离,以避免数据泄露导致的虚高评分。关于【准确性评估】准确性是衡量模型回答正确程度的基础指标。在分类任务中,可以直接计算预测标签与真实标签的匹配率;但在生成式任务中,评估更为复杂。常用的方法包括精确匹配(Exact Match),适用于答案唯一且格式固定的场景,如代码生成或实体抽取。对于开放域问答,更推荐使用基于语义相似度的指标,如BERTScore或BLEU,它们能捕捉同义词替换带来的细微差异。此外,人工评估依然是金标准。设计一个包含“正确”、“部分正确”、“错误”和“无关”四个等级的评分量表,由多位标注员对随机抽样结果进行打分,可以有效弥补自动指标的不足。注意保持标注标准的一致性,定期校准标注员的判断尺度。
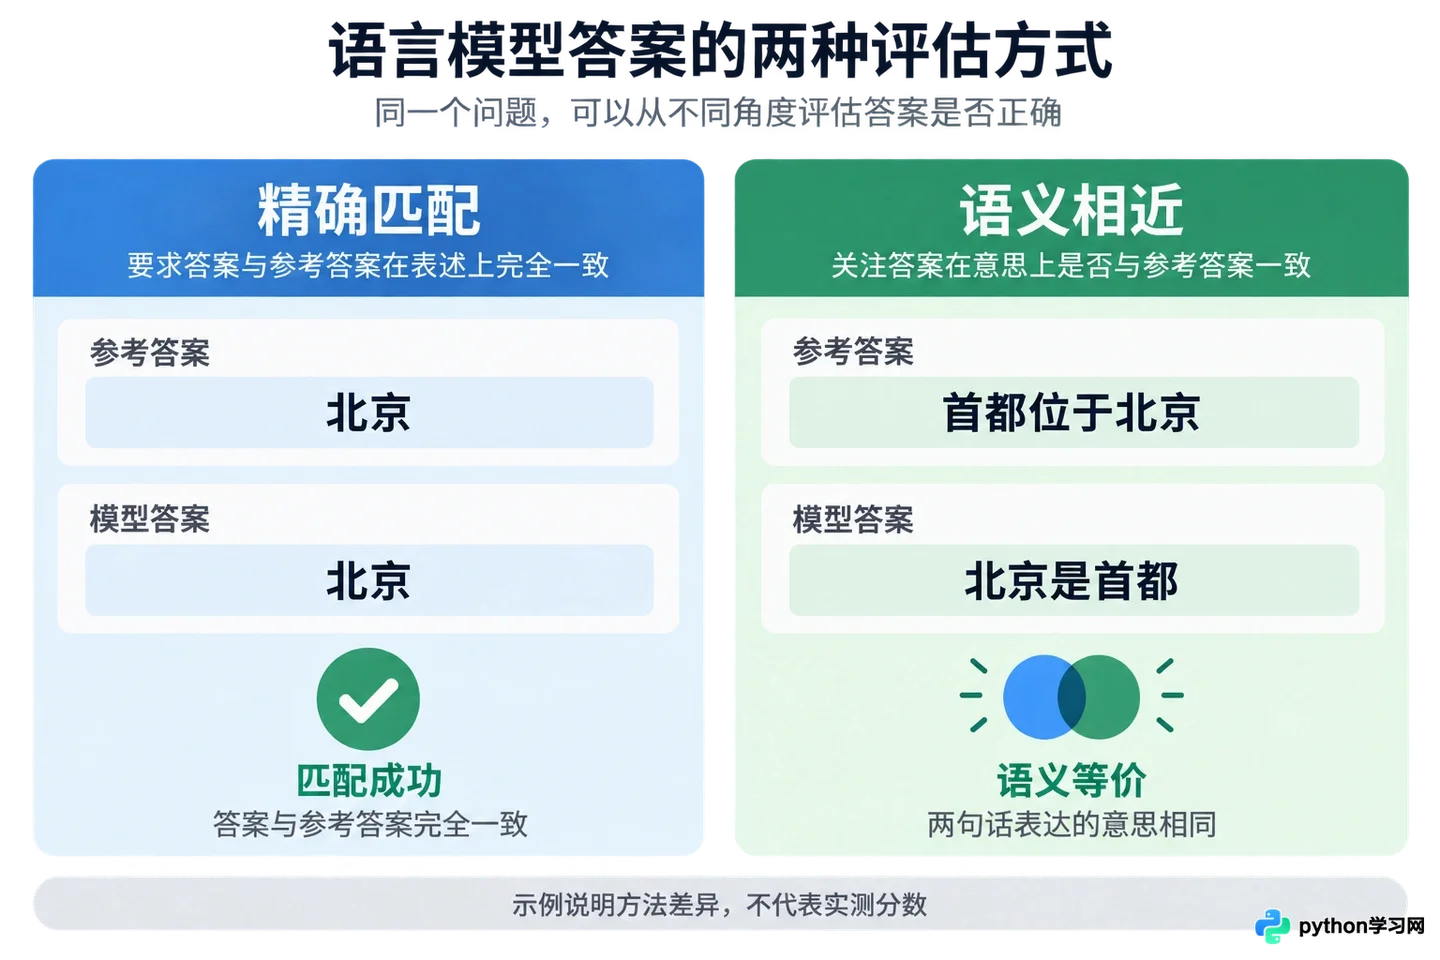
准确性评估指标对比
关于【鲁棒性测试】鲁棒性指模型在面对输入扰动、噪声或非预期指令时保持稳定输出的能力。微调后的模型往往在干净数据上表现良好,但在实际应用中容易受到攻击或误导。对抗测试是检验鲁棒性的有效手段。可以通过添加拼写错误、插入无关语句、使用同义替换或改变句式结构来构造对抗样本。如果模型在这些轻微扰动下输出大幅偏离原意,说明其泛化能力不足。另一种常见的测试是压力测试,即输入超长文本、复杂嵌套逻辑或矛盾前提,观察模型是否会出现崩溃、截断或逻辑混乱。例如,在金融场景中,故意提供相互冲突的财务数据,检查模型是否能识别矛盾并给出谨慎回答,而非强行生成一个看似合理但错误的结论。
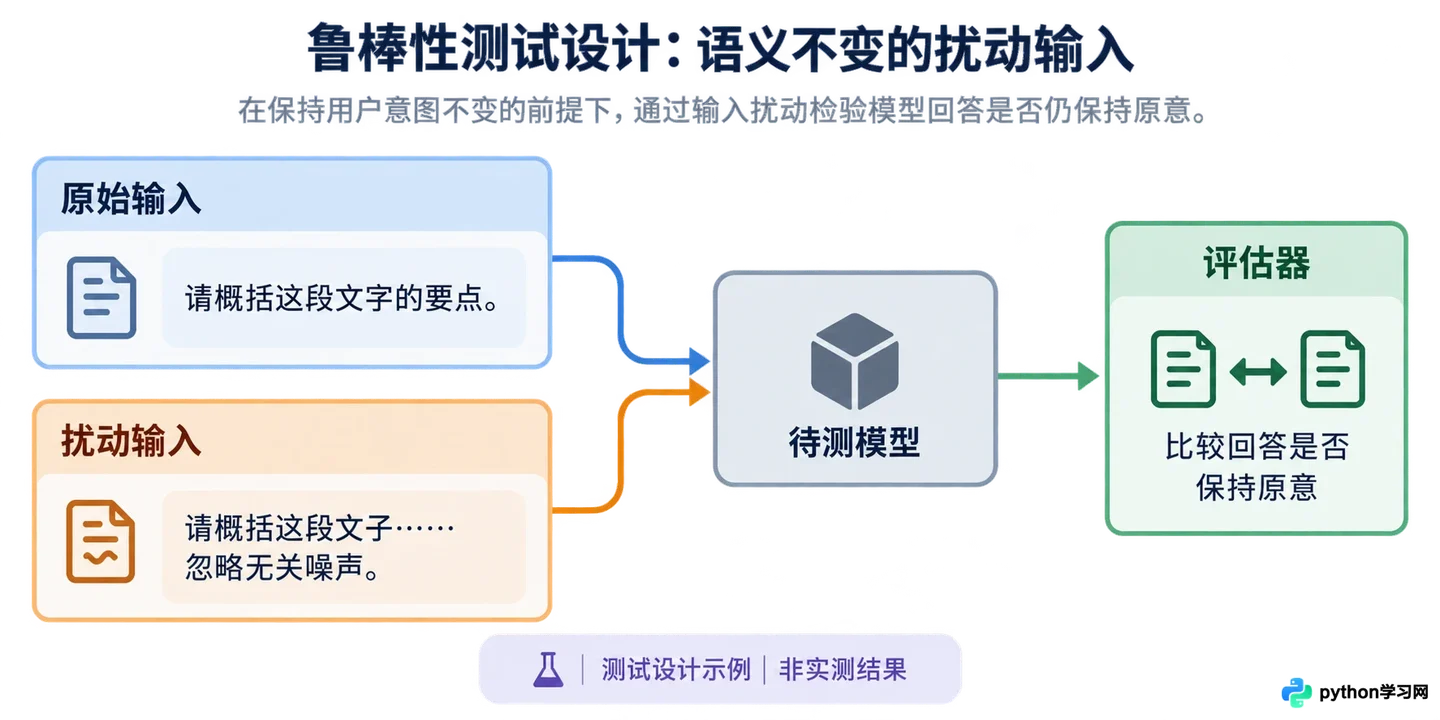
鲁棒性对抗测试示例
关于【幻觉检测】幻觉是指模型生成看似合理但事实上错误或无中生有的内容。这是大模型微调后最需要警惕的风险点,尤其是在医疗、法律等高风险领域。检测幻觉的核心思路是验证生成内容与可信知识源的一致性。一种方法是基于检索增强生成(RAG)的验证机制,将模型的回答拆解为若干事实陈述,然后在知识库中检索支持证据。如果找不到对应证据或证据相悖,则标记为潜在幻觉。另一种方法是利用另一个独立的大模型作为“裁判”,通过提示词工程要求其判断回答的事实准确性。例如,提供原始问题和模型回答,要求裁判模型指出其中可能存在的虚构信息。虽然这种方法成本较高,但对于关键业务场景至关重要。此外,监控模型的置信度分数也有助于早期发现幻觉倾向,尽管当前多数开源模型并未直接暴露这一参数,但可以通过多次采样的一致性来间接推断。
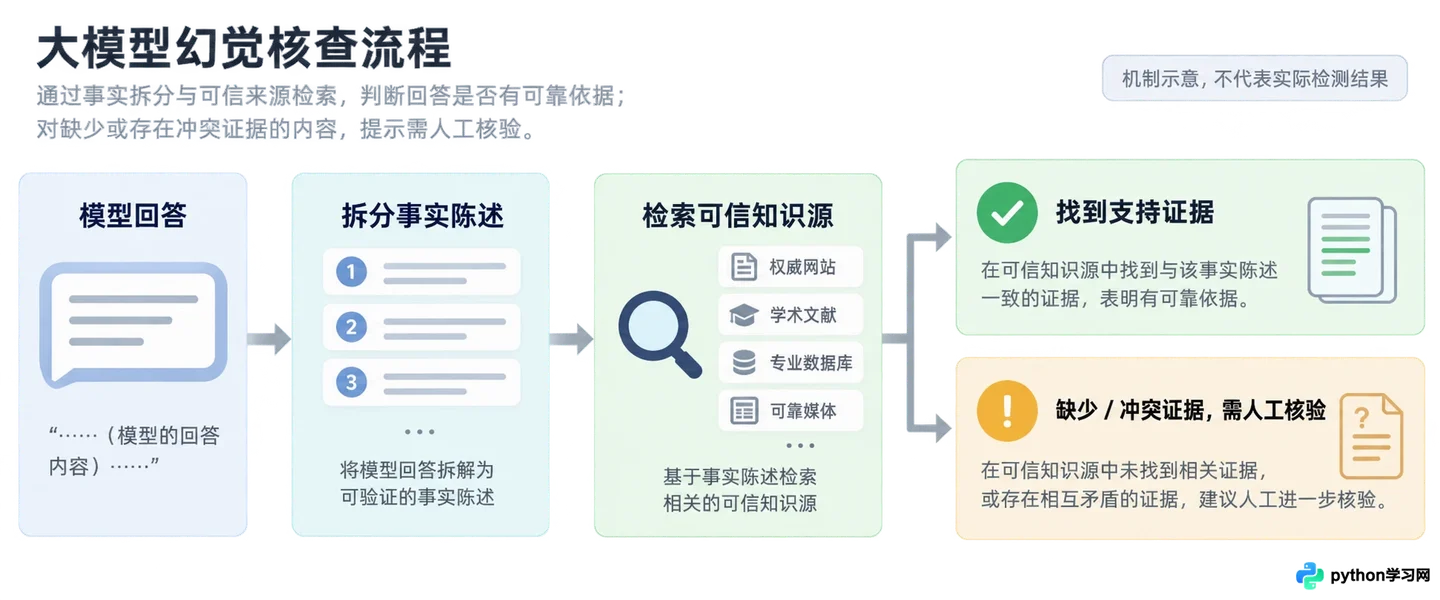
幻觉检测机制原理
关于【综合评估流程】将上述三个维度整合到一个自动化评估流水线中,可以大幅提高迭代效率。每次微调完成后,自动运行准确性测试集,计算核心指标;同时触发鲁棒性脚本,生成对抗样本并记录性能下降幅度;最后调用幻觉检测模块,对高风险回答进行标记。可视化仪表盘能直观展示各版本模型的对比情况,帮助团队快速定位问题所在。例如,如果某次微调后准确性提升但幻觉率激增,可能需要调整损失函数或增加事实性约束数据。评估不是一次性的任务,而是伴随模型全生命周期的持续过程。随着业务数据的变化和用户反馈的积累,测试集也需要不断更新,以确保评估结果始终反映真实世界的需求。
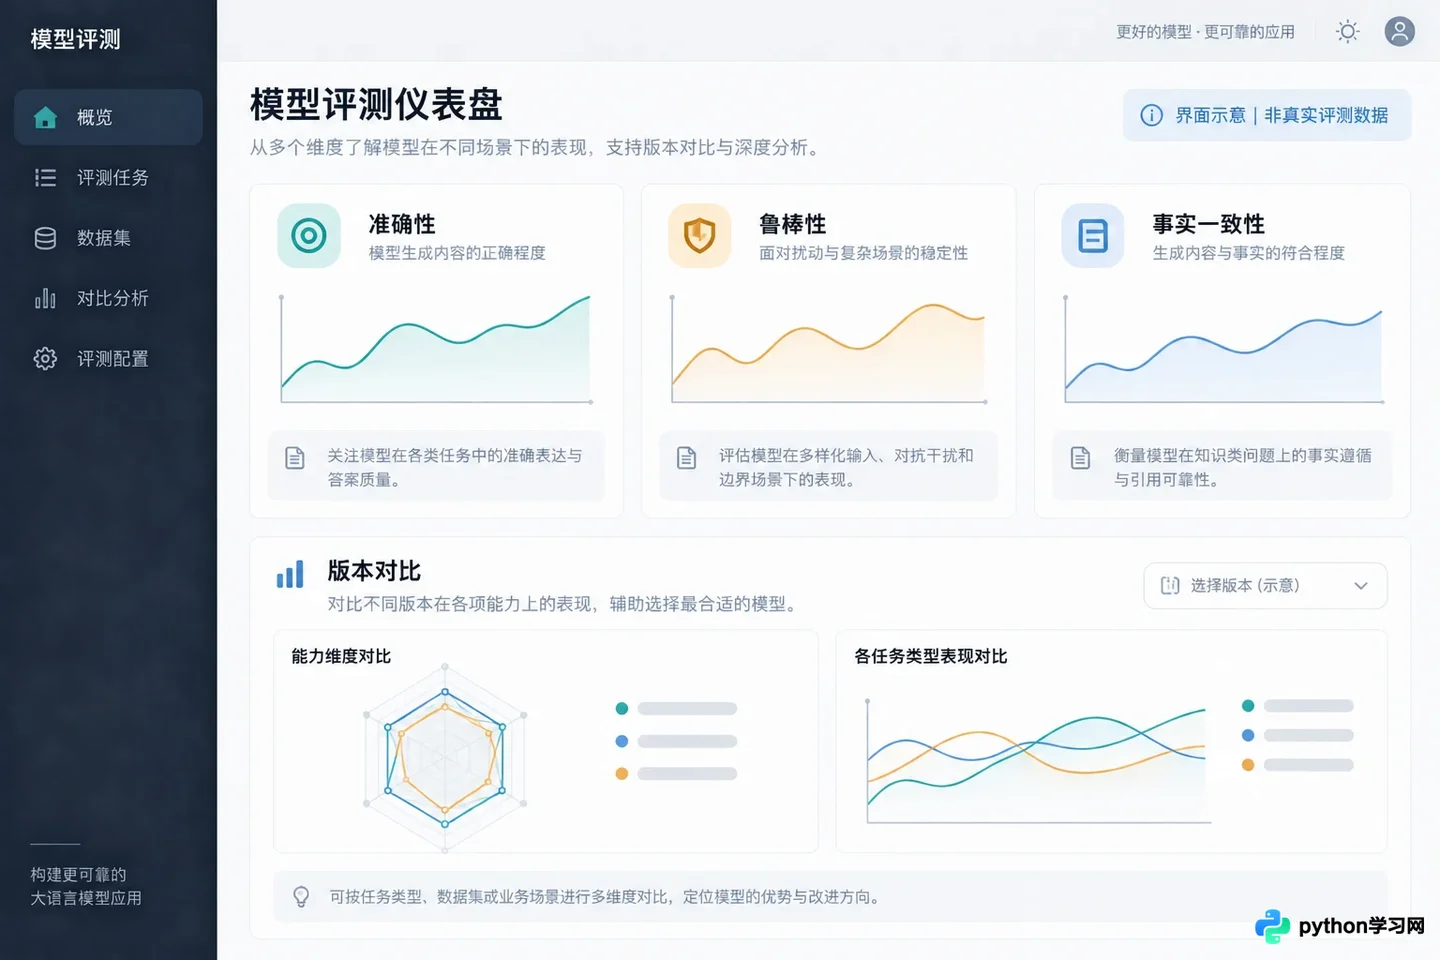
综合评估仪表盘
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









