

Python正则表达式非捕获组(?:pattern)语法详解

在 Python 正则表达式中,当我们需要将一段子模式作为一个整体附加量词(如 +、*)或进行多选分支(|),但又不希望该子模式被分配捕获编号或存入结果元组时,非捕获组 (?:pattern) 就是精准控制匹配行为的标准语法。它只负责在逻辑上建立匹配边界,不产生额外的存储开销与分组副作用。
一、为什么需要非捕获组:逻辑组合与捕获的解耦
在编写正则表达式时,圆括号 (...) 默认承担了两个完全不同的职责:
- 逻辑分组(Grouping):将多个字符或表达式绑定为一个单元,以便对其应用量词(例如
(abc)+表示匹配一个或多个abc)或进行分支选择(例如(http|https))。 - 内容捕获(Capturing):将括号内匹配到的文本截取下来,保存到内存槽位中,供后续通过序号(如
group(1))、反向引用(如\1)或在替换操作中引用。
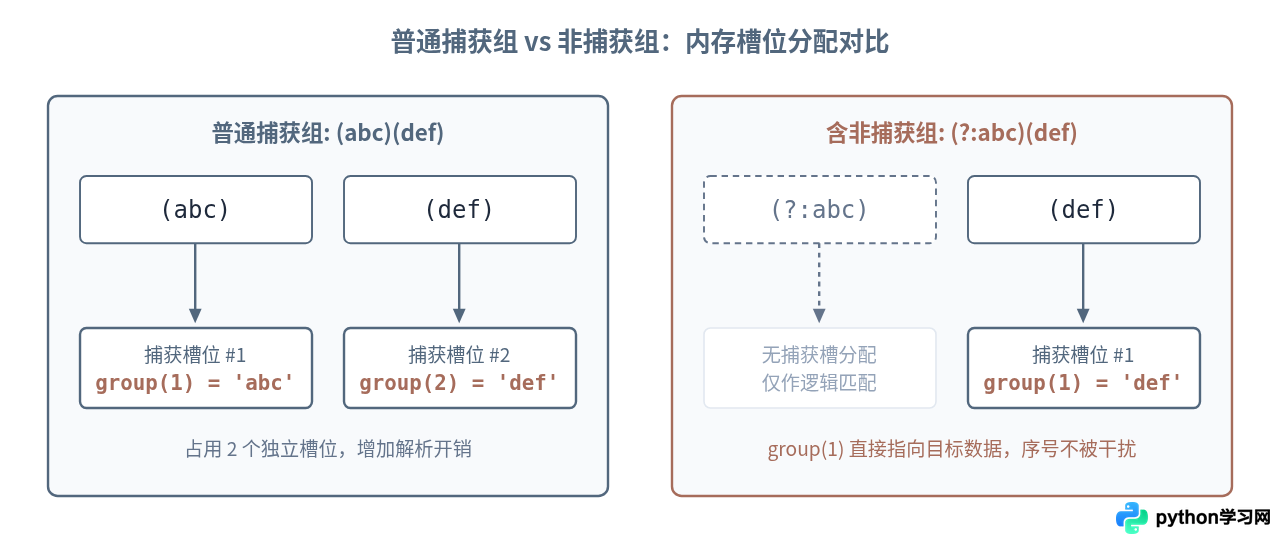
然而在绝大多数实际工程场景中,我们往往仅仅需要“逻辑分组”的能力,并不需要截取这段内容。如果继续使用普通圆括号,正则引擎会无条件为该括号分配一个数字编号,这不仅会打乱后续关键字段的提取序号,还会导致 re.findall() 的返回结构发生剧烈变化。非捕获组语法 (?:pattern) 正是为此而生:它剥离了“内容捕获”的副作用,仅保留纯粹的“逻辑分组”。
二、基本语法结构与书写要点
非捕获组的书写语法是在常规左圆括号后紧跟一个问号与冒号:(?:pattern)。请务必注意以下语法细节:
- 严格半角字符:问号和冒号必须是标准 ASCII 字符(半角字符
?和:)。如果在编写代码时不慎输入了全角符号(如?或:),Python 的re模块会抛出re.error(引发诸如 missing ) 或 nothing to repeat 的语法错误)。 - 紧凑排列无空格:左圆括号、问号和冒号之间不能出现任何空格,必须连续书写为
(?:。 - 字符消耗性:与前瞻断言不同,非捕获组是真实消耗字符的。匹配成功后,正则引擎的匹配指针会推进到非捕获组匹配结束的位置。
代码对照:捕获组与非捕获组的编号差异
import re

text = "2026-10-23"

# 案例 A:全部使用普通捕获组
match_a = re.match(r"(\d{4})(-)(\d{2})(-)(\d{2})", text)
print(match_a.groups())
# 输出: ('2026', '-', '10', '-', '23')
# 连字符 '-' 占用了 group(2) 和 group(4)

# 案例 B:将分隔符用非捕获组逻辑包裹(或直接不加括号)
match_b = re.match(r"(\d{4})(?:-)(\d{2})(?:-)(\d{2})", text)
print(match_b.groups())
# 输出: ('2026', '10', '23')
# group(1)=年, group(2)=月, group(3)=日,编号干净连续
三、四大典型应用场景深度解析
场景 1:限定多选分支的生效作用域
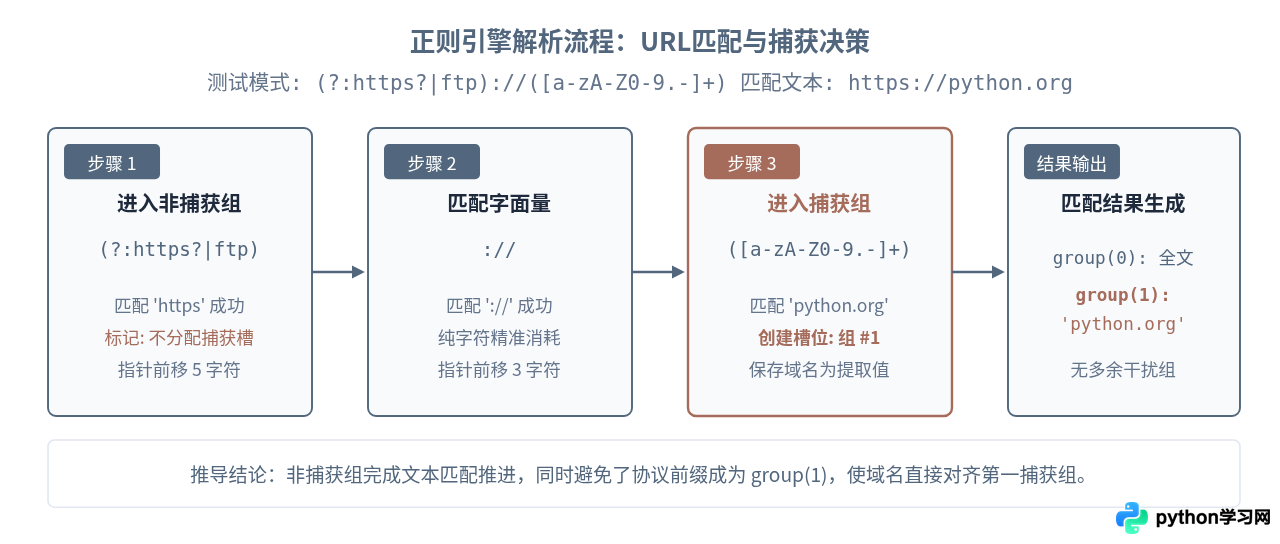
当我们需要在一段长文本中匹配多个可能的前缀时,通常会使用多选管道符 |。如果直接写 http|https://,由于管道符优先级极低,正则引擎会解析为“匹配 http”或者“匹配 https://”,这显然违背了预期。
为了限定范围,开发者通常会加括号。若使用普通括号 (http|https)://,虽然限定了分支,但协议头会被作为第 1 个捕获组返回;如果使用非捕获组 (?:http|https)://,则既正确限定了多选范围,又不会产生多余的捕获数据。
场景 2:与量词结合,实现子模式整体重复
这是非捕获组最经典的高频用法。例如匹配 IPv4 地址格式,每个网段为 1 到 3 位数字加一个点号,共重复 3 次,末尾再接一个纯数字:
import re

ip_pattern = r"^(?:(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\.){3}(?:25[0-5]|2[0-4]\d|[01]?\d\d?)$"
ip_str = "192.168.1.1"

if re.match(ip_pattern, ip_str):
print("合法 IP")在上面的正则中,(?:\d{1,3}\.){3} 将“数字加点”作为一个整体重复了 3 次。如果这里使用普通捕获组,不仅会浪费内存记录中间的重复值,而且由于重复捕获在正则中只保留最后一次迭代的值,返回的结果容易对后续解析造成巨大误导。
场景 3:避开 re.findall() 的“截断捕获”陷阱
在 Python 的 re 模块中,re.findall() 的返回规则具有一个极易让初学者困惑的机制:
- 当正则表达式中不包含任何捕获括号时,
findall()返回匹配到的完整字符串列表。 - 当正则表达式中包含捕获括号时,
findall()会丢弃全文匹配结果,只返回括号中捕获的子串;如果包含多个括号,则返回包含元组的列表。
看下面的对比示例:
import re

html = "<h1>标题一</h1><p>段落内容</p><h2>标题二</h2>"

# 错误做法:用普通括号做多选分支
res_err = re.findall(r"<(h1|h2)>.*?</\1>", html)
print(res_err)
# 输出: ['h1', 'h2']
# 严重问题:整段标签和文字都没了,只留下了括号里的标签名!

# 正确做法:若需要反向引用但必须返回全文,或者只做逻辑分支时改用非捕获组
res_correct = re.findall(r"<(?:h1|h2)>.*?</(?:h1|h2)>", html)
print(res_correct)
# 输出: ['<h1>标题一</h1>', '<h2>标题二</h2>']
# 完整 HTML 块被成功提取!
可以看到,使用 (?:...) 之后,正则表达式对于 re.findall() 而言等价于“无捕获组”,从而保证了返回的数据是完整的匹配字符串,而不是被截断的局部片段。
场景 4:高并发与大数据量下的性能与内存优化
每次捕获组匹配成功,正则引擎都需要在底层 C 结构体中分配内存以记录该组在文本中的起始与结束偏移量(即 span 索引)。在一个包含上百万行的大型日志文件或高吞吐流式清洗任务中,如果正则表达式中充斥着不必要的普通括号,正则引擎将反复执行无意义的内存分配与索引记录。
改用 (?:pattern) 后,引擎直接在内部跳过捕获状态的保存指令,能够有效减轻内存抖动并提升匹配效率。
四、Python 特殊括号语法家族辨析
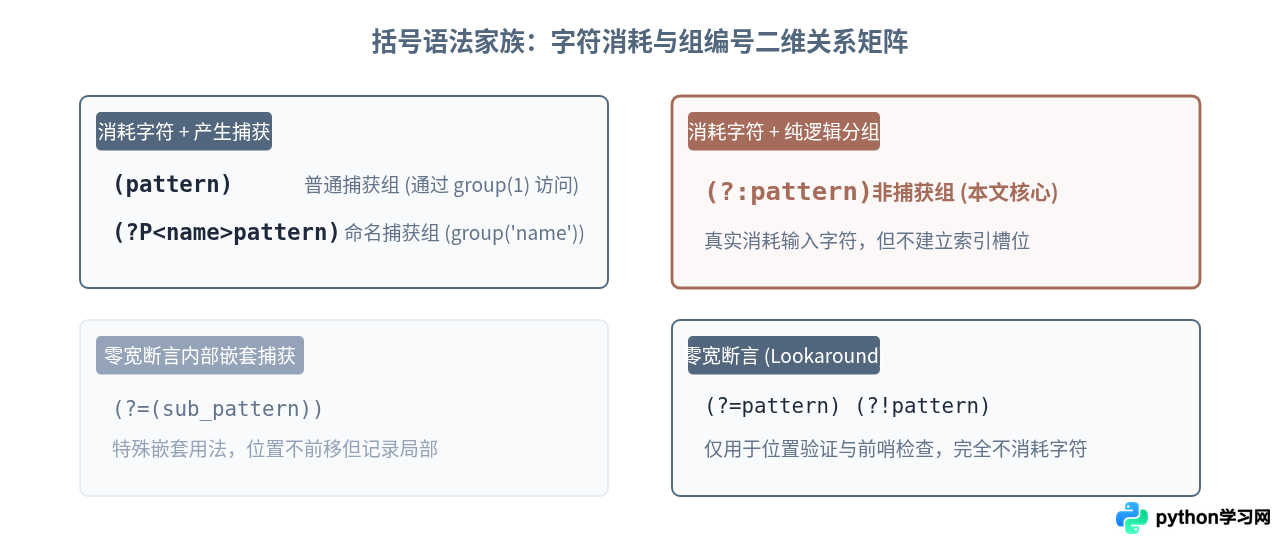
在 Python 正则中,以 (? 开头的结构构成了功能丰富的扩展语法家族。初学者极易将非捕获组与零宽断言混淆,下表对常见语法进行了明确对比:
| 语法结构 | 语法名称 | 是否消耗文本 | 是否分配捕获编号 | 核心使用场景 |
|---|---|---|---|---|
(pattern) |
普通捕获组 | 是 | 是(按数字递增) | 需要从匹配文本中抽取局部数据 |
(?P<name>pattern) |
命名捕获组 | 是 | 是(数字 + 名称) | 复杂正则中提高字段可读性与维护性 |
(?:pattern) |
非捕获组 | 是 | 否 | 逻辑绑定、限定量词范围、保持全文返回 |
(?=pattern) |
正向肯定前瞻 | 否(零宽) | 否 | 断言右侧必须满足某条件,但不计入匹配 |
(?!pattern) |
正向否定前瞻 | 否(零宽) | 否 | 断言右侧不能紧随某内容,常用于过滤 |
五、常见易错陷阱与调试要点
很多开发者在需要匹配带有某种后缀但只想要前缀时,误将非捕获组当作前瞻。例如希望从 apple_inc 中匹配 apple:
如果写成 apple(?:_inc),由于非捕获组会实际消耗 _inc,最终整个匹配到的字符串是 apple_inc,而不是 apple。此时必须使用真正的零宽断言 apple(?=_inc)。
在正则表达式中,\1、\2 是依据捕获组的左括号出现次序来建立引用的。由于非捕获组不分配序号,其后的反向引用无法指向它:
例如 (?:abc)\1 是非法的,因为不存在第 1 个捕获组,Python 会报错 re.error: invalid group reference 1。如果需要后续反向引用,就必须使用捕获组 (abc)\1。
中文输入法切换时,极易将 (?:...) 打成 (?:...)(全角问号)或 (?:...)(全角冒号)。Python 正则解析器不会容忍全角符号,务必保持英文半角输入。
六、正则分组选型决策指南
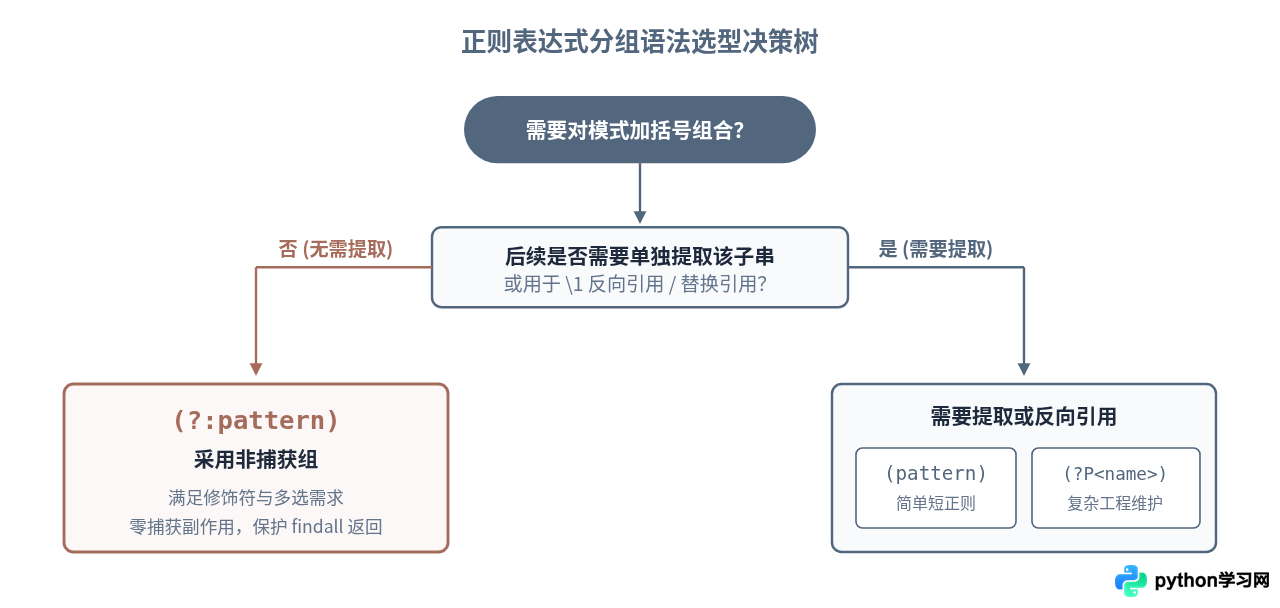
在面对具体的正则表达式编写与重构需求时,可以依据以下思维导图进行选型:
总结
掌握非捕获组 (?:pattern) 是编写稳健、高效 Python 正则表达式的关键一步。在日常开发中,只要括号的诉求是“应用数量修饰符”或“隔离多选分支”,而无需在匹配后提取其内容,就应当优先将其显式声明为非捕获组。这不仅能保持 match.groups() 与 re.findall() 的输出纯净,也能从根本上防止正则模式后续变更所引发的组序号错位问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









