

Python爬虫常见报错调试:解决ConnectionError与数据解析为空

在编写与运行 Python 爬虫时,绝大多数执行中断或采集失效可以归结为两个阶段的故障:一是发起 HTTP 请求阶段抛出的 ConnectionError 异常导致程序直接崩溃;二是请求虽然成功返回 200 OK 状态码,但在后续提取字段时选择器返回空列表或空字符串。本文通过梳理底层网络通信和页面解析的排查路径,给出可直接复现调试并修复这两类问题的具体代码和防御策略。
一、ConnectionError 的诱发机制与诊断流程
requests.exceptions.ConnectionError 是 urllib3 和套接字层多种网络连接异常的顶层包装。当客户端向目标服务器建立 TCP 三次握手失败、DNS 解析超时、代理服务器无法连通,或者目标服务器主动重置已建立的连接时,都会直接抛出该错误。由于该错误发生在应用层 HTTP 协议协商之前,爬虫根本无法获取响应体。
遇到连接错误时,不能盲目添加重试,而应遵循自底向上的顺序排查:先验证基础网络和 DNS 能否解析域名,再检查请求标头与代理隧道,最后核实服务端是否存在反爬握手阻断。
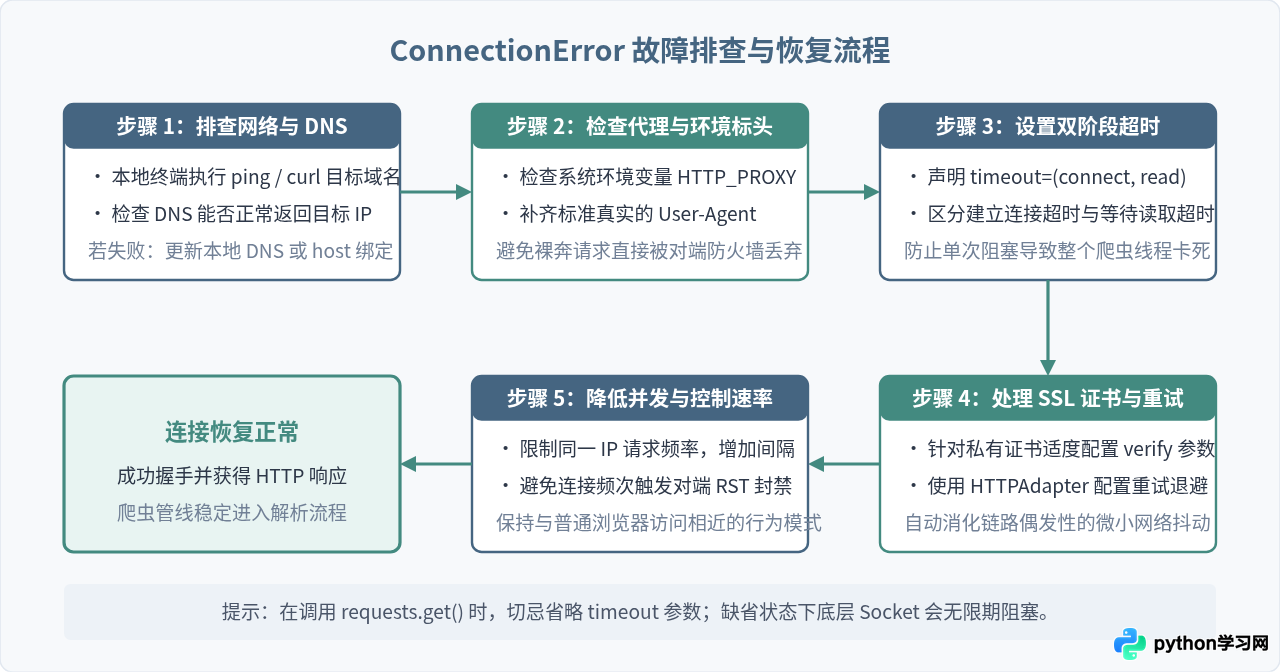
二、四类常见 ConnectionError 成因与修复策略
实际生产环境中,ConnectionError 往往伴随着具体的底层错误子类。了解具体的报错文本,能帮助我们精准采取防御措施,而不是盲目调整代码。
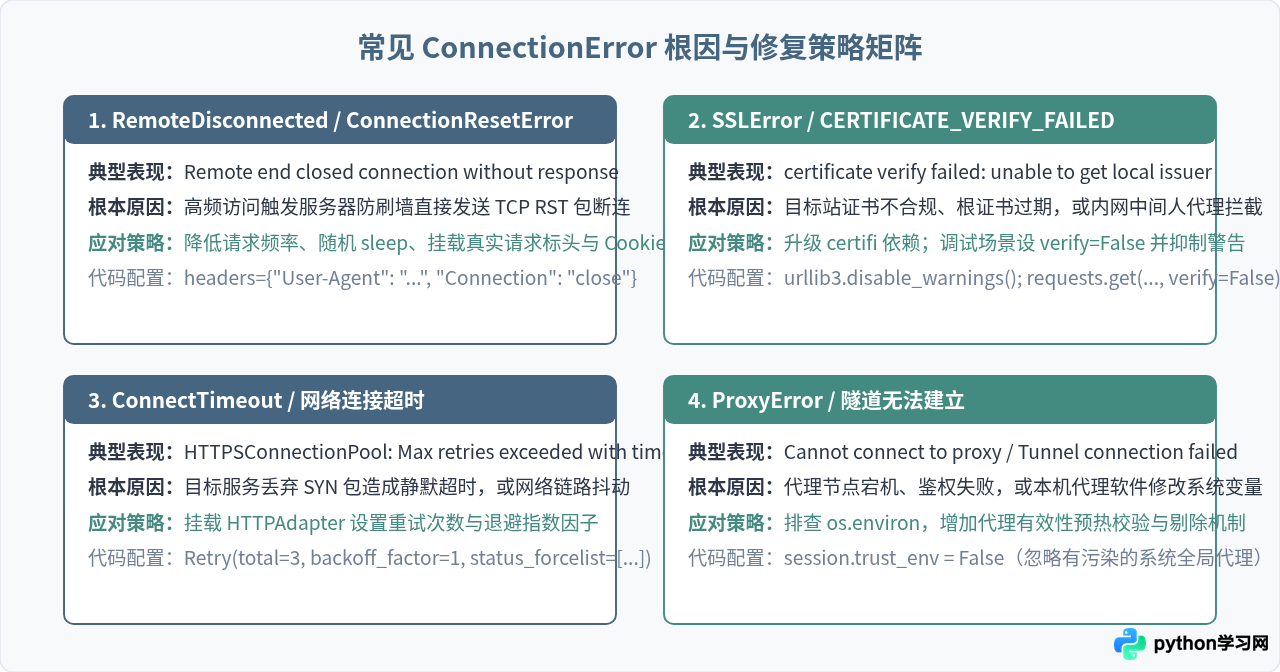
具备自动重试与异常隔离的健壮请求实现
在面对偶发网络波动和瞬时连接中断时,直接使用简单的 requests.get() 会使整个爬虫极其脆弱。应当使用 requests.Session 搭配 urllib3.util.retry.Retry 与 HTTPAdapter,实现连接池复用与基于状态码的指数退避重试:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry
import urllib3

# 禁用私有证书或不规范 SSL 引发的告警信息
urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

def create_robust_session() -> requests.Session:
    session = requests.Session()

    # 避免抓取过程中意外继承本机开启的网络代理软件配置
    session.trust_env = False

    # 定义重试策略:重试3次,退避因子为1秒(重试等待约1s, 2s, 4s),针对偶发连接错误和5xx状态码重试
    retry_strategy = Retry(
        total=3,
        backoff_factor=1.0,
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["HEAD", "GET", "OPTIONS"]
    )

    adapter = HTTPAdapter(max_retries=retry_strategy, pool_connections=10, pool_maxsize=10)
    session.mount("http://", adapter)
    session.mount("https://", adapter)

    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    })
    return session

def fetch_html(url: str) -> str:
    session = create_robust_session()
    try:
        # connect 超时设为 3.05s(避开 3s 常见超时阈值),read 超时设为 10s
        response = session.get(url, timeout=(3.05, 10), verify=True)
        response.raise_for_status()

        # 优先使用 HTTP 标头编码,若不规范则由 chardet/apparent_encoding 备选推断
        if response.encoding == 'ISO-8859-1':
            response.encoding = response.apparent_encoding

        return response.text
    except requests.exceptions.SSLError:
        # 当遇到合规性存疑的私有站点,降级重试单次(根据合规要求谨慎开启)
        response = session.get(url, timeout=(3.05, 10), verify=False)
        return response.text
    except requests.exceptions.ConnectionError as err:
        print(f"[连接失败] 目标服务无法连接或主动断开: {err}")
        return ""
    except requests.exceptions.Timeout as err:
        print(f"[请求超时] 服务器响应超出时限: {err}")
        return ""
    finally:
        session.close()
三、数据解析为空的核心诱因与四步排查法
当网络请求顺利完成,代码进入数据抽取阶段时,另一个高频报错是提取出的字段为空列表(例如 [])或返回 None,导致紧随其后的 result[0] 抛出 IndexError,或者 result.text 抛出 AttributeError。
造成数据解析为空的根源,绝大多数是由于开发者依赖 Chrome 开发者工具(F12)所看到的 DOM 树结构来编写选择器,而忽视了 Python 客户端收到的真实原始响应体差异。
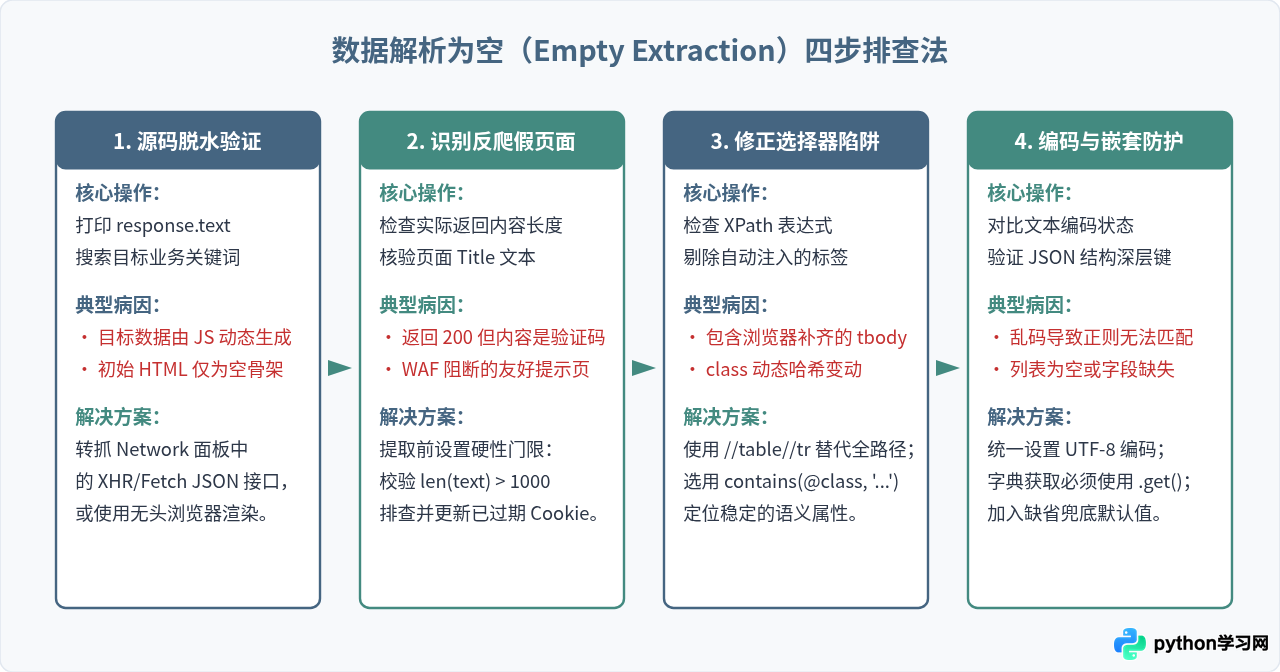
常见解析踩坑对比与修正代码
在解析 HTML 时,最致命但也最常见的误区是直接使用从浏览器中“右键 Copy XPath”获取到的绝对路径。现代浏览器解析 HTML 时会自动为 <table> 补齐 <tbody> 标签,但服务器返回的原始 HTML 文本中往往并没有这个标签,导致 lxml 的 XPath 直接命中空列表。
| 场景与问题 | 错误/脆弱写法 | 正确/防御性写法 |
|---|---|---|
| 表格 XPath 解析 | //table[@id='data']/tbody/tr(因缺失 tbody 导致匹配为空) |
//table[@id='data']//tr(使用相对递归跳过层级差异) |
| 动态 CSS 类名 | div.item-v2_8f9a2(前端构建哈希随版本频繁变更) |
div[class*="item"] 或依靠语义属性div[data-type="product-item"] |
| 取单个节点文本 | tree.xpath('//h1/text()')[0](若列表为空直接崩溃 IndexError) |
(tree.xpath('//h1/text()') or [''])[0].strip()(空列表保底) |
| JSON 多层取值 | data['result']['items'][0]['title'](无数据或结构微调直接抛 KeyError) |
(data.get('result', {}).get('items') or [{}])[0].get('title', '') |
下面是一段标准的数据提取与验证实战代码,演示如何在解析过程中执行安全校验并输出明确的排查日志:
from lxml import etree
import json
from typing import Dict, Any, List

def parse_page_safely(html_content: str) -> List[Dict[str, Any]]:
    # 第一步:前置内容有效性检查
    if not html_content or len(html_content.strip()) < 200:
        print("[解析跳过] 页面内容为空或体积异常,可能被反爬拦截")
        return []

    # 检查是否存在典型的验证码或风控标题
    if any(keyword in html_content for keyword in ["访问验证", "人机身份验证", "403 Forbidden"]):
        print("[解析告警] 检测到反爬验证页面,停止无效解析")
        return []

    # 第二步:构建解析树
    try:
        parser = etree.HTMLParser(encoding="utf-8")
        tree = etree.HTML(html_content, parser=parser)
    except Exception as err:
        print(f"[解析异常] HTML 语法树构建失败: {err}")
        return []

    if tree is None:
        print("[解析错误] 解析树对象为 None")
        return []

    # 第三步:防御性提取节点列表
    # 避免使用全路径绝对 XPath,采用相对语义定位
    card_nodes = tree.xpath("//div[contains(@class, 'goods-card')]")
    if not card_nodes:
        # 当解析为空时,打印局部结构辅助调试
        print("[调试诊断] 未命中 goods-card 节点。检查页面内是否存在同级结构:")
        fallback_divs = tree.xpath("//div[@id='content']//div/@class")
        print(f"  当前 content 下存在的 class 属性前5个: {fallback_divs[:5]}")
        return []

    results = []
    for index, node in enumerate(card_nodes):
        # 针对每个可能为空的字段,设立容错表达式
        title_raw = node.xpath(".//h3//text()")
        price_raw = node.xpath(".//span[contains(@class, 'price')]//text()")
        link_raw = node.xpath(".//a/@href")

        title = "".join(title_raw).strip() if title_raw else "未知标题"
        price = "".join(price_raw).strip() if price_raw else "0.00"
        link = link_raw[0].strip() if link_raw else ""

        results.append({
            "index": index,
            "title": title,
            "price": price,
            "link": link
        })

    return results
四、爬虫全流程稳定性与容错架构总结
要彻底摆脱频繁出现的连接错误和空数据报错,关键在于构建清晰的分层防御架构。将“盲目的异常捕获”转变为“针对各个生命周期的防御性设计”。
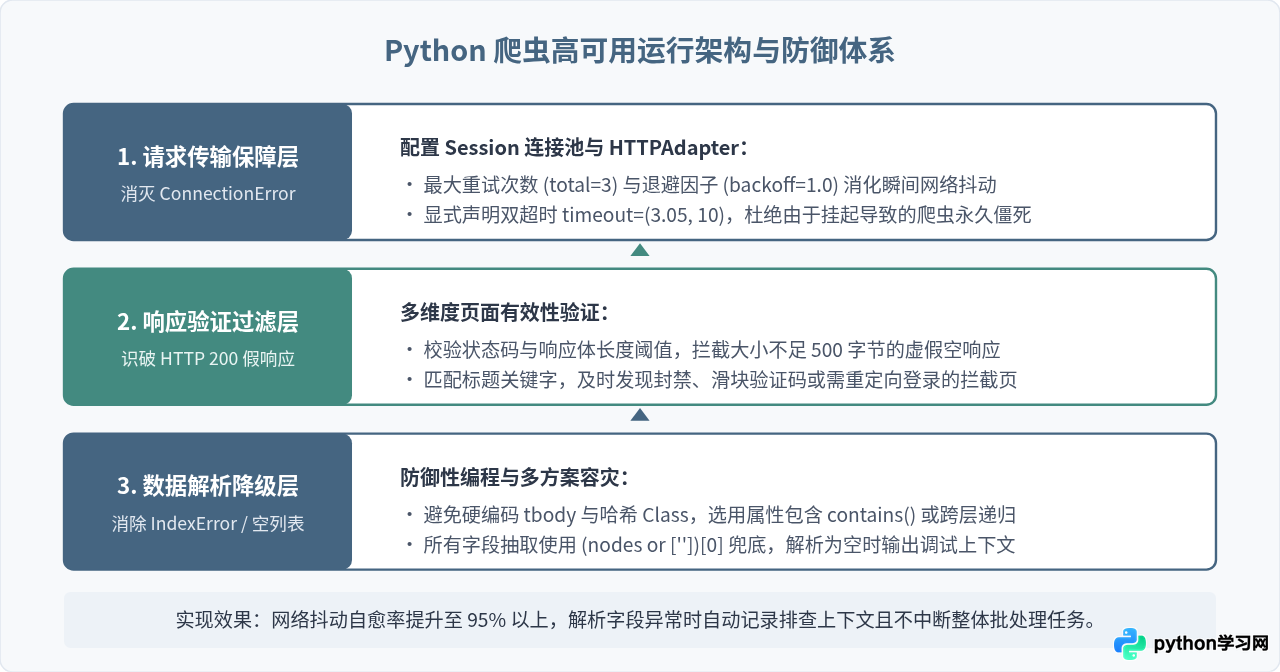
调试检查清单:当遇到爬虫突然失效时,请依次确认:① 不带爬虫代码直接在命令行 curl -I 目标URL 能否连通;② print(len(response.text)) 是否低于预期;③ 在原始文本中 Ctrl+F 能否搜到页面展示的汉字;④ XPath 是否误写了 tbody。完成这四步,即可在几分钟内定位并排除 90% 以上的常见爬虫阻断问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









