

怎么使用enumerate和zip优化Python循环遍历

range(len(seq)) 或者在外部手动维护 i += 1 来跟踪索引与遍历多组数据。这种方式不仅代码冗长、容易引发越界异常,而且违背了Python“直接迭代”的设计哲学。本文将详细讲解如何使用内置的 enumerate 与 zip 函数,优雅、高效且安全地完成带序号遍历和多序列并行配对,全面提升代码的可读性与健壮性。
一、传统索引遍历的痛点与迭代模式升级
在C语言或传统面向对象语言中,通过下标计数器访问数组是最基础的循环手段。转到Python后,不少人会写出类似下面的代码:
# 不推荐:传统下标索引方式
names = ["Alice", "Bob", "Charlie"]
for i in range(len(names)):
    print(f"序号: {i}, 名字: {names[i]}")
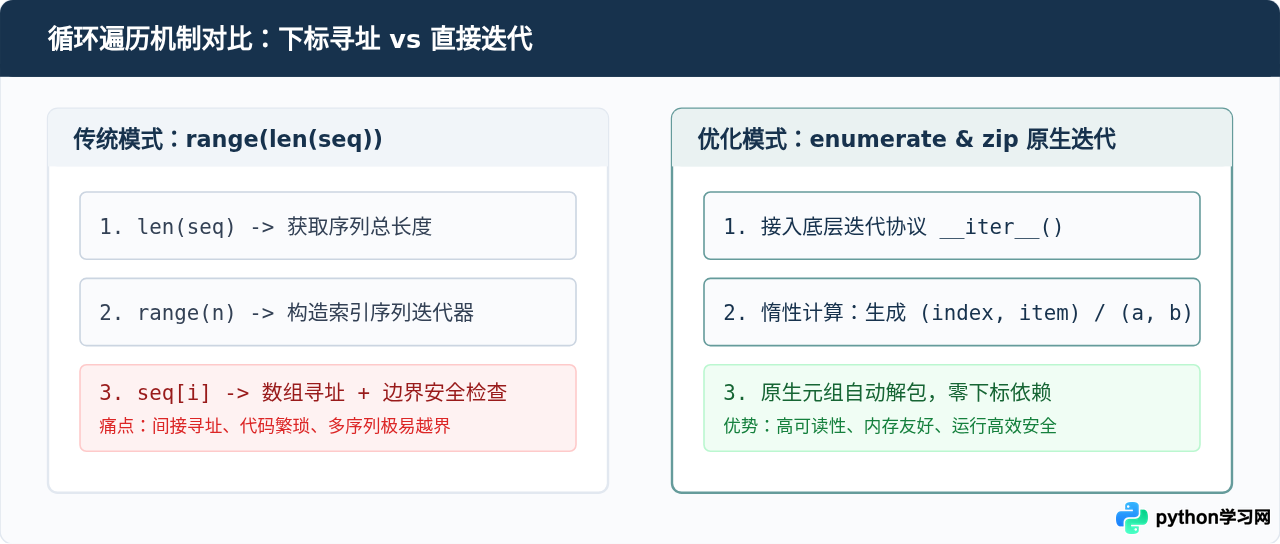
这种写法存在三个明显的缺陷:
- 双重查找开销:先通过
len()计算长度,再构造range迭代器,每次循环体内还要通过names[i]做一次随机寻址与边界安全校验。 - 容易产生越界与维护错误:如果序列在遍历过程中发生变动,或者同时维护多个独立计数器,极其容易遗漏递增或出现
IndexError。 - 违背迭代器协议直觉:Python中的列表、元组、集合乃至生成器本身就是可迭代对象(Iterable),语言底层推荐直接获取元素本身,而非通过中间索引层层间接寻址。
二、使用 enumerate 优雅处理带序号遍历
在日常业务中,我们经常需要在获取元素的同时记录当前元素的序号,例如输出带有序号的菜单、将错误日志与行号关联、或者对特定位置的元素做标记处理。这正是 enumerate 的主场。
1. 基本用法与元组自动解包
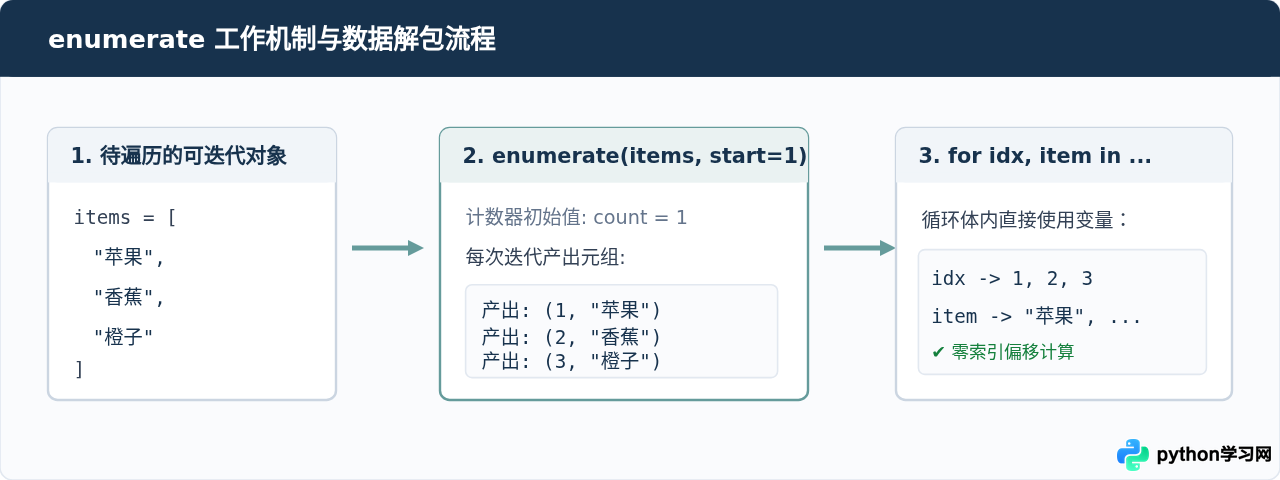
enumerate(iterable) 返回一个枚举对象,每次迭代产出一个包含 (索引, 元素) 的二元元组。我们可以在 for 循环头部直接进行变量解包:
tasks = ["需求分析", "系统架构设计", "代码编写", "单元测试"]

# 标准推荐写法
for index, task in enumerate(tasks):
    print(f"第 {index} 阶段任务: {task}")
示例输出:
第 0 阶段任务: 需求分析
第 1 阶段任务: 系统架构设计
第 2 阶段任务: 代码编写
第 3 阶段任务: 单元测试
2. 指定自定义起始序号:start 参数
默认情况下,enumerate 的计数从 0 开始。在需要面向用户展示榜单、章节或编号(从 1 开始)时,不需要在打印时写 index + 1,直接传入 start 参数即可:
fruits = ["苹果", "香蕉", "车厘子", "蜜桃"]

# 使用 start=1 从 1 开始计数
for rank, fruit in enumerate(fruits, start=1):
    print(f"Top {rank}: {fruit}")
start 还可以是任意整数,例如在分析分页数据时,如果每页 20 条,第二页的数据可以传入 start=21,从而准确对应全局数据序号。
三、使用 zip 优雅合并多序列并行遍历
当手头有两组或多组相关联的数据序列(如“姓名列表”与“成绩列表”、“表头”与“字段值”),传统做法是用同一个下标 i 去分别索引 names[i] 和 scores[i]。如果序列长度不完全一致,或者其中一个是生成器无法按索引随机访问,就会立刻崩溃。zip 函数正是为了解决这一痛点而设计的。
1. 多序列并行打包基础
zip(*iterables) 可以接收任意数量的可迭代对象,像拉链齿牙咬合一样,依次取出各个序列在相同位置的元素,组合成元组返回:
students = ["张三", "李四", "王五"]
scores = [88, 95, 91]
grades = ["B+", "A", "A-"]

# 并行遍历三个列表
for name, score, grade in zip(students, scores, grades):
    print(f"学生: {name:4} | 得分: {score} | 等级: {grade}")
示例输出:
学生: 张三   | 得分: 88 | 等级: B+
学生: 李四   | 得分: 95 | 等级: A
学生: 王五   | 得分: 91 | 等级: A-
2. 序列长度不一致的处理策略
当传入的序列长度不同时,zip 提供了明确的控制方案:
- 默认机制(短板截断):默认以最短的序列为准,多余元素会被默默舍弃。如果这符合业务预期(例如只处理完全匹配的对齐项),可以直接使用。
- 严格校验模式(strict=True):在 Python 3.10+ 中,推荐在期望序列必须等长时加上
strict=True。一旦长度不一致,会立即抛出ValueError,防止静默丢失数据。 - 缺失项填充模式(itertools.zip_longest):如果需要以最长的序列为准,缺失的位置填充默认值,可以使用标准库的
zip_longest。
from itertools import zip_longest

names = ["Alice", "Bob", "Charlie", "David"]
scores = [100, 92]

# 方案 A: 严格模式(Python 3.10+)——长度不一致报错
# for name, score in zip(names, scores, strict=True): ...

# 方案 B: 最长补全模式
for name, score in zip_longest(names, scores, fillvalue="未考试"):
    print(f"{name}: {score}")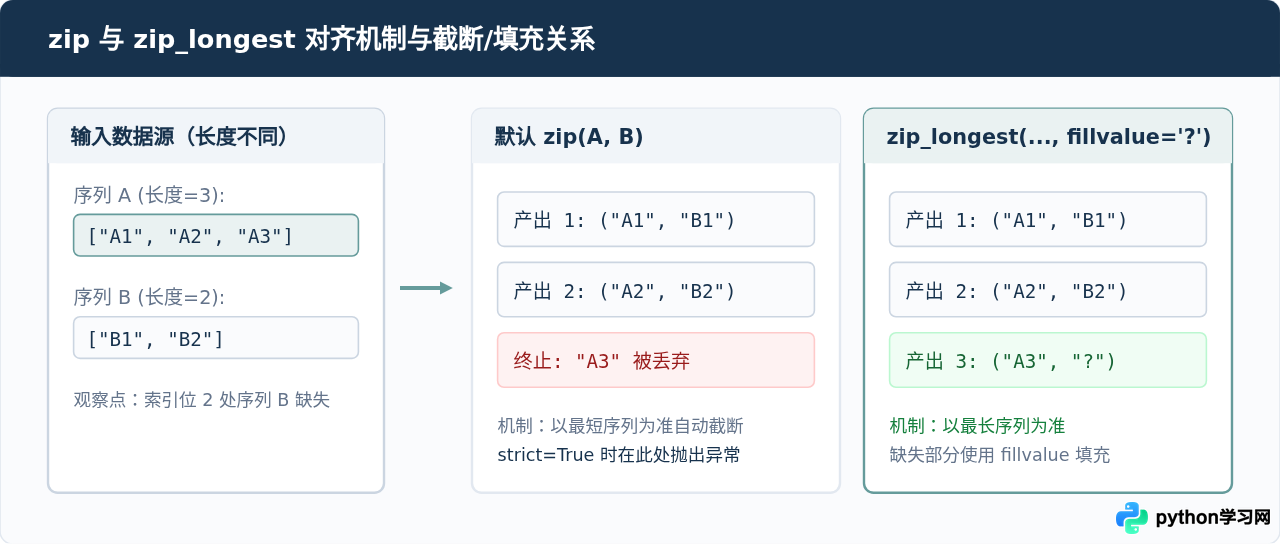
3. zip 的高效衍生用法:字典构造与矩阵转置
除了用于 for 循环,zip 也是极具表现力的数据处理原语:
- 键值对快速成字典:
dict(zip(keys, values))是一行代码将表头与行数据绑定为字典的标准做法。 - 二维矩阵解包转置:通过
zip(*matrix)可以非常轻巧地实现行转列。
# 字典构造
keys = ["name", "age", "city"]
values = ["Alice", 28, "Shanghai"]
user_dict = dict(zip(keys, values))
# 结果: {'name': 'Alice', 'age': 28, 'city': 'Shanghai'}

# 矩阵转置(行转列)
matrix = [
    [1, 2, 3],
    [4, 5, 6]
]
transposed = list(zip(*matrix))
# 结果: [(1, 4), (2, 5), (3, 6)]
四、enumerate 与 zip 的组合使用与进阶场景
在实际复杂业务中,往往既需要多序列同步对齐,又需要知道当前这一行的处理序号。此时可以将 enumerate 与 zip 嵌套使用。
正确的嵌套解包语法
很多开发者在组合使用时容易在变量解包上报错。记住:enumerate 产出的是 (索引, 元素),当元素本身是 zip 生成的元组时,必须使用括号进行嵌套解包:
users = ["张三", "李四", "王五"]
departments = ["研发部", "设计部", "运营部"]
salary_ranks = ["P6", "P5", "P6"]

# 注意:idx 对应 enumerate,(user, dept, rank) 对应 zip 内部元组
for idx, (user, dept, rank) in enumerate(zip(users, departments, salary_ranks), start=1):
print(f"[{idx:02d}] 员工: {user} | 部门: {dept} | 职级: {rank}")for idx, user, dept in enumerate(zip(...)),Python 会抛出 ValueError: not enough values to unpack (expected 3, got 2),因为外部 enumerate 每次只解开两个对象:一个是 idx,另一个是包含三个元素的元组。务必给内部变量加上圆括号 (user, dept, ...)。
五、循环遍历选型决策指南
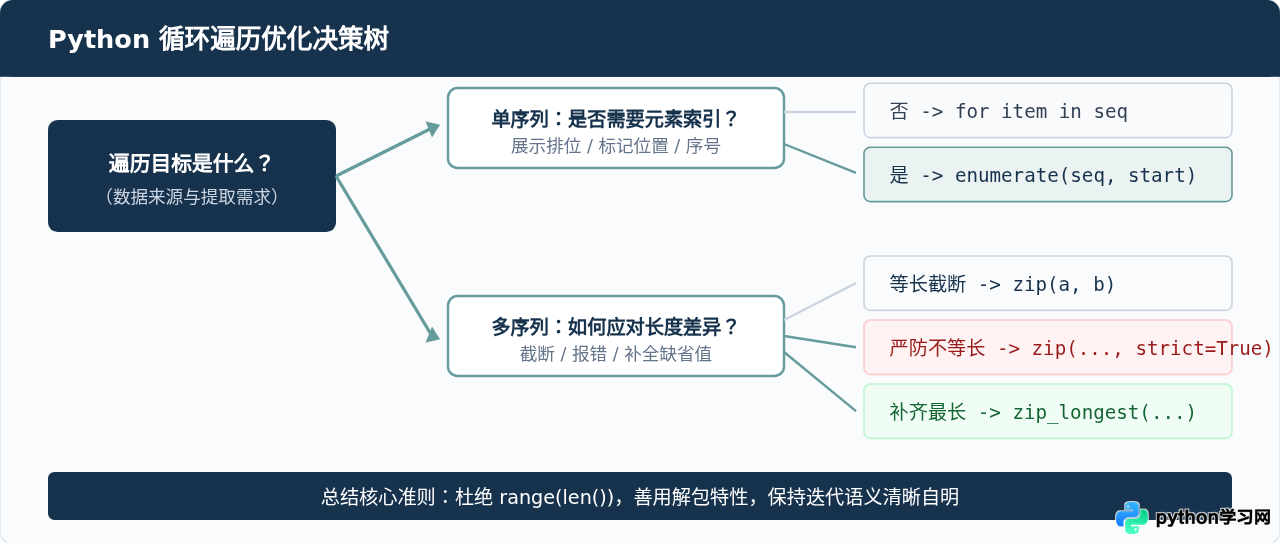
掌握了多种遍历方式后,最关键的是在具体场景下做出最合理的选型,避免过度使用或错误使用:
| 遍历需求场景 | 推荐使用方式 | 反面/不推荐写法 | 选型核心理由 |
|---|---|---|---|
| 仅读取单序列元素 | for item in items: |
for i in range(len(items)): |
直接迭代,零多余运算与索引复杂度 |
| 需要元素及其所在序号 | for i, item in enumerate(items): |
外部手动维护 i = 0; i += 1 |
自带序号流维护,防止遗漏递增或作用域污染 |
| 两组/多组序列并行读取 | for a, b in zip(list_a, list_b): |
for i in range(len(a)): a[i], b[i] |
自动配对,支持生成器,避免下标越界 |
| 多序列严格等长对齐 | zip(..., strict=True) |
自行在循环前写 assert len(a) == len(b) |
原生底层断言,快速失败并保障数据一致性 |
| 同时需要序号与多序列 | for i, (a, b) in enumerate(zip(a, b)): |
多层手动计数器 | 语法结构紧凑,解包逻辑直观清晰 |
| 遍历字典的键与值 | for k, v in d.items(): |
for i, k in enumerate(d): d[k] |
字典内置视图对象性能最优 |
六、总结与结语
掌握 enumerate 和 zip 不只是记住两个内置函数的用法,更是向真正符合 Pythonic 风格编程迈进的重要一步。在以后的代码编写中,遇到需要序号的场景,请优先调用 enumerate(seq, start=...);遇到多序列并行的场景,请使用 zip 及其现代特性 strict=True 或 zip_longest。将机械的计数器维护与越界检查交给底层迭代器,不仅能使代码大幅精简,更能让团队阅读与维护你的代码时倍感轻松与安全。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









