

Python交互式环境与脚本文件的区别及代码转换方法

Python 交互式环境(REPL)与脚本文件(.py)是 Python 程序运行的两大基本形态。交互式环境遵循“输入即求值”的即时探索模式,内存变量在指令结束后持续驻留;而脚本文件则采用“顺序加载与完整交付”的工程模式,程序自顶向下执行并在结束后完全回收资源。明确两者的执行原理差异,掌握将交互式原型代码平滑迁移为规范脚本的标准方法,是编写高质量、可维护 Python 程序的必备基础技能。
一、交互式环境与脚本文件的运行机制剖析
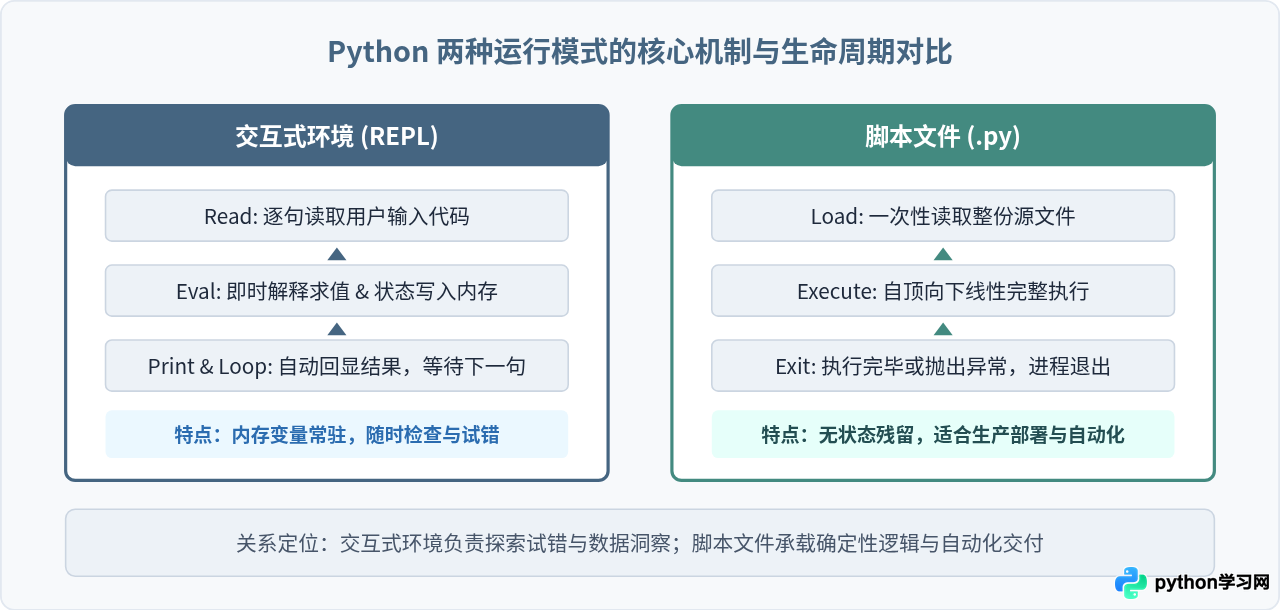
交互式环境通常指的是以命令行交互终端(如原生的 python 命令、增强型 IPython)或交互式笔记本(如 Jupyter Notebook)为代表的工作模式。它的底层依托于经典的 REPL(Read-Eval-Print-Loop) 循环结构:
- 读取(Read):监听用户输入的单行或单块代码片段;
- 求值(Eval):即时编译为字节码并在当前全局命名空间内直接执行;
- 打印(Print):如果表达式返回非空对象且未被赋值,解释器自动调用
repr()将结果回显到屏幕上; - 循环(Loop):保持当前运行时的命名空间,回到等待输入状态,随时接纳下一条指令。
与此相对,脚本文件是将 Python 代码持久化保存在文本文件(扩展名为 .py)中的独立程序单元。当通过命令 python script.py 调用时,解释器会启动一个独立的操作系统进程,将文件中的全部语句从第一行至最后一行按顺序进行语法分析、编译并整体执行。一旦所有语句执行完毕或遇到未捕获的退出信号,整个 Python 进程随即退出,所有在内存中分配的变量、对象与句柄被全部释放。
二、核心区别多维比对
为了在实际开发中准确选择工具,我们需要从以下四个维度对两者的具体表现进行区分:
| 对比维度 | 交互式环境 (REPL / Notebook) | 脚本文件 (.py) |
|---|---|---|
| 生命周期与状态 | 长期驻留。会话不关闭,前文定义的变量、类和加载的资源一直保存在内存中。 | 即用即走。进程随着执行完毕自动销毁,内存空间完全回收。 |
| 输出与反馈机制 | 隐式回显。输入未捕获的变量名或表达式,系统自动输出该对象的表示字符串。 | 显式输出。必须显式调用 print() 或 logging 模块,否则表达式静默计算不显示。 |
| 代码容错与执行流 | 非线性。可以任意回滚、修改某一步、重复执行,错误只中断当前指令,不影响全局上下文。 | 严格线性。单向自顶向下;遇到未捕获的异常会导致整个程序崩溃并抛出 Traceback。 |
| 依赖管理与外部调用 | 通常包含专属语法(如 IPython 的 %timeit 魔术命令或 !pip install 系统指令)。 |
纯粹的标准 Python 语法,支持跨模块引用、命令行参数传递及系统调度(如 cron)。 |
三、交互式代码转换为脚本文件的五步规范流程
在进行数据分析或算法原型探索时,很多开发者习惯在交互式环境或 Jupyter 中编写代码。然而,当这些逻辑需要集成到生产流水线或作为定时任务执行时,必须将其改写为规范的 .py 脚本。以下是标准化的五步转换流程:
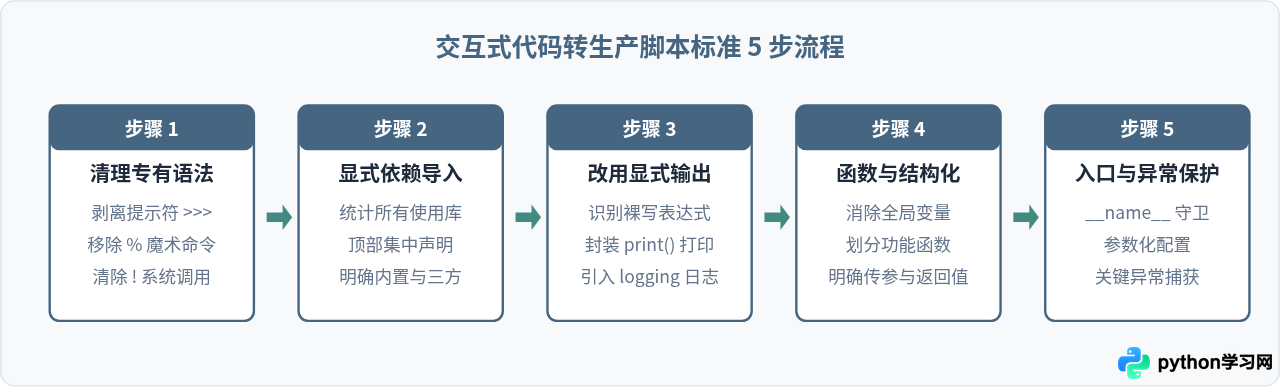
步骤 1:剔除终端专属标识与魔术命令
从命令行 REPL 复制的代码常带有 >>> 或 ... 提示符;而在 IPython 或 Jupyter 中调试的代码,则可能散落着 %matplotlib inline、%timeit 或 !ls 等特定扩展语法。脚本文件直接由 Python 解释器解析,这些非标准符号会导致 SyntaxError。在转存为 .py 文件前,必须完全删除此类行或使用标准库(如 subprocess 替代感叹号系统命令,time 模块替代测量命令)进行替代。
步骤 2:集中并显式补全模块导入
交互式环境经常在某次尝试中零散导入模块,或者依赖之前已经加载好的上下文。将零散代码合并进脚本时,容易漏掉处于前置会话中的 import 声明。应当检查全部函数与对象调用,按照 PEP 8 规范,将所有的导入语句统一置于脚本顶部,并依序分组:标准库导入、第三方库导入、本地自定义模块导入。
步骤 3:将隐式回显替换为显式输出
在 REPL 中,直接键入变量名 df.head() 即可查看数据。但在 .py 脚本中,未做赋值或操作的纯表达式会被直接忽略。如果需要向终端反馈运行状态,必须将其包装为 print()。对于工程级脚本,更推荐引入 logging 模块,以便区分调试(DEBUG)、提示(INFO)与错误(ERROR)级别,支持保存运行日志文件。
步骤 4:解构全局代码,完成函数化封装
交互式代码通常以平铺直叙的顺序脚本方式书写,所有中间变量(如 data, res, temp)均处于全局作用域。这种结构如果在脚本中长期存在,极易引发命名污染和意外覆盖。应当按逻辑职责拆分函数,把输入作为形参传入,计算结果通过 return 返回,保证函数内的高内聚与低耦合。
步骤 5:建立程序主入口与执行防护
脚本文件经常有两种用途:既能独立在终端执行,又能被其他脚本作为工具模块导入(import)。为避免导入时立即自动执行测试语句,应使用 if __name__ == '__main__': 条件作为顶层入口守卫。同时,结合 sys.exit() 返回执行状态码,便于自动化运维调度工具(如 Airflow 或 Bash 脚本)感知任务执行状态。
四、代码转换实战:从交互片段到工程脚本
以下通过一个典型的数据清洗与汇总任务,演示两者的结构对比与具体代码实现。
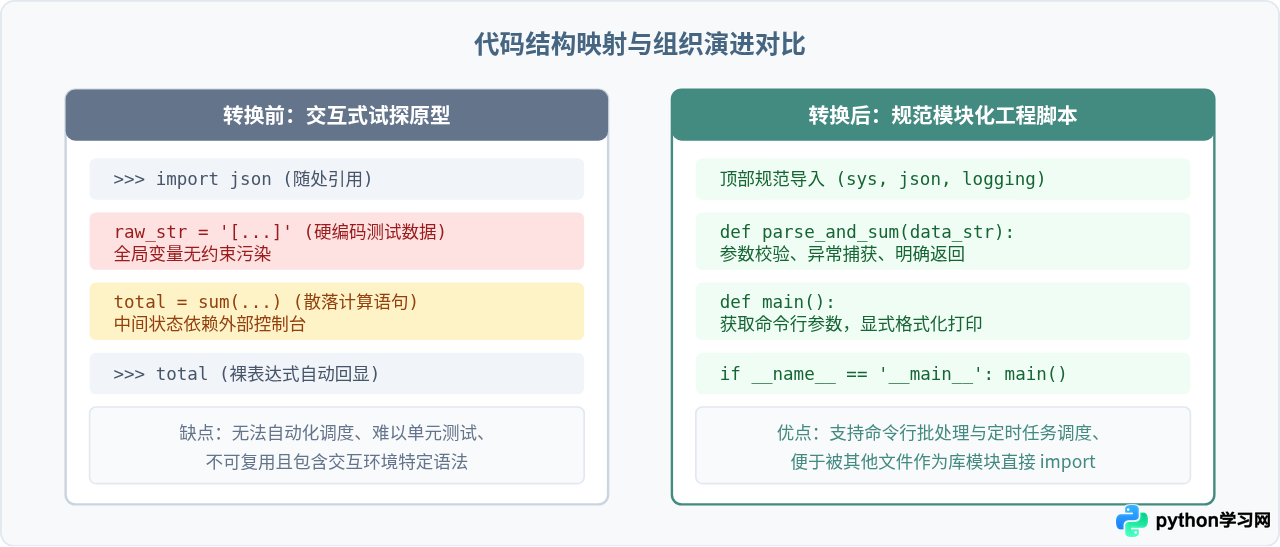
1. 原始交互式环境代码片段(试错探索阶段)
# 在 Python REPL 或 Jupyter 单元格中操作
>>> import json
>>> raw_data = '[{"name": "CPU", "cost": 120}, {"name": "RAM", "cost": 85}]'
>>> items = json.loads(raw_data)
>>> %time total = sum(item["cost"] for item in items)
>>> total
205
>>> !echo "测试完毕"
2. 规范转换后的脚本文件(calc_expense.py)
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
企业费用汇总处理模块
用于解析费用 JSON 数据并计算累计支出,支持作为 CLI 脚本或外部库使用。
"""

import sys
import json
import logging
from typing import List, Dict, Any

# 配置日志输出格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)

def calculate_total_expense(items: List[Dict[str, Any]]) -> float:
    """计算项目列表的支出总和。

    Args:
        items: 包含 cost 键的字典列表。

    Returns:
        float: 累计金额总和。
    """
    total = 0.0
    for item in items:
        cost = item.get("cost", 0.0)
        total += float(cost)
    return total

def process_expense_payload(payload_str: str) -> float:
    """解析 JSON 文本并执行汇总计算,包含基础输入校验。"""
    try:
        data = json.loads(payload_str)
        if not isinstance(data, list):
            raise ValueError("输入数据顶层结构必须为列表。")
        return calculate_total_expense(data)
    except (json.JSONDecodeError, ValueError) as err:
        logging.error("数据解析失败: %s", err)
        raise

def main() -> int:
    """主程序入口:读取数据并打印汇总结果。"""
    sample_data = '[{"name": "CPU", "cost": 120}, {"name": "RAM", "cost": 85}]'

    logging.info("开始执行费用汇总任务...")
    try:
        total = process_expense_payload(sample_data)
        print(f"最终计算结果: 支出总计 = {total:.2f}")
        logging.info("任务顺利完成。")
        return 0
    except Exception as exc:
        logging.critical("程序运行出现严重错误: %s", exc)
        return 1

if __name__ == "__main__":
    exit_code = main()
sys.exit(exit_code)关键改进解析:重构后的脚本完全移除了 %time 魔术命令与 !echo 终端指令;把计算逻辑封装进带有类型注解的纯函数;引入了异常校验与系统日志;并通过 if __name__ == "__main__": 确保了既能在 Shell 命令行中直接跑批,又能被测试用例安全导入。
五、脚本文件反向调入交互式环境的高效调试技巧
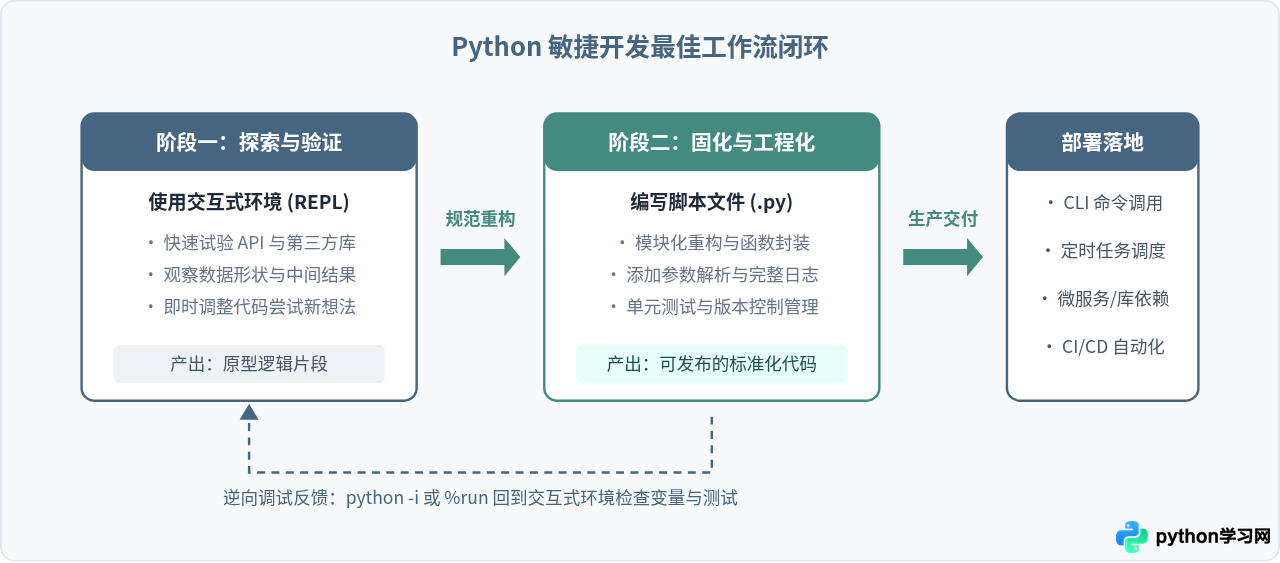
代码转换并不是单向的单行道。在工程开发中,常常出现“把逻辑写成脚本后,需要借助交互式环境在特定节点断点检查或调试数据”的需求。以下介绍两种逆向交互技巧:
1. 使用 python -i 保持执行后上下文
在命令行运行脚本时添加 -i 参数:
$ python -i calc_expense.py
2026-10-21 22:15:00 [INFO] 开始执行费用汇总任务...
最终计算结果: 支出总计 = 205.00
2026-10-21 22:15:00 [INFO] 任务顺利完成。
>>>
脚本完整执行完毕后,进程不会销毁,而是直接进入原生的 Python REPL。此时用户可以直接访问 calc_expense.py 中定义的函数、全局变量以及执行结果,快速进行验证与手动测试。
2. 在 IPython 中使用 %run 与动态重载
如果使用 IPython 或 Jupyter,可以在交互控制台中输入:
In [1]: %run calc_expense.py
In [2]: calculate_total_expense([{"cost": 300}, {"cost": 150}])
Out[2]: 450.0
若外部脚本文件发生修改,可以使用 Python 内置的 importlib.reload() 重新加载模块,而无需重启整个交互式解释器环境,显著提升调试效率。
六、工作流选型指南与开发闭环总结
在日常 Python 项目中,交互式环境与脚本文件不是对立的关系,而是敏捷研发工作流的两个阶段:
核心避坑清单
- 隐性顺序依赖:在 Jupyter 中跳跃执行单元格(例如先执行单元格 3 再执行单元格 1)往往能正常输出,但写入
.py脚本后因线性执行顺序报错。迁移时务必从头至尾检查变量的首次定义点。 - 相对路径基准问题:在交互式环境中,当前工作目录通常锁定在启动控制台的位置;而在脚本中,执行位置可能由外部调度命令改变。建议使用
pathlib.Path(__file__).resolve().parent来基于脚本文件自身定位资源路径。 - 外部资源与网络连接未关闭:在交互式环境中打开的文件或数据库连接长期驻留不会立即报错,但在并发或批处理脚本中若不使用
with上下文管理器,容易导致句柄耗尽。
通过合理结合交互式环境的高效探索特性与脚本文件的稳健交付能力,能够建立从快速原型验收到高可靠代码交付的专业 Python 开发流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









