

Python爬虫抓取租房数据并基于高德地图可视化展示
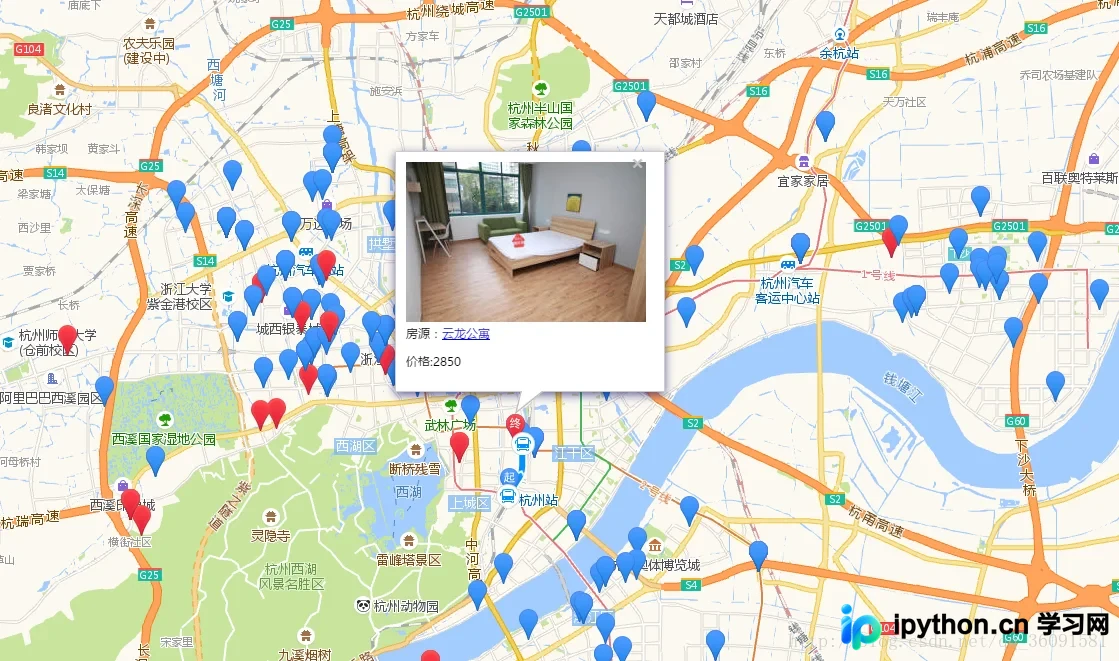
本文介绍使用Python爬虫技术抓取58同城杭州地区特定价格段的公寓房源数据,并通过高德地图API将房源位置、价格等信息可视化展示在地图上。文章包含Python后端抓取逻辑与前端HTML/JS交互代码,支持工作地点筛选及通勤方式计算,帮助开发者快速实现房源地图展示功能。
2026-10-13
6

本文介绍使用Python爬虫技术抓取58同城杭州地区特定价格段的公寓房源数据,并通过高德地图API将房源位置、价格等信息可视化展示在地图上。文章包含Python后端抓取逻辑与前端HTML/JS交互代码,支持工作地点筛选及通勤方式计算,帮助开发者快速实现房源地图展示功能。
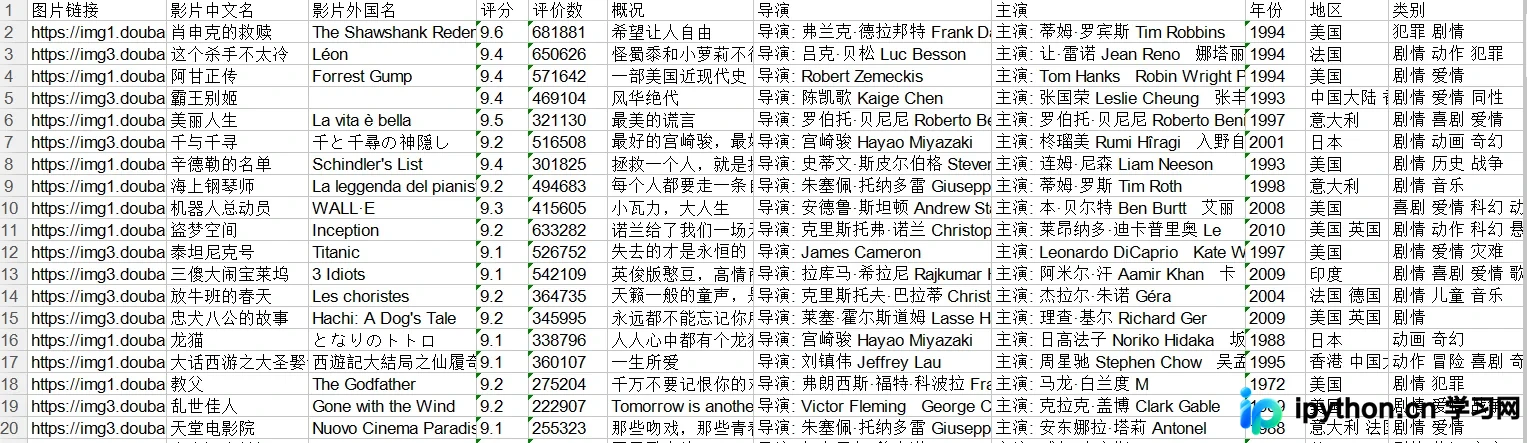
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
本文深入讲解Python爬虫中requests库的高级应用。通过GET与POST请求实例,演示如何构造Headers与Params;结合拉钩网案例解析数据抓取逻辑;详细介绍代理IP配置方法以规避封禁;最后通过人人网登录示例,阐述利用Session对象保持会话状态及Cookie管理的完整流程。
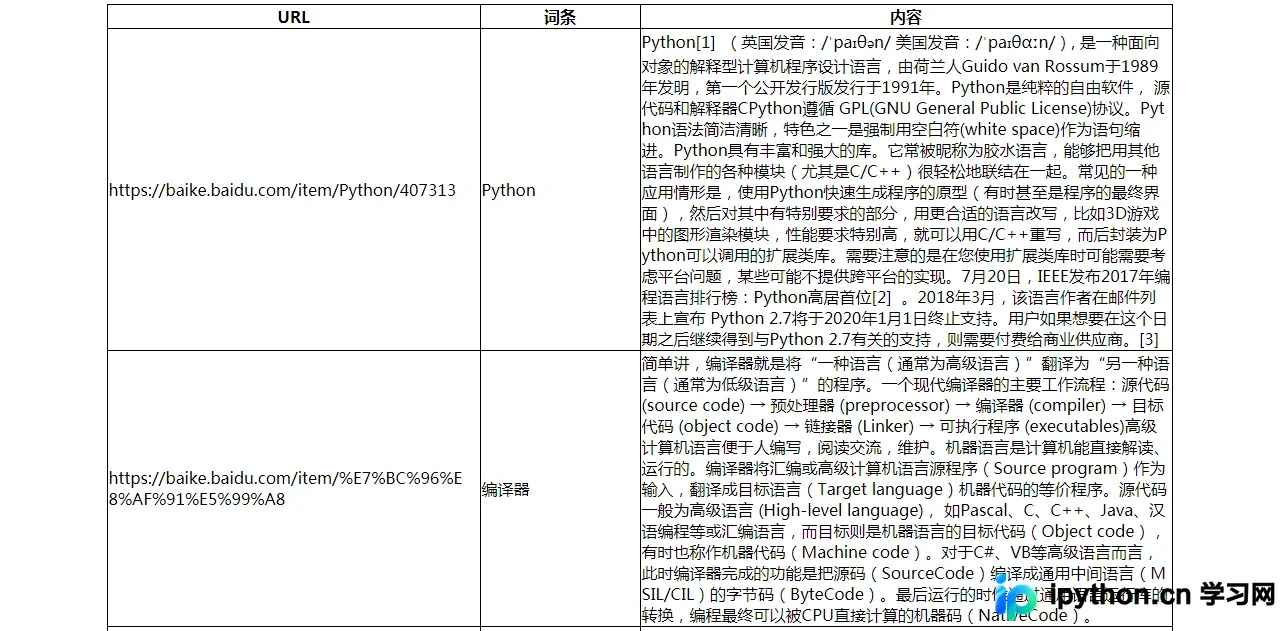
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
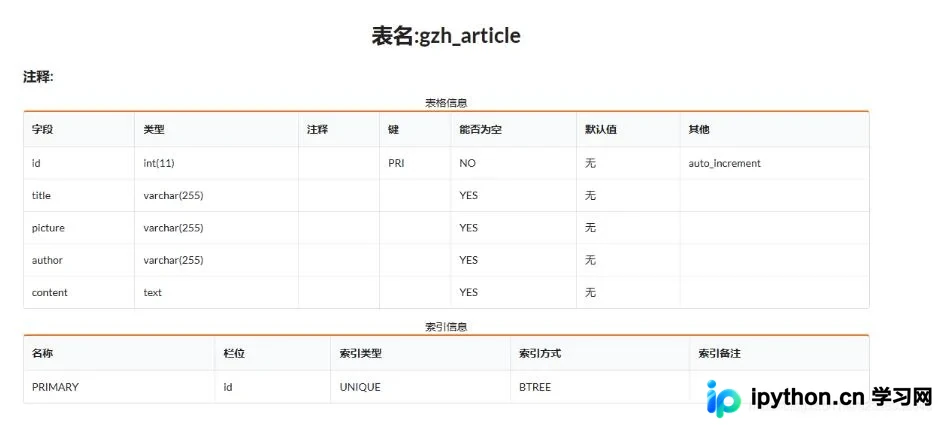
本文介绍如何使用Python编写爬虫程序,通过搜狗微信搜索接口抓取公众号文章标题、封面及正文内容,并利用pymysql库将数据持久化存储到MySQL数据库中。代码示例展示了数据库连接、数据去重检查及插入逻辑,供初学者参考学习。
本文系统介绍Python爬虫的基本概念、应用场景及合法性边界。详细解析常见的反爬虫手段,如IP限制与数据投毒,并梳理Python在爬虫开发中的核心优势。重点列举了请求处理、多线程、正则解析、JSON处理及DOM解析等关键模块,为开发者提供清晰的技术选型参考。
本文详细解析使用Python爬取微博特定用户评论的技术流程。针对微博主页及详情页的Ajax动态加载特性,通过逆向分析接口规律获取数据。重点介绍如何处理源码中的转义字符与HTML实体编码,利用正则表达式提取关键ID,并拼接评论接口URL。文中包含完整的代码实现及Cookie配置注意事项,旨在帮助开发者掌握动态网页数据抓取的核心技巧。
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
本文分享利用Python抓取CNVD工控漏洞库信息的完整流程。针对网站反爬虫机制,通过模拟请求头、Cookie及Selenium自动化浏览器技术解决访问限制。代码涵盖从分页URL抓取到详情页信息提取的全过程,旨在帮助安全研究人员高效整理漏洞数据。
本文详细解析利用Python爬虫技能实现经济收益的两种主要路径。针对在校大学生,建议从少量数据抓取入手,掌握基础库、HTML解析及存储技术,避免承接高风险监控或大规模项目。对于在职IT人员,凭借丰富的工程经验与流程熟悉度,可挑战大规模抓取、监控及移动端模拟登录等高收益任务。文章提供了针对性的技术建议与项目选择策略,帮助不同阶段的技术人员合理评估难度与收益。
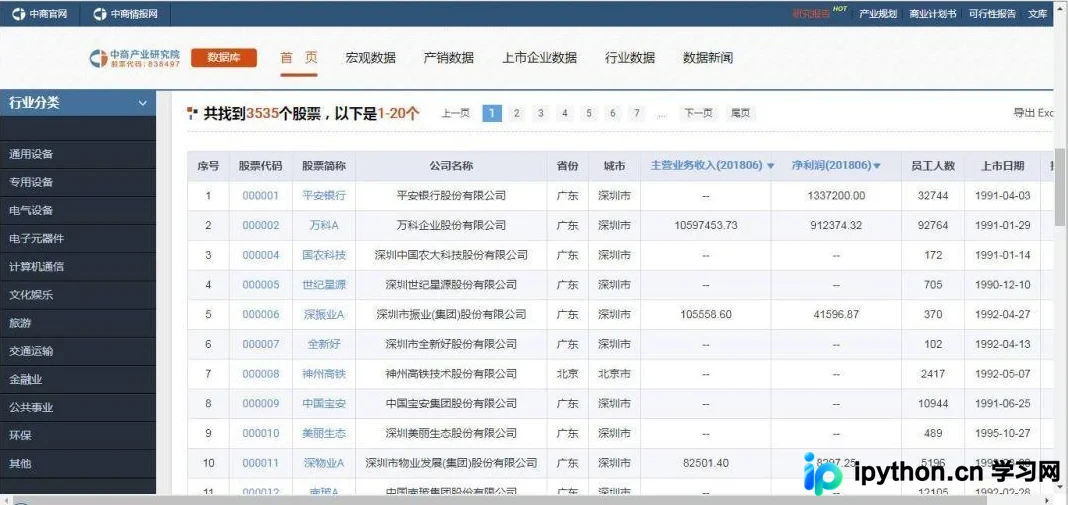
本文通过Python爬虫实战,展示如何从简单的5行代码逐步完善,最终实现爬取3000多家上市公司信息。文章涵盖环境配置、异常处理、灵活性优化及多进程加速等技巧,帮助初学者快速掌握爬虫开发流程。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。