

Python实现无账号无限制抓取企查查企业数据:Selenium与Web接口实战
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
2026-10-13
6

本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
本文介绍使用Python爬取手机号前7位归属地的实现方案。通过对比单线程与多线程版本,展示从耗时1个半小时到2-3分钟的优化过程。单线程处理10000次查询需约90分钟,而多线程(32线程)处理1000条数据仅需2-3分钟,CPU占用约70%。最终40多个号段、41万条数据的爬取总耗时约1-2小时,提供了完整的代码示例与性能数据。
本文详细介绍如何使用Python的requests库发送HTTP请求获取网页内容,并结合BeautifulSoup库解析HTML结构。通过百度首页及51job招聘网站两个具体案例,演示了处理编码问题、设置请求头防反爬以及提取特定文本信息的完整流程,帮助开发者掌握基础的网络数据采集技能。
本文详解如何利用Python爬取爱奇艺非VIP视频。通过构造搜索URL并分析分页规律,使用requests获取页面源码,结合BS4库解析HTML标签提取视频链接、标题及描述信息。针对作者信息位置不固定的问题,采用try-except机制进行容错处理,确保数据抓取的完整性与稳定性。
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文介绍如何使用Python通过16行代码批量下载王者荣耀高清皮肤。教程涵盖获取英雄列表JSON、解析皮肤URL规则、利用urllib.urlretrieve下载及文件管理逻辑,帮助开发者快速掌握基础爬虫技巧。
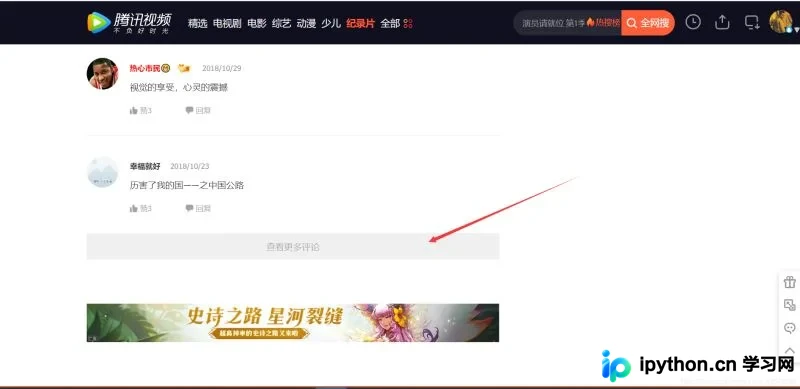
本文详解如何使用Python爬取腾讯视频纪录片评论。通过Fiddler抓包分析Ajax异步加载机制,解析评论接口URL规律,重点推导cursor参数的获取逻辑。结合Python代码实现自动翻页抓取,完整展示从环境配置、接口分析到代码编写的全过程,帮助开发者掌握动态网页数据抓取的核心技巧。
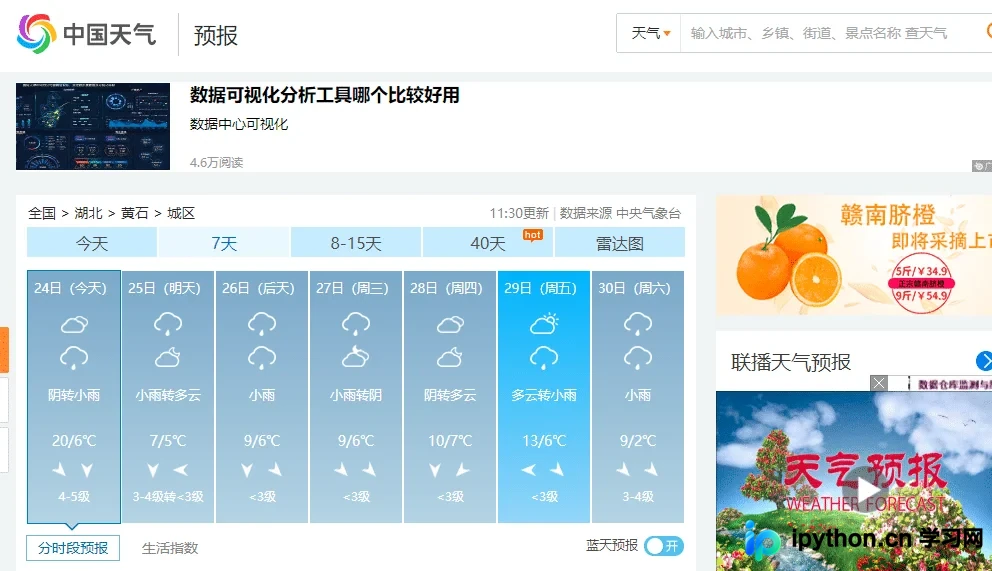
本文介绍使用Python抓取中国天气网城市近7天天气预报的完整流程。通过F12开发者工具分析HTML结构,定位日期、温度、风向等关键标签,编写Requests请求与BeautifulSoup解析代码,实现数据提取与格式化输出,并提供完整示例供参考。
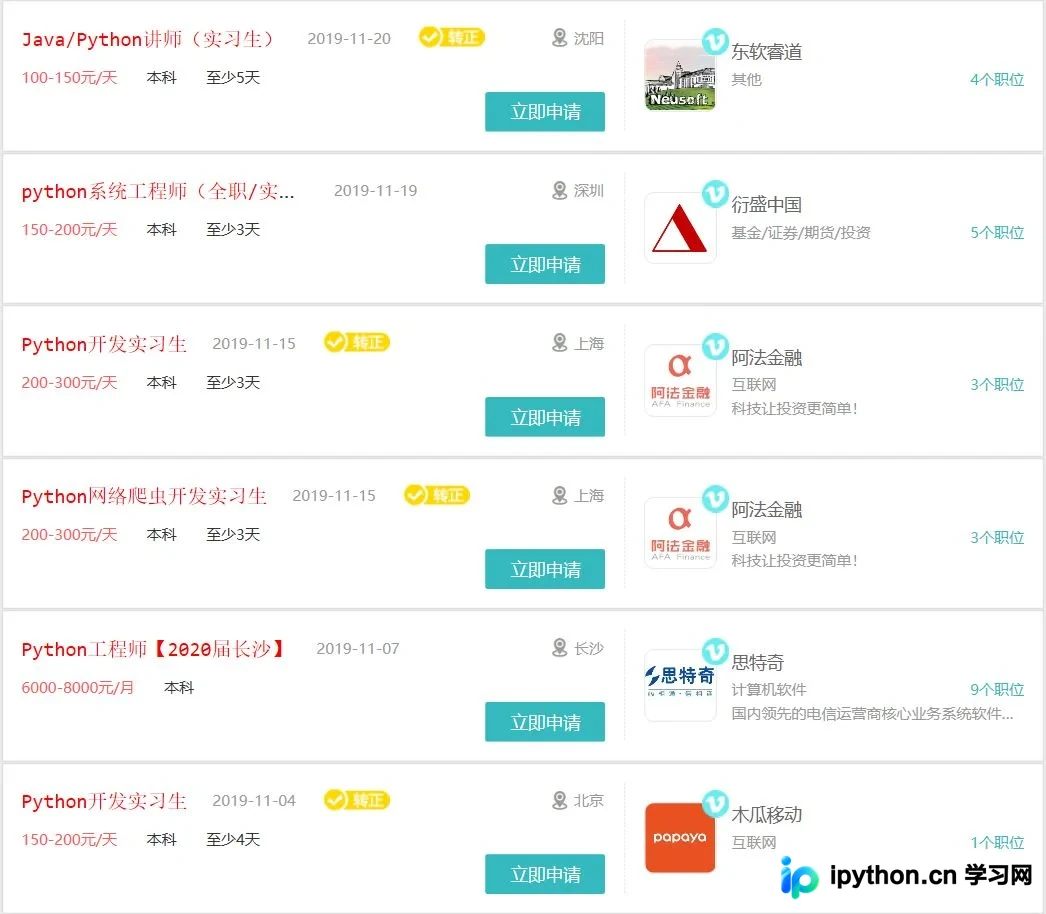
本文详细介绍利用Python和Beautiful库进行网页数据爬取的完整流程。内容涵盖查看网页源码、使用requests获取HTML、通过BeautifulSoup解析特定标签提取公司名称、职位及薪资信息,并将结果追加存储至CSV文件。此外,文章还演示了如何通过循环处理URL中的页码参数,实现多页数据的批量抓取与保存。
本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。