

Python爬虫实战:使用正则表达式与BeautifulSoup爬取豆瓣Top250
本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。
2026-10-14
5

本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。
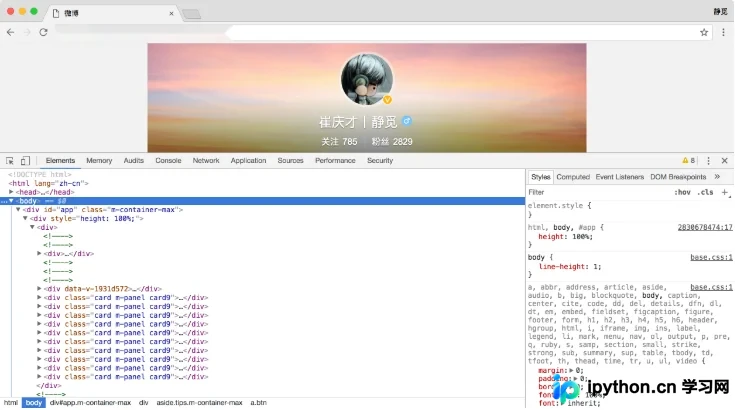
本文详解如何使用Chrome开发者工具分析微博等网站的Ajax动态加载内容。通过Network面板定位XHR类型请求,解析Request Headers中的XMLHttpRequest标识及JSON响应数据,并结合XHR筛选功能高效捕获所有异步请求,为Python程序模拟请求和提取数据奠定基础。
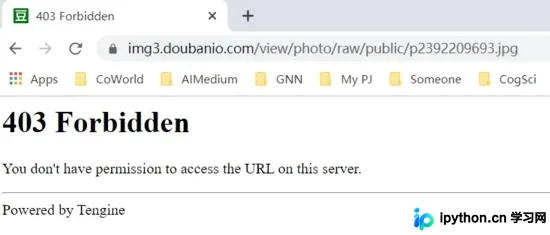
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
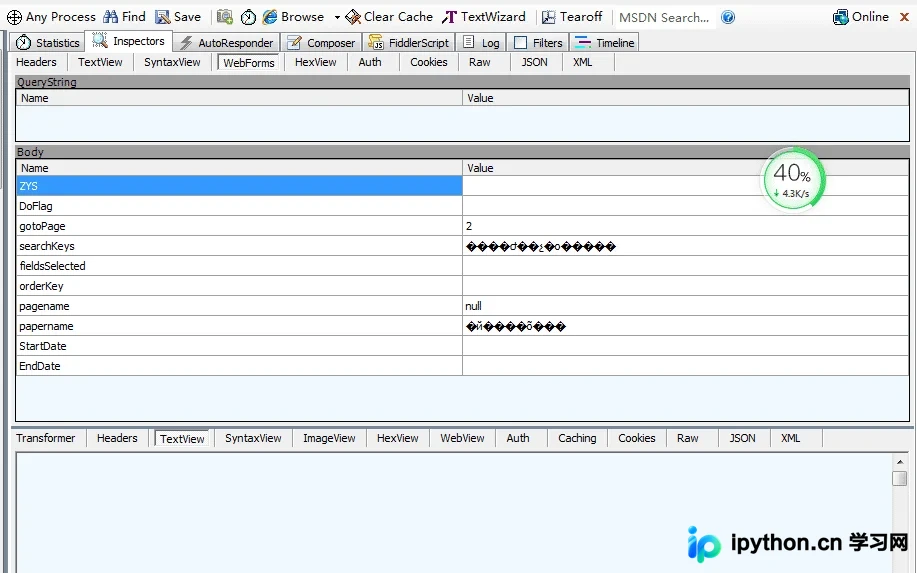
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
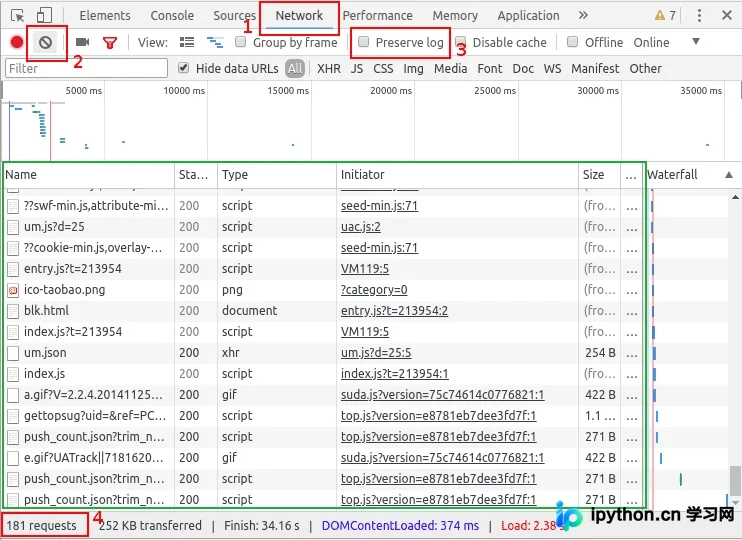
本文详解Python爬虫中Chrome浏览器F12开发者工具的使用。针对网页HTML源码中缺失但页面可见的数据,解析Ajax异步加载原理。通过Network面板筛选请求,利用Headers重建HTTP请求,结合Preview和Response获取目标数据,帮助开发者高效编写爬虫脚本。
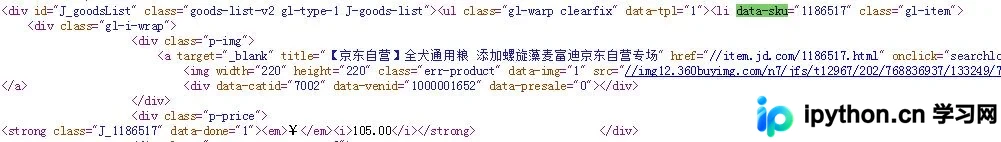
本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
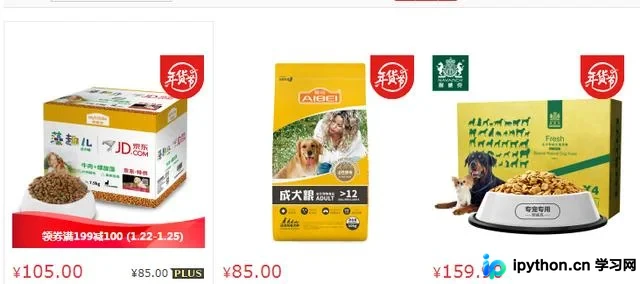
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
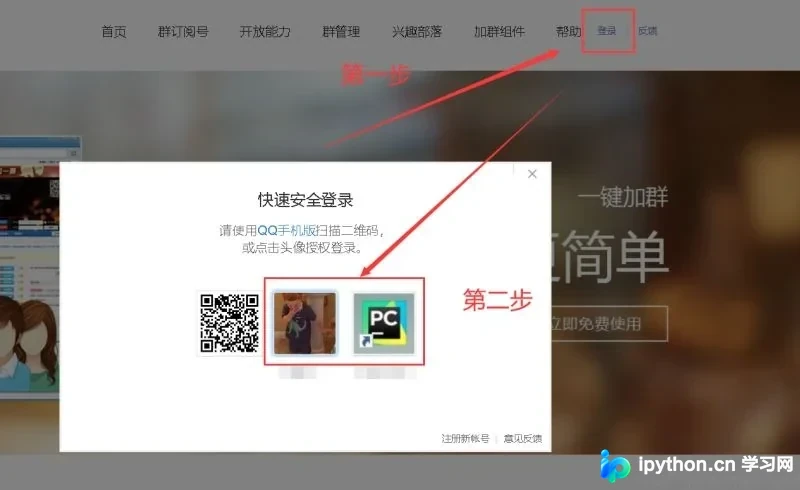
本文介绍使用 Python Selenium 自动化抓取 QQ 群成员信息的完整流程。通过模拟浏览器登录、选择目标群组及动态滚动加载页面,提取群成员列表。代码重点展示了如何清洗数据,去除群主和管理员身份,并仅保存普通成员的 QQ 号至本地文件,适用于需要批量获取群成员联系方式的场景。
本文详细讲解Python中requests库的多种实用技巧。内容涵盖库的安装、GET与POST请求的参数及头部设置、代理IP的配置方法,以及通过获取Cookie和使用Session对象实现自动登录和状态保持。适合希望提升爬虫效率与稳定性的开发者参考。
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
本文介绍使用Python爬取手机号前7位归属地的实现方案。通过对比单线程与多线程版本,展示从耗时1个半小时到2-3分钟的优化过程。单线程处理10000次查询需约90分钟,而多线程(32线程)处理1000条数据仅需2-3分钟,CPU占用约70%。最终40多个号段、41万条数据的爬取总耗时约1-2小时,提供了完整的代码示例与性能数据。