Python爬虫识别页面类型的三种策略与类设计
本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。
2026-10-13
6

本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。
本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
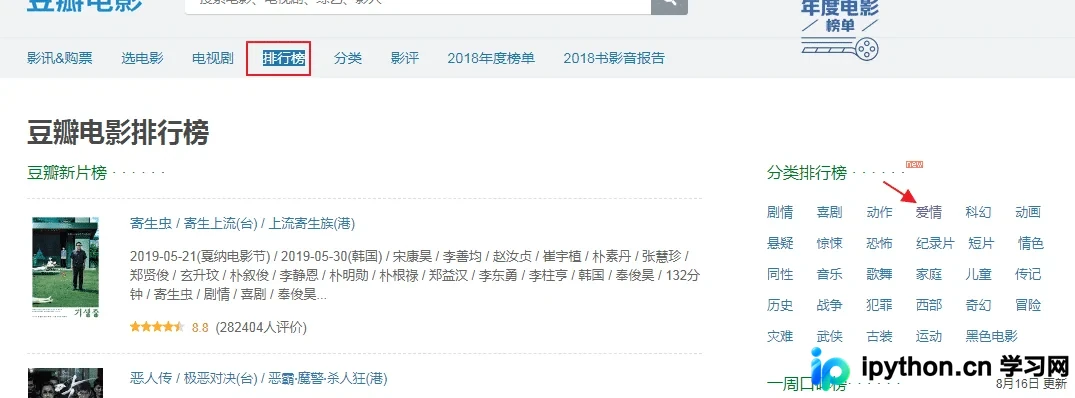
本文详细介绍如何使用Python的pyquery库爬取豆瓣电影信息。通过示例代码展示如何获取电影源代码、解析链接并提取观看地址。文章包含完整代码逻辑及输入“天气之子”、“独立日”等电影名的运行结果截图,强调仅上映电影可获取观看链接,为Python学习者提供实用的爬虫参考。
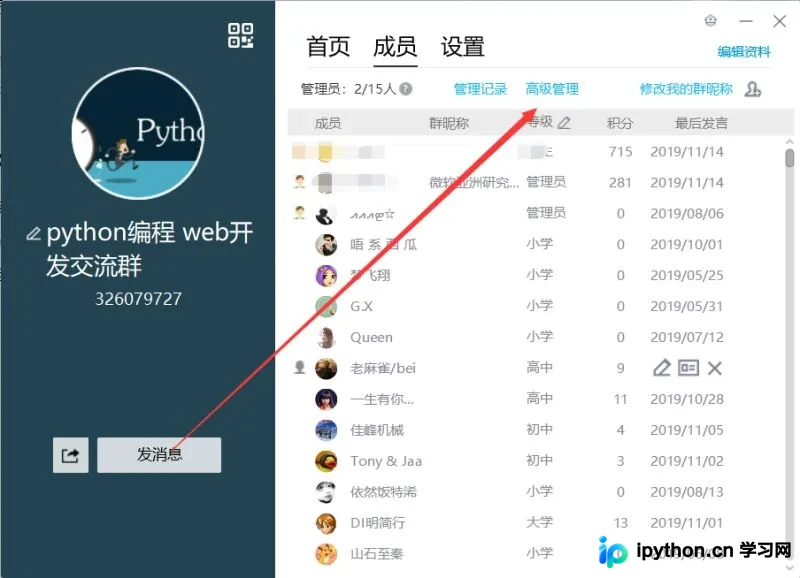
本文介绍如何使用Python和Selenium库自动化获取QQ群成员信息。通过模拟浏览器操作,自动登录并滚动加载页面,提取群成员昵称、QQ号等字段,最终导出为Excel文件。适用于拥有群主或管理员权限的场景,代码示例包含环境配置及核心抓取逻辑。
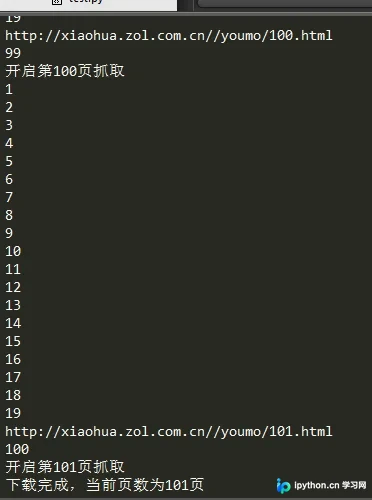
本文介绍使用Python爬取幽默笑话网站的技术实现。通过threadpool线程池处理多页并发请求,优化系统性能;利用lxml与正则表达式结合的方式清洗HTML结构中的混乱文本。文章提供了完整的代码示例,包括多线程任务调度、节点提取及文本过滤逻辑,帮助开发者掌握高效的数据抓取技巧。
本文详解如何利用Python正则表达式编写一个抓取内涵段子的爬虫程序。内容涵盖使用urllib2获取网页源码、通过正则表达式匹配特定HTML标签提取段子内容、处理中文编码乱码问题,以及将结果保存至本地文件。通过分步代码示例,展示从数据获取、筛选到持久化存储的完整流程。
本文详细解析如何使用Python的requests库进行网页请求,结合BeautifulSoup解析HTML结构,从图灵网抓取图书列表并提取详情页链接。文章通过具体代码示例,演示了如何从列表页解析链接,并从详情页提取书名、定价及电子书价格等关键信息,提供了完整的爬虫实现思路与代码片段。
本文详细介绍如何使用Python结合BeautifulSoup4库爬取名言网top10标签下的名言数据,并将包含名言、作者及标签的信息存储至MySQL数据库。代码涵盖网页解析、分页处理及数据库插入操作,适合Python初学者参考学习。
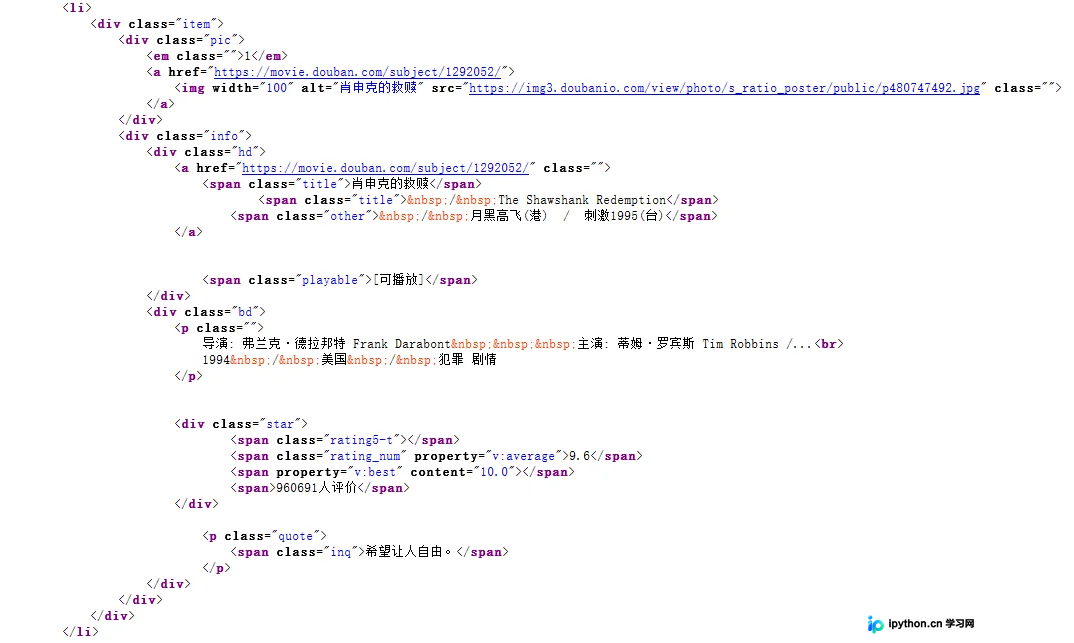
本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
本文提供Python实现的智联招聘爬虫代码实例。通过输入职位关键字,程序自动抓取职位名称、薪资及工作经验等数据,并利用openpyxl库将结果写入Excel文件。代码包含完整的请求头设置、分页逻辑及数据解析过程,适合用于快速获取招聘平台公开信息。
本文提供基于Python的电影下载链接爬虫实现方案。利用urllib2发起请求,结合BeautifulSoup解析HTML结构,提取电影标题及下载URL。代码包含分页处理、文件写入及编码转换逻辑,适用于学习Python网络爬虫基础与网页数据提取技术。
本文详解如何使用Python的Requests模块发起Ajax GET请求以爬取豆瓣电影分类排行榜数据。通过抓包工具定位异步加载的接口,解析返回的JSON字符串,并调整start和limit参数获取不同范围的电影详情,实现高效的数据抓取。