

Python实现无账号无限制抓取企查查企业数据:Selenium与Web接口实战

本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
前言:背景与目标
前言
本文文字及图片来源于网络,仅供学习与技术交流使用,不涉及任何商业用途。版权归原所有者所有,如有任何问题请及时联系我们进行处理。
技术选型与方案对比
在通过网络爬虫获取全国企业名单后,下一步工作通常是为这些企业补充详细信息。面对企查查、启信宝等专业信息平台,我们最终选定企查查作为数据源。在尝试多种技术方案的过程中,我们经历了以下探索:
第一种方案是采用Selenium进行爬虫开发,尝试绕过企查查的登录验证机制。然而,由于该平台对账号使用频率和IP地址有严格的限制措施,该方案最终被放弃。
第二种方案是通过Requests库直接发起HTTP请求并携带Cookies。但在实际操作中,我们遇到了Cookie有效期短以及访问频率受限的问题,导致该方法难以稳定运行。
经过反复尝试与参数调整,我们发现了一种更为有效的技术路径:结合Selenium浏览器自动化与Web接口调用。
该方案仅需配置IP代理,无需注册或登录任何账号,因此不受账号维度的限制。需要注意的是,由于未登录状态下的权限较低,所能获取的信息仅限于页面公开展示的内容,但足以覆盖大部分基础企业数据。
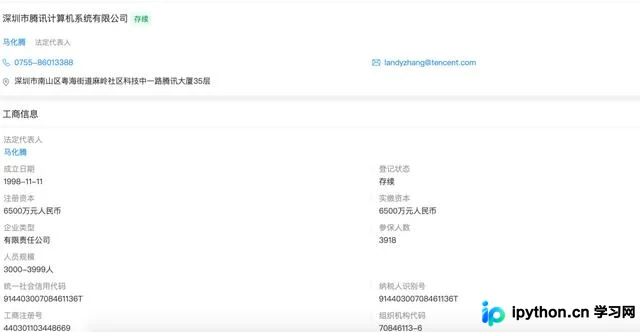
核心实现步骤
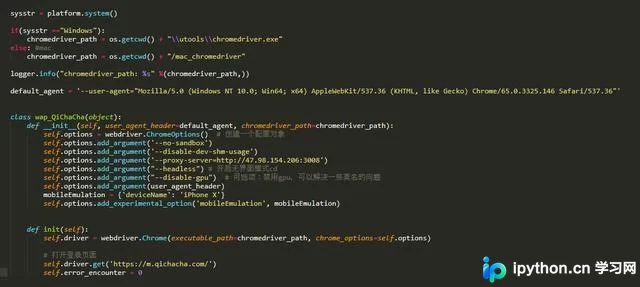
一、初始化Selenium环境
Python数据分析实战
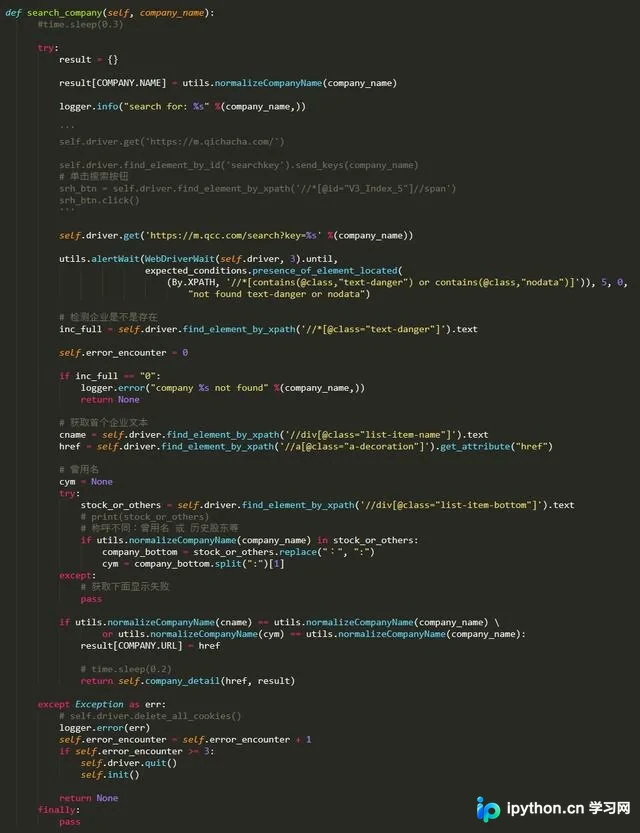
二、判断公司是否存在
Python数据分析实战
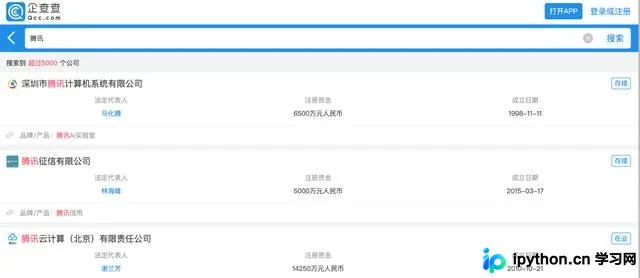
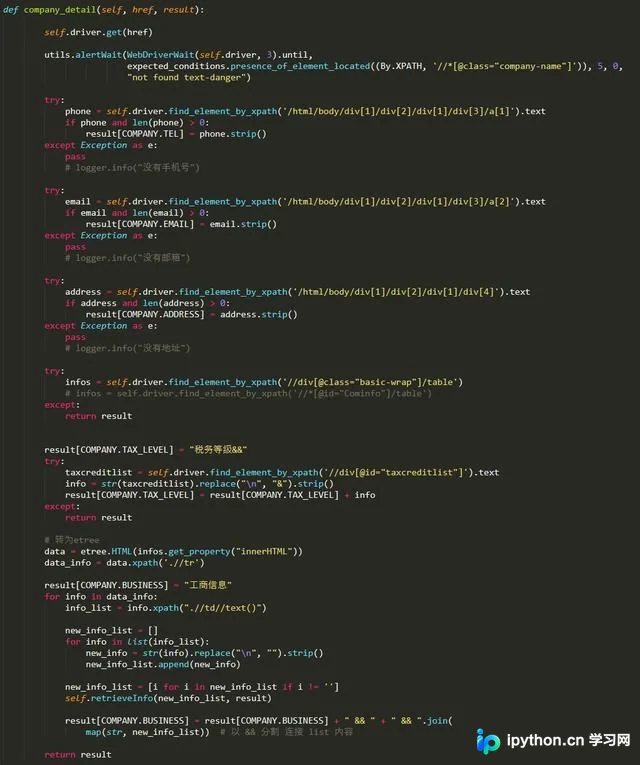
三、获取公司信息详情
Python数据分析实战
总结
总结
至此,关于使用Python在无账号、无限制条件下获取企查查企业信息的教程介绍完毕。如需了解更多Python与企查查数据相关的内容,欢迎查阅本站往期文章或继续浏览后续系列教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









