

Python爬虫urllib库进阶:POST请求与代理IP实战

本文深入解析Python urllib库的高级用法,重点讲解如何利用Request方法构建Headers模拟浏览器进行POST数据提交,并详细剖析通过ProxyHandler定制Opener以配置代理IP解决反爬限制的技巧。内容涵盖参数解析、编码规则及异常处理,助力提升爬虫效率与稳定性。
urllib基础用法概述
urllib库的核心组成结构
通过最基础的urlopen方法获取网页HTML源码
利用Request方法构建Headers以模拟浏览器行为
处理error异常情况的策略
除基础功能外,urllib库还具备诸多高级特性,可更灵活地应用于复杂爬虫场景,例如:
采用HTTP POST请求方法向服务器提交数据以完成用户登录
配置代理IP以规避反爬策略
设定超时时间以提升爬虫运行效率
URL解析相关方法
本文将对上述内容进行深入分析与详细讲解。
POST请求详解
POST是HTTP协议中的一种常用请求方法,主要用于向服务器提交数据。本文将先介绍执行POST请求前的准备工作,随后通过具体示例,对其使用方式及深层原理进行细致剖析。
POST请求的前期准备
既然需要向服务器提交信息,就必须明确数据提交的目标地址、具体内容以及所需的格式。带着这些问题,我们继续往下看。
以提交用户登录信息(用户名和密码)为例,不同网站所需的数据字段可能有所差异。例如淘宝的反爬机制较为复杂,可能包含大量额外信息。此处我们以豆瓣网站为例(相对简单),旨在阐明POST的使用逻辑,更复杂的内容将在后续实战部分与大家分享。
排除如淘宝般复杂的额外信息,若仅考虑用户名和密码,准备工作即需明确这两个字段对应的HTML标签中name属性的值。以下两种方法可实现这一目标。
通过浏览器F12开发者工具查看元素获取
也可借助抓包工具Fiddler获取相关信息。
不再赘述,直接展示如何找到name属性值。
1. 使用浏览器F12工具
通过浏览器F12逐层查看元素(以Chrome为例),邮箱/手机号标签的name属性值为"form_email",密码标签的name属性值同样为"form_email",如下图所示红框所示。
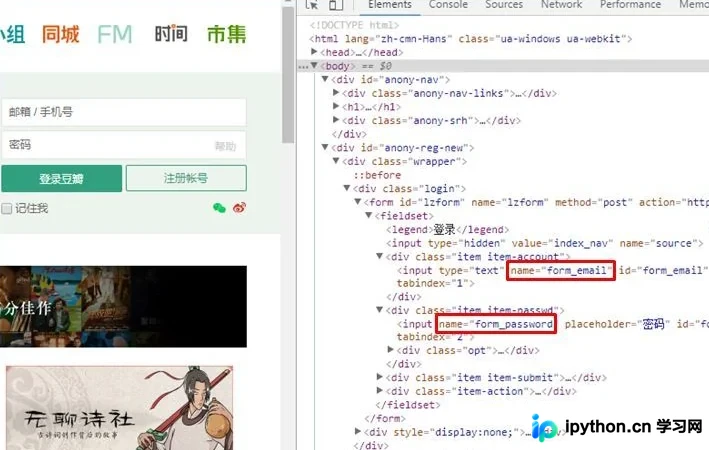
需注意的是,两个标签的name名称并非固定不变,上述查看到的名称仅为豆瓣网站所定义,并不代表所有网站。其他网站可能使用不同的名称,例如name="username"或name="password"等。因此,针对不同网站的登录操作,需每次查看具体的name属性值。
2. 使用Fiddler抓包工具
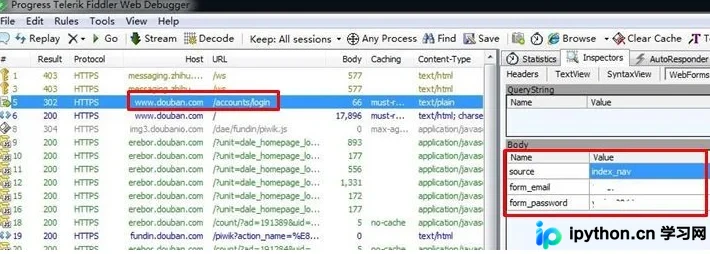
博主推荐使用Fiddler工具,其功能非常强大。爬虫本质上是模拟浏览器的工作流程,我们只需了解浏览器是如何工作的即可。
Fiddler能够捕获浏览器发送的所有POST请求内容,从而获取浏览器POST的数据,将其填入爬虫程序中模拟浏览器操作即可。此外,也可通过Fiddler捕获浏览器请求的Headers,十分便捷。
安装Fiddler的用户请注意:Fiddler证书问题可能导致无法抓取HTTPS包,可通过Tools -> Options -> HTTPS勾选Decrypt HTTPS traffic来修改证书解决。否则将一直显示抓取Tunnel信息包。
完成准备工作后,直接通过一段代码来理解具体实现。
POST请求的实际应用
# coding: utf-8
import urllib.request
import urllib.error
import urllib.parse

# headers 信息,从fiddler上或你的浏览器上可复制下来
headers = {'Accept': 'text/html,application/xhtml+xml,
    application/xml;q=0.9,image/webp,image/apng,
    */*;q=0.8',
    'Accept-Language': 'zh-CN,zh;q=0.9',
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.3;
           Win64; x64) AppleWebKit/537.36
           (KHTML, like Gecko)Chrome/48.0
           .2564.48 Safari/537.36'
    }
# POST请求的信息,填写你的用户名和密码
value = {'source': 'index_nav',
   'form_password': 'your password',
   'form_email': 'your username'
   }
try:
data = urllib.parse.urlencode(value).encode('utf8')
response = urllib.request.Request(
'https://www.douban.com/', data=data, headers=headers)
html = urllib.request.urlopen(response)
result = html.read().decode('utf8')
print(result)
except urllib.error.URLError as e:
if hasattr(e, 'reason'):
  print('错误原因是' + str(e.reason))
except urllib.error.HTTPError as e:
if hasattr(e, 'code'):
  print('错误编码是' + str(e.code))
else:
print('请求成功通过。')
运行结果如下:
<!DOCTYPE HTML>
<html lang="zh-cmn-Hans" class="ua-windows ua-webkit">
<head>
<meta charset="UTF-8">
<meta name="description" content="提供图书、电影、音乐唱片的
推荐、评论和价格比较,以及城市独特的文化生活。">
.....
window.attachEvent('onload', _ga_init);
}
</script>
</body>
</html>
注意:复制Headers时请去除'Accept-Encoding': 'gzip, deflate'这一项,否则可能会提示decode错误。
POST请求代码逻辑分析
我们来分析上述代码,其与urllib库中Request的基本用法基本一致,urllib库Request的基础用法可参考前文《Python从零学爬虫》。此处增加了post的data参数及部分解析内容,重点进行讲解。
data = urllib.parse.urlencode(value).encode('utf8')
该语句利用urllib库的parse模块对POST内容进行解析,为什么要进行解析?
这是因为POST内容需经过特定的编码格式处理后方可发送,而编码规则需遵循RFC标准。查阅RFC定义,供参考:
Request For Comments(RFC),即请求评论,是一系列以编号排定的文件。这些文件收集了有关互联网的相关信息,以及UNIX和互联网社区的软件文档。目前RFC文件由Internet Society(ISOC)赞助发行。基本的互联网通信协议均在RFC文件内详细说明。RFC文件还额外收录了许多标准内的论题,例如关于互联网新开发的协议及发展中的所有记录。因此,几乎所有的互联网标准均收录于RFC文件之中。
而parse模块中的urlencode方法是将字典或有序的二元素元组转换为URL的查询字符串(即按照RFC标准转换格式)。随后,将转换好的字符串按UTF-8编码转换为二进制格式方可使用。
注:以上操作在Python 3.x环境下完成,Python 3.x中的编码解码规则为byte -> string -> byte的模式,其中byte -> string为解码,string -> byte为编码。
代理IP应用
代理IP的使用场景
为何要使用代理IP?因为各种反爬机制会检测同一IP爬取网页的频率和速度。若速度过快,会被判定为机器人并封禁IP;若速度过慢,则影响爬取效率。因此,我们将使用代理IP替代自身IP,通过不断更换新的IP地址,达到快速爬取网页且降低被检测为机器人的目的。
同样利用urllib的Request即可完成代理IP的使用,但与之前使用的urlopen不同,我们需要自行创建定制化的Opener。这是什么意思呢?
urlopen可视为Opener的通用版本,当我们需要特殊功能(例如代理IP)时,urlopen无法满足需求,此时不得不自行定义并创建特殊的Opener。
Request中正好包含处理各种功能的处理器方法,如下所示:
ProxyHandler, UnknownHandler, HTTPHandler,
HTTPDefaultErrorHandler, HTTPRedirectHandler,
FTPHandler, FileHandler, HTTPErrorProcessor, DataHandler
我们需要使用的是第一个ProxyHandler来处理代理问题。
让我们看一段代码如何使用。
# coding:utf-8
import urllib.request
import urllib.error
import urllib.parse
# headers信息,从fiddler上或浏览器上可复制下来
headers = {'Accept': 'text/html,application/xhtml+xml,
    application/xml;q=0.9,image/webp,image/apng,
    */*;q=0.8',
    'Accept-Language': 'zh-CN,zh;q=0.9',
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.3;
           Win64;
           x64) AppleWebKit/537.36 (KHTML,
           like Gecko)Chrome/48.0.2564.48
           Safari/537.36'
    }
# POST请求的信息
value = {'source': 'index_nav',
   'form_password': 'your password',
   'form_email': 'your username'
   }
# 代理IP信息为字典格式,key为'http',value为'代理ip:端口号'
proxy = {'http': '115.193.101.21:61234'}
try:
data = urllib.parse.urlencode(value).encode('utf8')
response = urllib.request.Request(
'https://www.douban.com/', data=data, headers=headers)
# 使用ProxyHandler方法生成处理器对象
proxy_handler = urllib.request.ProxyHandler(proxy)
# 创建代理IP的opener实例
opener = urllib.request.build_opener(proxy_handler)
# 将设置好的post信息和headers的response作为参数
html = opener.open(response)
result = html.read().decode('utf8')
print(result)
except urllib.error.URLError as e:
if hasattr(e, 'reason'):
  print('错误原因是' + str(e.reason))
except urllib.error.HTTPError as e:
if hasattr(e, 'code'):
  print('错误编码是' + str(e.code))
else:
print('请求成功通过。')
在上述POST请求代码的基础上,使用自己创建的Opener替换urlopen即可完成代理IP的操作。代理IP可从一些免费代理IP网站查找。
以上就是我们整理的全部内容,感谢你对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









