

Python列表去重并保留原始顺序的方法

本文介绍如何在Python中对列表进行去重操作,同时保持元素原有的出现顺序。通过结合set集合去重与list.sort方法利用index排序,可解决set默认按值排序的问题。此外,文章还补充了Python爬虫中利用集合实现链接去重的完整代码示例,帮助开发者高效处理数据。
Python列表去重并保留原始顺序的方法
在Python开发中,经常需要对列表元素进行去重处理。然而,直接使用集合(set)去重会打乱元素的原始顺序。本文将探讨一种方法,在去除重复元素的同时,保持列表元素原有的排列顺序不变。
原始列表定义
假设我们有一个包含重复数字的原始列表,定义如下:
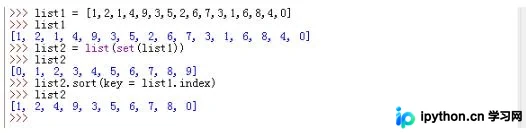
list1 = [1,2,1,4,9,3,5,2,6,7,3,1,6,8,4,0]
使用集合进行去重
首先,利用Python内置的集合(set)特性进行去重操作。将列表转换为集合可以自动去除重复项,然后再转回列表形式:
list2 = list(set(list1))
set去重的默认排序问题
需要注意的是,通过set去重后生成的list2,其元素默认会按照数值大小进行升序排列,结果如下:
list2 = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
恢复原始顺序的排序技巧
为了恢复list2中元素在原始list1中出现的先后顺序,我们可以利用列表的sort方法,指定key参数为list1.index。这样排序时会根据元素在原始列表中的索引位置进行重排:
list2.sort(key = list1.index)
经过上述排序操作后,list2最终变为:[1, 2, 4, 9, 3, 5, 6, 7, 8, 0],成功保留了原始顺序。
具体的实现过程如下:
Python爬虫链接去重示例
补充拓展:python爬取链接去重
我就废话不多说了,直接上代码吧!
from urllib.request import urlopen
from bs4 import BeautifulSoup
import re

pages = set()
def getLinks(pageUrl):
	global pages
	html = urlopen("http://en.wikipedia.org"+pageUrl)
	bsObj = BeautifulSoup(html)
	for link in bsObj.findAll("a",href = re.compile("^(/wiki/)")):
		if 'href' in link.attrs:
			if link.attrs['href'] not in pages:
				#遇到新的页面
			  newPage = link.attrs['href']
			  print(newPage)
			  pages.add(newPage)
			  getLinks(newPage)
getLinks("")
以上这篇浅谈python元素如何去重,去重后如何保持原来元素的顺序不变就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









