

Python批量抽取文本文件评分数据并生成训练样本
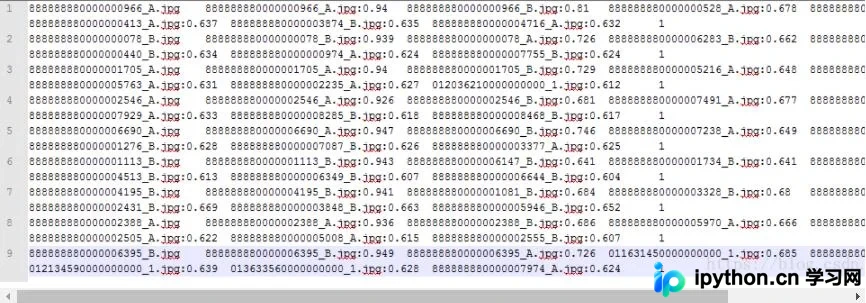
本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
2026-10-13
6

本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
本文介绍使用Python将用户输入的文本去除所有空格后保存为txt文件的方法。通过字符串的replace函数实现去空格,并利用文件操作将结果写入Output.txt文件中,供参考学习。
本文介绍如何利用Python的os模块批量读取指定目录下的所有txt文件,并结合set数据结构实现内容去重。通过遍历文件夹获取文件列表,逐行读取内容存入集合以自动过滤重复项,最后将去重后的结果写入新文件。该方法适用于需要高效处理大量文本数据的场景,避免了手动逐一操作的低效问题。
本文介绍在Windows环境下使用Python 2.7编写的脚本,用于递归检索指定目录下的文本文件。脚本通过命令行参数接收搜索路径和目标字符串,遍历所有文件并统计包含该字符串的行及位置,最终输出匹配结果。
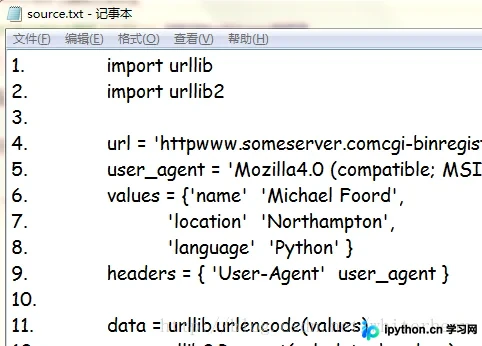
本文介绍使用Python脚本自动清理从网络复制代码时产生的行号标签问题。通过逐行读取文件,利用正则表达式匹配数字加点及制表符的模式,并结合字符串替换方法移除多余字符,最终将清洗后的内容写回原文件,实现高效批量处理。
本文介绍了一种使用 PHP 正则表达式检测字符串中是否包含非本站域名的外部链接。通过 preg_match_all 提取所有 URL,并与当前主机域名进行比对,从而快速判断内容安全性与链接指向。该方法代码简洁,适用于评论过滤、文本清洗等场景。
本文介绍在 Python 中向 txt 文件指定位置插入或追加文本的方法。通过读取所有行到列表,利用 insert 方法在指定索引处添加新内容,再重新写入文件。代码展示了完整的读写流程,适用于需要在特定行插入数据的场景。
本文详解Python中利用fileinput模块实现文件特定行插入与替换的方法。通过设置inplace=1重定向输出,可模拟类似sed的功能,在指定行号插入内容或匹配模式进行替换,适用于小型文本处理场景。
本文介绍使用Python统计文本文件字数及词频的方法。通过读取file.txt,预处理标点符号并转换为小写,利用字典统计单词出现次数。代码包含按频率排序及输出Top N单词的功能,适合Python初学者参考文件处理与基础算法实现。
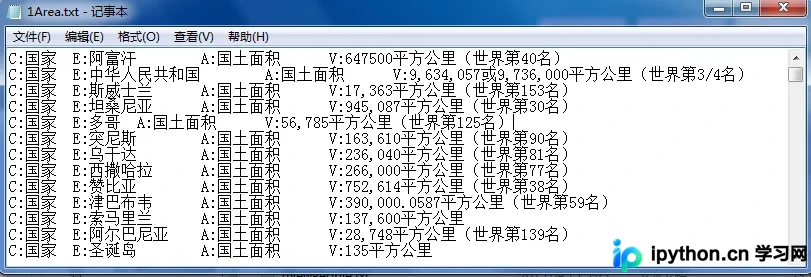
本文介绍Python中列表的基础操作,重点讲解二维列表的排序方法。通过对比list.sort()与sorted()的区别,演示如何利用lambda表达式按指定关键字排序。同时,结合从TXT文件读取国土面积数据的实例,详细阐述字符串清洗、正则匹配及数值转换技巧,帮助读者掌握实际数据处理流程。
本文介绍了Python中处理文本文件控制字符的多种方法。控制字符包括ASCII定义的0-31及127,以及ISO/IEC 8859-1定义的128-159。文章提供了三种Python解决方案,涵盖使用lambda表达式、正则表达式匹配非法Unicode字符及ASCII控制符,以及构建自定义正则模式进行替换。这些方法有助于在数据清洗和文件处理中有效移除非打印字符,确保文本数据的纯净性。
本文详解Python文本处理与排序的多种实现方式。涵盖字符串大小写互换的四种内置方法及自定义逻辑;利用列表insert与del实现文件行交换;通过pandas或列表推导式完成矩阵转置。此外,深入解析快速排序的三种Python实现(递归、双指针、算法导论版)及内置sorted()特性,并提供format与just对齐、正则与string模块分行输出的实战代码。