

Python脚本自动去除代码文件中的行号标签

发布时间:2026-10-13| 5人浏览过
本文介绍使用Python脚本自动清理从网络复制代码时产生的行号标签问题。通过逐行读取文件,利用正则表达式匹配数字加点及制表符的模式,并结合字符串替换方法移除多余字符,最终将清洗后的内容写回原文件,实现高效批量处理。
问题描述:
在从互联网下载或复制他人代码时,经常会遇到代码文件中包含行号标签的情况。具体表现如截图所示:
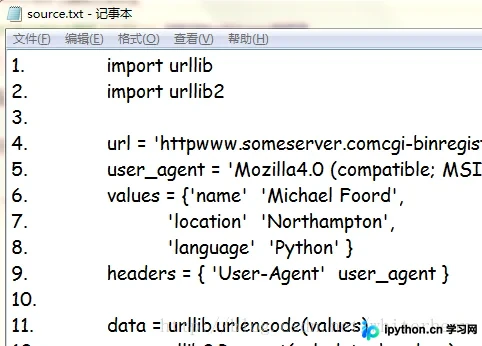
这些代码中夹杂了如“1.”、“2.”等行号标识,若需直接运行或复制代码片段,必须手动逐一删除这些标签。既然已经掌握了Python编程技能,我们可以编写一段脚本来自动化处理这一任务。
思路分析:
首先,程序需要逐行读取目标文本文件。
利用正则表达式,可以精准匹配出所有的行号标签及其后跟随的“\t”(制表符),所使用的正则表达式模式为:“\d+.\t”。
随后,将匹配到的结果在该行中进行删除操作。这里使用string模块的replace方法,将匹配到的字符串替换为空字符串“''”。
最后,将每次删除行号标签后处理好的行保存起来,并将这些处理后的行写入原文本文件。需要注意的是,以“w”(写入)模式打开文本文件会清空原文本内容,因此需确保写入的是清洗后的完整数据。
代码:
# -*- coding:utf-8 -*-
import re
import os
import sys
reload(sys)
sys.setdefaultencoding('utf-8')

ls = os.linesep
label_regex = r'\d+.\t'
content = []
for line in open('source.txt', 'r'):
  mm = re.search(label_regex, line)
  if mm:
    mm = mm.group()
    content.append(line.replace(mm, '').rstrip())
  else:
    break
f = open('source.txt', 'w')
f.writelines(['%s%s' % (x,ls) for x in content])
结果:
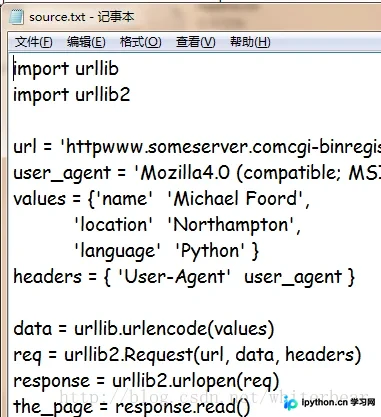
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









