Python正则表达式实战指南:从基础匹配到高级技巧
本文详细介绍Python中re模块的使用,涵盖compile创建正则对象、search与findall匹配方法、括号分组、管道符多选、可选及重复量词(*、+、{n})的应用,以及贪心与非贪心匹配、自定义字符集、边界锚点和通配符等核心技巧,助力自动化文本处理。
2026-10-16
13

本文详细介绍Python中re模块的使用,涵盖compile创建正则对象、search与findall匹配方法、括号分组、管道符多选、可选及重复量词(*、+、{n})的应用,以及贪心与非贪心匹配、自定义字符集、边界锚点和通配符等核心技巧,助力自动化文本处理。
本文深入解析Python中re模块的核心用法,涵盖findall、match、search、finditer等匹配类方法,以及sub和split等修改类方法。详细讲解编译优化、大小写忽略、非贪婪匹配及括号分组机制,通过具体代码示例展示如何处理版本字符串、文本分割及复杂模式匹配,帮助开发者高效利用正则表达式进行文本处理。
本文介绍如何利用Python的unicodedata模块,通过一行代码高效清洗文本中的各类特殊符号。文章解析了Unicode符号的四大分类,提供了针对所有符号及特定类别(如箭头、几何图形)的过滤代码示例,并指导用户通过官方文档查询符号类别,实现精准的数据预处理。
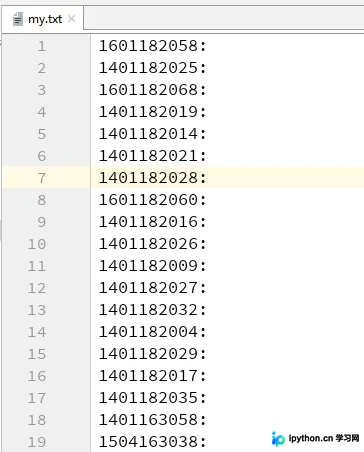
本文介绍如何使用Python 3.6环境,通过读取两个TXT文件的行数据,提取每行第一个元素并按行合并生成新文件。提供完整Python代码示例及操作前后文件对比,帮助开发者快速掌握文本处理技巧。
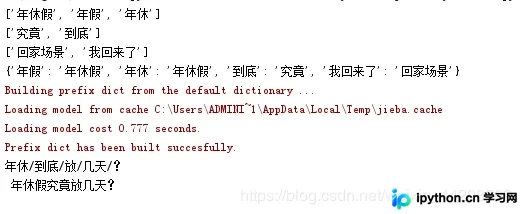
本文介绍如何利用Python的jieba库结合自定义同义词词典实现文本中的词汇替换。通过读取指定格式的TXT文件构建映射字典,调整特定词汇的词频以确保正确分词,随后对输入字符串进行切分并执行替换逻辑。该方法适用于需要标准化术语或进行文本预处理的自然语言处理场景。
本文详细解析了使用Python统计英文文章词频的实现方法。通过构建单词列表、统计词频并计算频率,最终利用sorted函数对结果进行排序输出。文中提供了完整的代码逻辑说明及关键函数实现,并推荐了在线字数统计工具,帮助开发者快速掌握文本数据处理技巧。
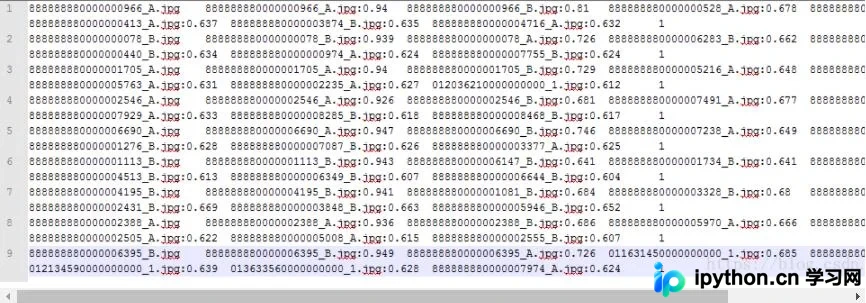
本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
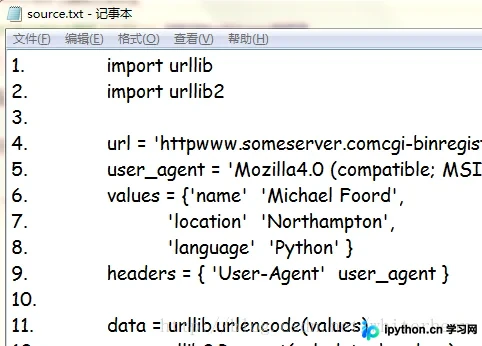
本文介绍使用Python脚本自动清理从网络复制代码时产生的行号标签问题。通过逐行读取文件,利用正则表达式匹配数字加点及制表符的模式,并结合字符串替换方法移除多余字符,最终将清洗后的内容写回原文件,实现高效批量处理。
本文介绍了在使用Java程序读写包含中文的txt文件时,如何避免常见的中文乱码问题。文章详细说明了系统编码与程序编码不一致导致乱码的原因,并提供了在写入和读取文件时显式指定编码格式的解决方案。通过示例代码展示了如何在Windows环境下使用gbk或utf-8编码来正确处理文件读写操作。
本文介绍了一种使用 PHP 正则表达式检测字符串中是否包含非本站域名的外部链接。通过 preg_match_all 提取所有 URL,并与当前主机域名进行比对,从而快速判断内容安全性与链接指向。该方法代码简洁,适用于评论过滤、文本清洗等场景。
在内容聚合或去重场景中,常需计算两个标题的相似度。本文提供一套基于PHP原生 `similar_text` 函数的解决方案,包含核心的相似度计算逻辑及辅助函数,用于清洗HTML实体、去除分割符并提取最长有效词干,从而获得更精准的百分比结果。
本文介绍使用Python实现词频统计软件的方法。涵盖文件读取、大小写转换、特殊字符去除、单词统计、排序及结果写入文本等步骤。通过正则表达式清洗数据,利用字典统计词频,并按出现次数降序排列,最终输出高频单词及总数,适合初学者参考。