

Python实战:二维列表排序与TXT文本处理详解

本文介绍Python中列表的基础操作,重点讲解二维列表的排序方法。通过对比list.sort()与sorted()的区别,演示如何利用lambda表达式按指定关键字排序。同时,结合从TXT文件读取国土面积数据的实例,详细阐述字符串清洗、正则匹配及数值转换技巧,帮助读者掌握实际数据处理流程。
对于测试人员或企业实习生而言,使用Python处理TXT文本内容是一种高效的选择。Python不仅在网络资料爬取方面表现优异,在自然语言处理(NLP)领域也具备显著优势。本文旨在简要介绍如何利用Python处理TXT汉字文本、实现二维列表排序以及获取列表下标,希望能为读者提供实用的参考或思路。
一. list二维数组排序
功能说明:假设已通过Python从维基百科获取了各国的国土面积及排名信息,现在需要提取国土面积数据并对这些数据进行排序,以验证世界排名的准确性。
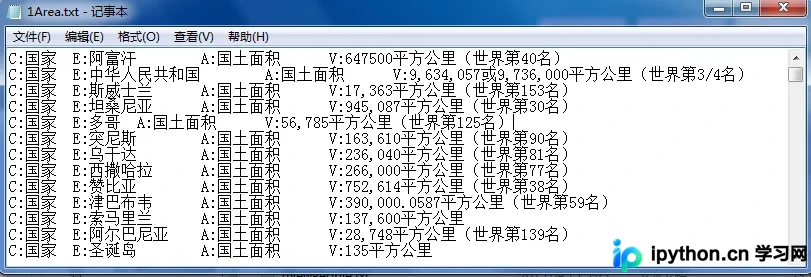
列表基础知识
列表(List)与字符串一样,属于序列型数据类型,支持通过下标或切片操作来访问单个或连续的元素。两者的主要区别在于:字符串仅由字符组成且不可变(无法单独修改其某个值),而列表是一个灵活的容器,可以容纳任意数量的Python对象。
综上所述,列表可以包含不同类型的对象(包括用户自定义对象)作为元素。列表支持添加或删除元素,也可以进行合并或拆分操作,常用的方法包括insert、update、remove、sort、reverse等。
列表排序介绍
常用的列表排序方法主要有两种:使用列表内置函数list.sort()或使用序列类型函数sorted(list)。
#list.sort(func=None, key=None, reverse=False)
list = [4, 3, 9, 1, 5, 2]
print list
list.sort()
print list
#输出
[4, 3, 9, 1, 5, 2]
[1, 2, 3, 4, 5, 9]
通过对比以下代码可以发现两者的核心区别:list.sort()会直接修改原列表的顺序,而sorted()函数则返回一个新的排序后的列表,不改变原列表。
#sorted(list)
list = ['h', 'a', 'p', 'd', 'i', 'b']
print list
print sorted(list)
print list
#输出
['h', 'a', 'p', 'd', 'i', 'b']
['a', 'b', 'd', 'h', 'i', 'p']
['h', 'a', 'p', 'd', 'i', 'b']
二维列表排序
利用lambda表达式可以实现二维列表的排序,并指定按照第二个关键字进行排序。具体实现可参考相关示例文章。
#list.sort(func=None, key=None, reverse=False)
list = [('Tom',4),('Jack',7),('Daly',9),('Mary',1),('God',5),('Yuri',3)]
print list
list.sort(lambda x,y:cmp(x[1],y[1]))
print list
#输出
[('Tom', 4), ('Jack', 7), ('Daly', 9), ('Mary', 1), ('God', 5), ('Yuri', 3)]
[('Mary', 1), ('Yuri', 3), ('Tom', 4), ('God', 5), ('Jack', 7), ('Daly', 9)]
在题目场景中,若第一个数值存储的是文件中读取的行号,第二个数值存储的是人口数量,此时可对第二个数值进行排序。需要注意的是,每组数据如(1,93)构成一个元组(tuple)。
#list.sort(func=None, key=None, reverse=False)
list = [(1,93),(2,71),(3,89),(4,93),(5,85),(6,77)]
print list
list.sort(key=lambda x:x[1])
print list
#输出
[(1, 93), (2, 71), (3, 89), (4, 93), (5, 85), (6, 77)]
[(2, 71), (6, 77), (5, 85), (3, 89), (1, 93), (4, 93)]
lambda表达式
在上述代码中,如果读者对lambda表达式尚不熟悉,下面将进行简要回顾。
Python允许使用lambda关键字创建匿名函数,无需像def语句那样进行标准声明。然而,作为函数,它们同样可以接受参数。
lambda是一个表达式而非代码块,其定义必须与声明置于同一行。它能够在lambda中封装有限的逻辑,起到函数速写的作用。例如:
#lambda [arg1[, arg2, ..., argN]]:expression
f = lambda x,y,z:x+y+z
num = f(1,2,3)
print 'lambda: ' + str(num)
#等价于
def add(x,y,z):
 return x+y+z
num = add(1,2,3)
print 'function: ' + str(num)
#输出
lambda: 6
function: 6
二. 处理txt文本
接下来展示如何通过读取TXT文件按行获取面积数据并进行排序。核心代码如下:
读取文件与列表添加
source = open("F:\\Student\\1Area.txt",'r')
lines = source.readlines()
L = [] #列表二维 国家行数 人口数
count = 1 #当前国家在文件中第count行
for line in lines:
 line = line.rstrip('\n') #去除换行
 .... #获取排名和面积
 fNum = string.atof(number) #面积
 L.append((count,ffNum)) #列表添加
 count = count + 1
else:
 print 'End While'
 source.close()
列表排序
L.sort(lambda x,y:cmp(x[1],y[1]),reverse = True)
#遍历过程 表示第i名 (文件第x行,面积y平方公里)
#重点 L[i]输出列表 1 (46, 17075200.0) L[i][0]表示元组tuple第一个数 1 46
for i in range(len(L)):
 print (i+1), L[i]
获取面积字符串
line = line.rstrip('\n') #去除换行
start = line.find(r'V:')
end = line.find(r'平方公里')
number = line[start+2:end]
number = number.replace(',','') #去除','
#输出
line => C:国家 E:中华人民共和国 A:国土面积 V:9,634,057或9,736,000平方公里(世界第3/4名)
number => 9634057或9736000
最后,需要处理各种复杂的字符串情况,例如处理‘或’字、将‘万’转换为乘以10000,以及删除‘[1]’等标记。更简便的方法是使用正则表达式或提取第一个非数字字符。
运行结果如下所示,包括排序后的TXT文件和纠错后的TXT文件:
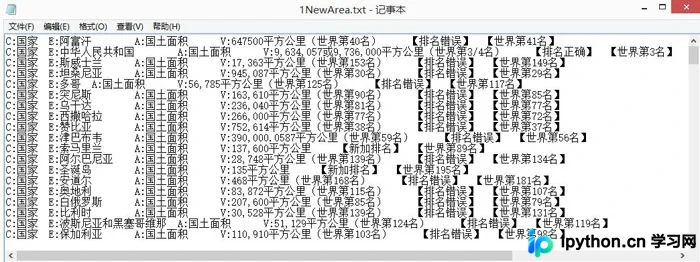
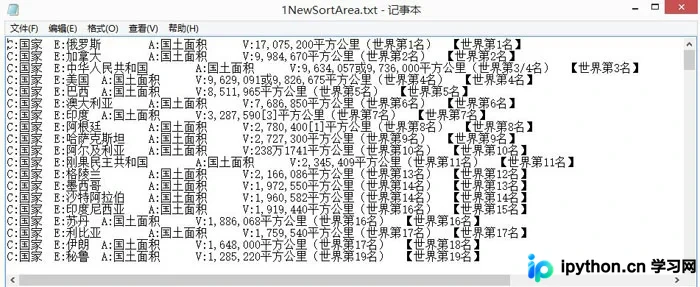
完整代码如下:
# coding=utf-8
import time
import re
import os
import string
import sys

source = open("F:\\Student\\1Area.txt",'r')
lines = source.readlines()
count = 1
L = [] #列表二维 国家行数 人口数

'''''
第一部分 获取国土面积
'''
print 'Start!!!'
for line in lines:
 line = line.rstrip('\n') #去除换行
 start = line.find(r'V:')
 end = line.find(r'平方公里')
 number = line[start+2:end]
 number = number.replace(',','') #去除','
 fNum = 0.0
 if '万' in number:
 end = line.find(r'万')
 newNum = line[start+2:end]
 fNum = string.atof(newNum)*10000
 else: #如何优化代码 全局变量
 if '/' in number:
 end = line.find(r'/')
 newNum = line[start+2:end]
 newNum = newNum.replace(',','')
 fNum = string.atof(newNum)
 elif '(' in number:
 end = line.find(r'(')
 newNum = line[start+2:end]
 newNum = newNum.replace(',','')
 fNum = string.atof(newNum)
 elif '[' in number:
 end = line.find(r'[')
 newNum = line[start+2:end]
 newNum = newNum.replace(',','')
 fNum = string.atof(newNum)
 elif '或' in number:
 end = line.find(r'或')
 newNum = line[start+2:end]
 newNum = newNum.replace(',','')
 fNum = string.atof(newNum)
 elif ' ' in number:
 end = line.find(r' ')
 newNum = line[start+2:end]
 newNum = newNum.replace(',','')
 fNum = string.atof(newNum)
 else:
 fNum = string.atof(number)
 #print line
 #print number
 #print fNum
 L.append((count,fNum))
 count = count + 1
else:
 print 'End While'
 source.close()

'''''
第二部分 从大到小排序
参看 http://blog.chinaunix.net/uid-20775448-id-4222915.html
'''
L.sort(lambda x,y:cmp(x[1],y[1]),reverse = True)
#print L
#遍历过程 表示第i名 (文件第x行,面积y平方公里)
#重点 L[i]输出列表 1 (46, 17075200.0) L[i][0]表示元组tuple第一个数 1 46
for i in range(len(L)):
 print (i+1), L[i]

'''''
第三部分 读写文件
'''
source = open("F:\\Student\\1Area.txt",'r')
lines = source.readlines()
result = open("F:\\Student\\1NewArea.txt",'w')
count = 1
for line in lines:
 line = line.rstrip('\n')
 #获取列表L中排名位置pm
 pm = 0
 for i in range(len(L)):
 if count==L[i][0]:
 pm = i+1
 break
 #获取文件中名次
 if '世界第' in line:
 start = line.find(r'世界第')
 end = line.find(r'名')
 number = line[start+9:end]
 if '/' in number: #防止中国第3/4名
 end = line.find(r'/')
 number = line[start+9:end]
 if '包括海外' in number:
 number = '41'
 print number,pm,type(number),type(pm)

 if string.atoi(number)==pm:
 line = line + ' 【排名正确】 【世界第' + str(pm) + '名】'
 result.write(line+'\n')
 else:
 line = line + ' 【排名错误】 【世界第' + str(pm) + '名】'
 result.write(line+'\n')
 else: #文件中没有排名
 line = line + ' 【新加排名】 【世界第' + str(pm) + '名】'
 result.write(line+'\n')
 count = count + 1
else:
 print 'End Sorted'
 source.close()
 result.close()

'''''
第四部分 输出一个排序好的文件 便于观察
'''
source = open("F:\\Student\\1Area.txt",'r')
lines = source.readlines()
result = open("F:\\Student\\1NewSortArea.txt",'w')
#i表示第i名 L[i][0]表示行数
pm = 0
for i in range(len(L)):
 pm = L[i][0]
 count = 1
 for line in lines:
 line = line.rstrip('\n')
 if count==pm:
 line = line + ' 【世界第' + str(i+1) + '名】'
 result.write(line+'\n')
 break
 else:
 count = count + 1
else:
 print 'End Sorted Second'
 source.close()
 result.close()
最后,希望本文对你有所帮助。文章通过一个实际操作案例,帮助你巩固学习列表的二维排序和字符串TXT处理技巧。如果文中存在错误或不足之处,敬请谅解。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









