

Python3使用PyPDF2解析PDF并结合正则表达式提取数据
本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
2026-10-13
6

本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
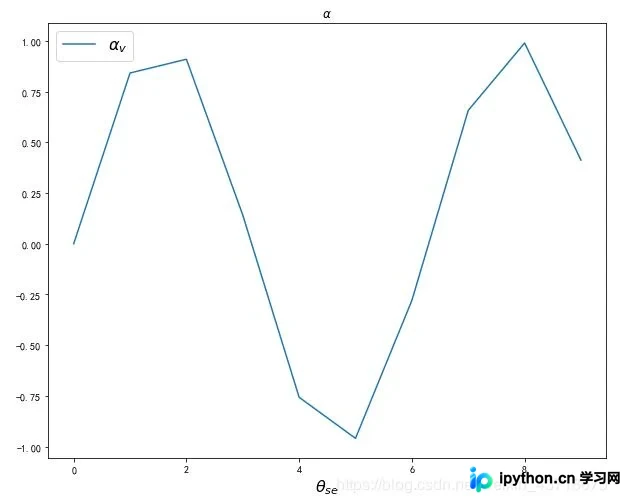
本文介绍在Python中利用Matplotlib库输出LaTeX格式的数学符号,以及使用正则表达式和eval函数解析并计算字符串中的简单数学表达式。通过具体代码示例,展示了如何在图表标题和标签中正确渲染希腊字母及下标,并实现了对包含加减乘除运算的文本字符串进行自动提取与计算。
本文详解Python中Unicode字符串与普通字符串的相互转换方法,包括encode与decode的具体用法。同时提供利用json模块解决Python列表输出时Unicode编码未正确显示为中文的问题,通过设置ensure_ascii=False实现格式化输出,并介绍如何反向解析恢复数据。
本文介绍在Python爬虫或数据处理中,当保存的中文数据呈现为Unicode编码格式时,如何利用eval函数将其还原为可读字符串。通过解析Python表达式,eval可将表示字符串的Unicode字面量转换为实际字符。文章同时补充了使用str或repr函数处理特殊字符的基础知识,并提供相关代码示例以供参考。
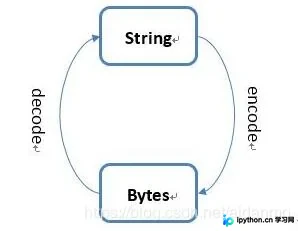
本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。
本文介绍如何在Python中将字典内的Unicode编码字符转换为中文显示。主要方法包括使用json.dumps配合decode('unicode-escape'),以及通过ord()函数获取字符编码并以16进制格式打印。同时涵盖从UTF-8或GBK文件读取字符串并转换为Unicode字符串的操作。
本文详细介绍 Python 3.6 引入的 f-string 字符串格式化功能。通过具体示例演示如何在 f-string 中指定字段宽度、实现左对齐与右对齐、控制小数点后位数以及使用零填充不足位数的方法,帮助开发者编写更直观、整洁的代码。
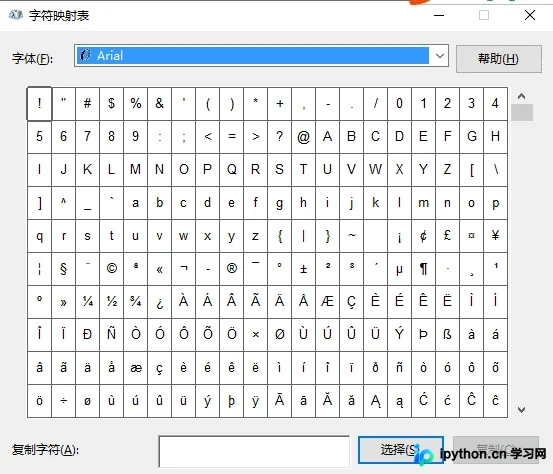
本文介绍了在Python中打印特殊符号的两种方法。一是通过Windows系统自带的字符映射表(charmap)查找并输入符号;二是利用Python内置的chr()函数,根据Unicode编码值直接打印出如Σ、箭头及❋等特定符号。
本文介绍如何使用Python编写程序检测电商宣传文案中的敏感词汇。通过定义敏感词库并遍历输入文本,程序能统计敏感词出现次数,并在输出时将敏感词以红色高亮显示,帮助商家规避平台违规风险。

本文系统讲解Python核心基础概念,涵盖整数、浮点、字符串、布尔及空值等数据类型。详细阐述变量命名规范、字符串占位符与format方法的使用技巧,并深入解析if...else条件判断逻辑。特别针对input函数返回字符串导致的类型比较错误提供解决方案,帮助初学者避开常见编程陷阱,掌握Python基础语法。

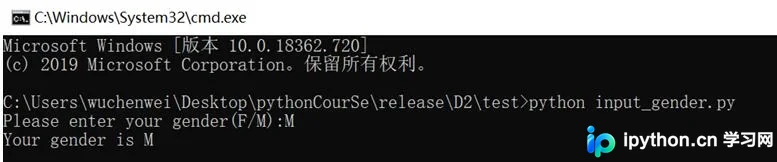
本文介绍Python中input()函数获取用户输入的方法。重点讲解在Sublime等编辑器中需通过CMD运行以支持在线输入,并强调input返回值默认为字符串。通过示例演示如何使用int()进行强制类型转换,实现数字处理及条件判断,帮助开发者正确掌握输入交互与数据类型处理。
本文提供一段 PHP 代码,实现在指定最小与最大长度范围内,将目标字符串随机切割并保存至数组。通过循环截取子串并更新剩余字符串,直至原串为空。适用于需要对文本进行不规则拆分处理的场景。