

Python3使用PyPDF2解析PDF并结合正则表达式提取数据

发布时间:2026-10-13| 3人浏览过
本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
Python解析PDF并提取数据的核心代码
以下直接展示核心实现代码。
PDF内容读取与正则匹配逻辑
 import PyPDF2
 import re

 pdf_file = open('xxx.pdf', mode='rb')
 read_pdf = PyPDF2.PdfFileReader(pdf_file)
 # 获取pdf文件的所有页数
 number_of_pages = read_pdf.getNumPages()
 # print('total_page: ', number_of_pages)
 line_list = []
 # 循环遍历每一页
 for i in range(0, number_of_pages):
  # 读取每一页的内容
  page = read_pdf.getPage(i)
  page_content = page.extractText()
  # 将这一页的内容分割为列表,,并相加所有的页面内容
  line_list += page_content.split()
 # 关闭pdf文件
 pdf_file.close()
 line_buf = ''
 for buf in line_list:
  line_buf = line_buf+' '+buf
 # 匹配数据:第一列和第二列 如:000069.sz 和 100
 # print(line_buf)
 a = re.findall('([0-9]+[0-9]+[0-9]+[0-9]+[0-9]+[0-9]+.[a-z]+[a-z])', line_buf)
 b = re.findall('[0-9]+[0-9]+[0-9]+[0-9]+[0-9]+[0-9]+.[a-z]+[a-z].([0-9,]+)', line_buf)
 # print(b)
 for i in range(0, len(a)):
  a[i] = a[i].upper()
 for i in range(0, len(b)):
  b[i] = int(b[i].replace(',', ''))
 # print(b)
 # 组成字典
 results = dict(zip(a, b))
关于正则表达式的其他应用示例:
数据写入CSV文件的正则处理
fp = open(filename,"w")
fp.write(re.search('(StockDescription:)([a-zA-Z]+-[a-zA-Z]+)',line_buf).group(2) +',')
fp.write(time.strftime('%Y%m%d',time.strptime(re.search('(TradeDate:)([0-9]+[a-zA-Z]+[0-9]+)',line_buf).group(2),'%d%B%Y')) +',')
fp.write(re.search('(Price:[A-Z]+)([0-9.,]+)',line_buf).group(2).replace(',','')+',')
fp.close()
Logger类冲突问题排查
补充说明:使用Logger.getLogger(Class clazz)方法时可能遇到的类冲突问题。
由于项目中存在多个同名的Logger类,在测试阶段若未仔细甄别而直接选择了第一个出现的类,会导致功能无法正常使用。起初误以为是JAR包依赖问题,重新导入依赖包后仍无效,检查配置文件也无异常,最终排查发现是选用的Logger类不正确。
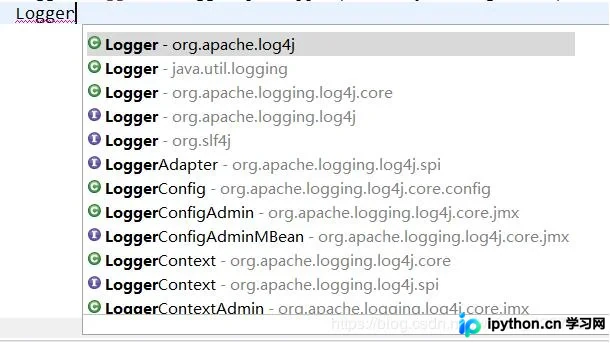
若需打印日志,应使用log4j包中提供的Logger类。
以上关于Python3使用PyPDF2解析PDF文件并通过正则匹配数据的内容即为全部分享,希望能为读者提供参考,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









