Python处理Unicode转义字符串与去除控制字符
本文介绍在Python中处理UTF-8文件时,如何去除数据中的\u0000等Unicode控制字符,以及如何将反斜杠u类型的\uXXXX字符串转换为对应的Unicode字符。通过Python的decode函数配合unicode-escape编码,可实现字符串的正确解码与清理。
2026-10-13
6

本文介绍在Python中处理UTF-8文件时,如何去除数据中的\u0000等Unicode控制字符,以及如何将反斜杠u类型的\uXXXX字符串转换为对应的Unicode字符。通过Python的decode函数配合unicode-escape编码,可实现字符串的正确解码与清理。
本文针对 Python 2.7 中字符串输出带有 u'...' 前缀的问题,解释其原因为 Unicode 编码显示。通过 .encode('utf-8') 方法可将字符串转换为 UTF-8 编码的字节串,从而消除前缀。该方法适用于从网页获取数据并进行 JSON 解析的场景,但需注意其对 list 和 dict 类型不直接支持,建议先转换再存储。
本文梳理 JavaScript 五大原始类型,重点解析数字类型的溢出、下溢及 NaN 判断机制,阐明 IEEE-754 标准导致的浮点数计算误差原理,并深入讲解 Unicode UTF-16 编码下的字符串特性、转义字符及不可变性质。
本文详细解析Python中bytes(字节序列)与str(字符串)的区别,重点介绍两者之间的转换方法。通过encode()和decode()函数实现编码与解码过程,并演示如何将字符串转换为字节对象以及反向操作,帮助开发者理解字符编码在计算机处理中的作用。
本文详细解析了Python中将文件内容读取为字符串的三种主流方法:直接赋值调用、使用read()全量读取以及结合readlines()迭代处理。通过具体代码示例,展示了如何灵活处理不同格式的文件数据,并补充了按空格分隔字符串的实战技巧,帮助初学者快速掌握文件读写核心技能。
本文详细介绍Python中字符串的创建特性及常用操作方法,包括去除空格、统计、查找、大小写转换、替换、格式化等核心功能。同时结合实例演示如何将列表转换为字符串并写入文件,以及如何读取文件内容,帮助开发者掌握字符串处理与基础文件IO操作。
本文深入解析Python 3.6引入的f-Strings增强型字符串格式化方法。通过对比传统的%-格式化和str.format(),展示f-String在可读性、执行效率及灵活性上的优势。内容涵盖单行与多行f-String写法、任意表达式求值、__str__与__repr__的使用及!r标识符技巧,帮助开发者掌握现代Python字符串处理的最佳实践。
本文通过多个Python正则表达式实战案例,详细解析字符串处理技巧。内容涵盖数字范围匹配、座机与QQ号格式校验、多字符分割、连续数字替换、字母提取、单词查找及HTML标签清理等常见场景。每个案例均提供完整代码与运行结果,帮助开发者快速掌握re模块在数据清洗和文本分析中的实际应用。
本文介绍了在Python中生成大写32位UUID的方法,通过uuid模块生成标准UUID并去除连字符后转换为大写。同时补充了生成32位纯数字随机数的思路,涉及随机数生成与字符串拼接操作,提供相关代码参考。
本文介绍Python中字符串与UUID的相互转换方法,涵盖str、int及hex格式到UUID对象的解析。同时补充了Python中时间字符串与time对象的互转、时间加减运算及比较逻辑,提供完整代码示例供参考。
本文介绍如何使用Python生成六万个不重复的8位随机字符串,包含数字与大小写字母。通过集合自动去重机制确保唯一性,并将结果保存至CSV文件。同时提供固定长度不重复字符串及百万级数据生成的扩展代码示例,适用于测试数据造景场景。
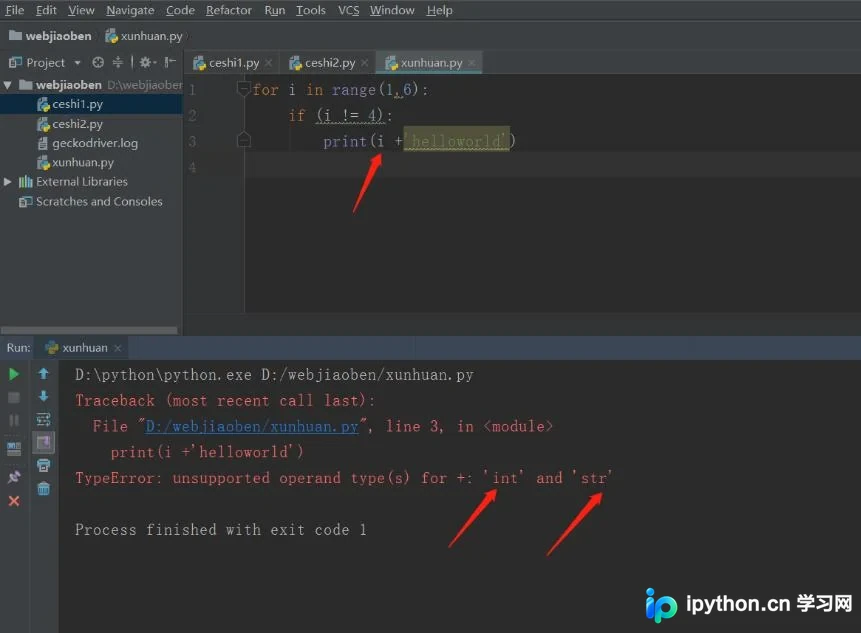
本文详解Python中字符串与数字拼接时触发的TypeError错误。由于Python是强类型语言,直接相加会报错。解决方法是使用str()将数字转换为字符串后再进行连接操作,例如c = str(a) + b。通过实例演示了正确的拼接方式及结果。