

Python实现简单网页图片抓取完整代码实例
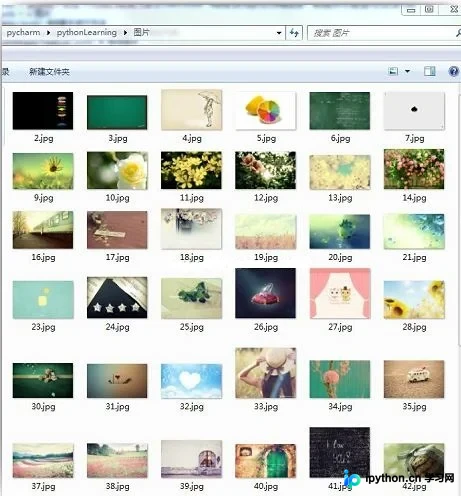
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
2026-10-14
6

本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
本文介绍如何在Python中使用re.subn()函数进行正则表达式替换。该函数不仅返回替换后的字符串,还同时返回实际发生替换的次数。通过compile编译正则对象,结合命名分组语法,可高效处理文本替换任务并获取操作统计信息。
本文介绍Python中正则表达式的后向搜索肯定模式(Lookbehind Assertion)。该模式用于在匹配内容前检查特定条件,但匹配结果不包含该前缀。通过Python代码示例,展示如何利用此模式提取Twitter用户名,并解析相关语法结构及运行结果。
本文详细解析Python中字符串与字典的核心操作。涵盖字符串的%格式化、模板字符串及find、join、split等常用方法;深入讲解字典的构造、增删改查、copy、get、update等API使用。通过具体代码示例,帮助开发者掌握Python数据处理基础技能,提升编程效率。
本文梳理了从ASCII到UTF-8的字符编码发展史,重点解析Python2与Python3在字符串处理上的核心差异。通过具体代码示例,展示了Python2中字节串与Unicode互转的decode/encode流程,以及Python3中字符串直接编码为字节串的新机制,帮助开发者理解不同版本下的编码转换逻辑。
本文详细记录了使用Python编写小说爬虫的全过程。文章从确定目标网址、分析页面结构入手,重点讲解了如何使用urllib.request获取网页内容,并通过设置Headers解决403 Forbidden错误。同时,针对常见的编码乱码问题,介绍了使用chardet库检测编码及手动指定GBK编码的方法,并结合socket.timeout处理网络超时异常,最终通过正则表达式提取章节内容并写入文件,提供了完整的代码实现参考。
本文总结Python中字符串与十六进制、二进制、八进制之间的转换方法,涵盖decode('hex')、hex()、binascii库及int()函数的使用。结合CTF赛题实例,提供二进制、ASCII、十六进制转字符串的Python脚本工具,帮助安全研究人员高效处理编码转换任务。
本文详解Python正则表达式中的分组机制,包括无名分组与命名分组的语法及提取方法。深入解析后向引用实现字符串交换,以及前向/后向肯定与否定断言在复杂匹配中的应用,附带代码实例与实用工具推荐。
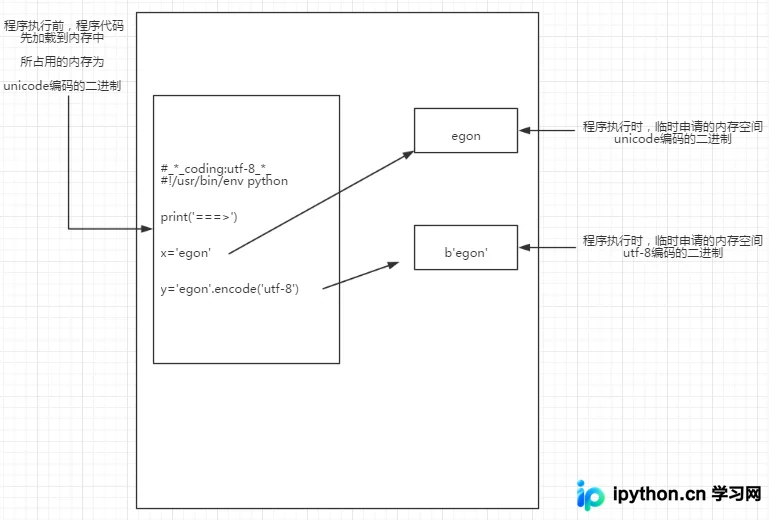
本文深入解析Python字符编码机制,阐述ASCII、GBK、Unicode及UTF-8的发展与区别。重点讲解Python解释器执行流程中文件读写与内存编码转换原理,对比Python2与Python3在字符串类型(str/bytes/unicode)及默认编码策略上的核心差异,帮助开发者避免编码错误。
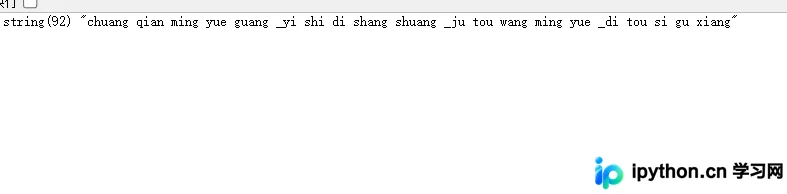
PHP 原生环境默认不包含中文转拼音扩展。本文整理并优化了两种常用实现思路:基于全量 Unicode 字库的 UTF-8 直接映射法,以及利用 GBK 编码边界进行区间检索的快速查表类。文章附带精简后的完整代码与参数配置说明,便于开发者直接在项目中集成拼音转换功能。
本文深入解析Python正则表达式中的贪婪与非贪婪匹配机制。通过具体代码示例,详细阐述默认贪婪行为导致的匹配偏差,并介绍使用问号?实现非贪婪匹配的方法。此外,还探讨了利用零宽断语(?=)和(?!解决字符消耗问题的技巧,帮助开发者更精准地控制正则表达式的匹配行为。
本文介绍在Python中去除字符串行尾换行符及多余空格的实用技巧。通过组合使用strip()与replace()函数,可以有效清理包含\n、\t、\r及空格的字符串。该方法适用于数据清洗场景,确保文本内容干净无冗余字符。