


在 SQL 里,DISTINCT经常被当成“万能去重键”,但一碰到子查询、关联查询或排序逻辑,结果往往和预期不一样。要判断它到底该不该用,关键不是盯着语法本身,而是先分清重复是由 JOIN 膨胀、字段值并不完全相同,还是查询目标其实是“保留某一条代表记录”。
下面就按几类最常见的误区拆开看:先解释为什么子查询里已经去重,外层结果仍会重复;再看哪些“看起来一样”的行其实并不相同;最后说明在聚合、窗口函数和排序场景中,DISTINCT为什么会变成冗余项,甚至直接制造错误判断。
子查询里加了 DISTINCT,外层 JOIN 后为什么还会重复
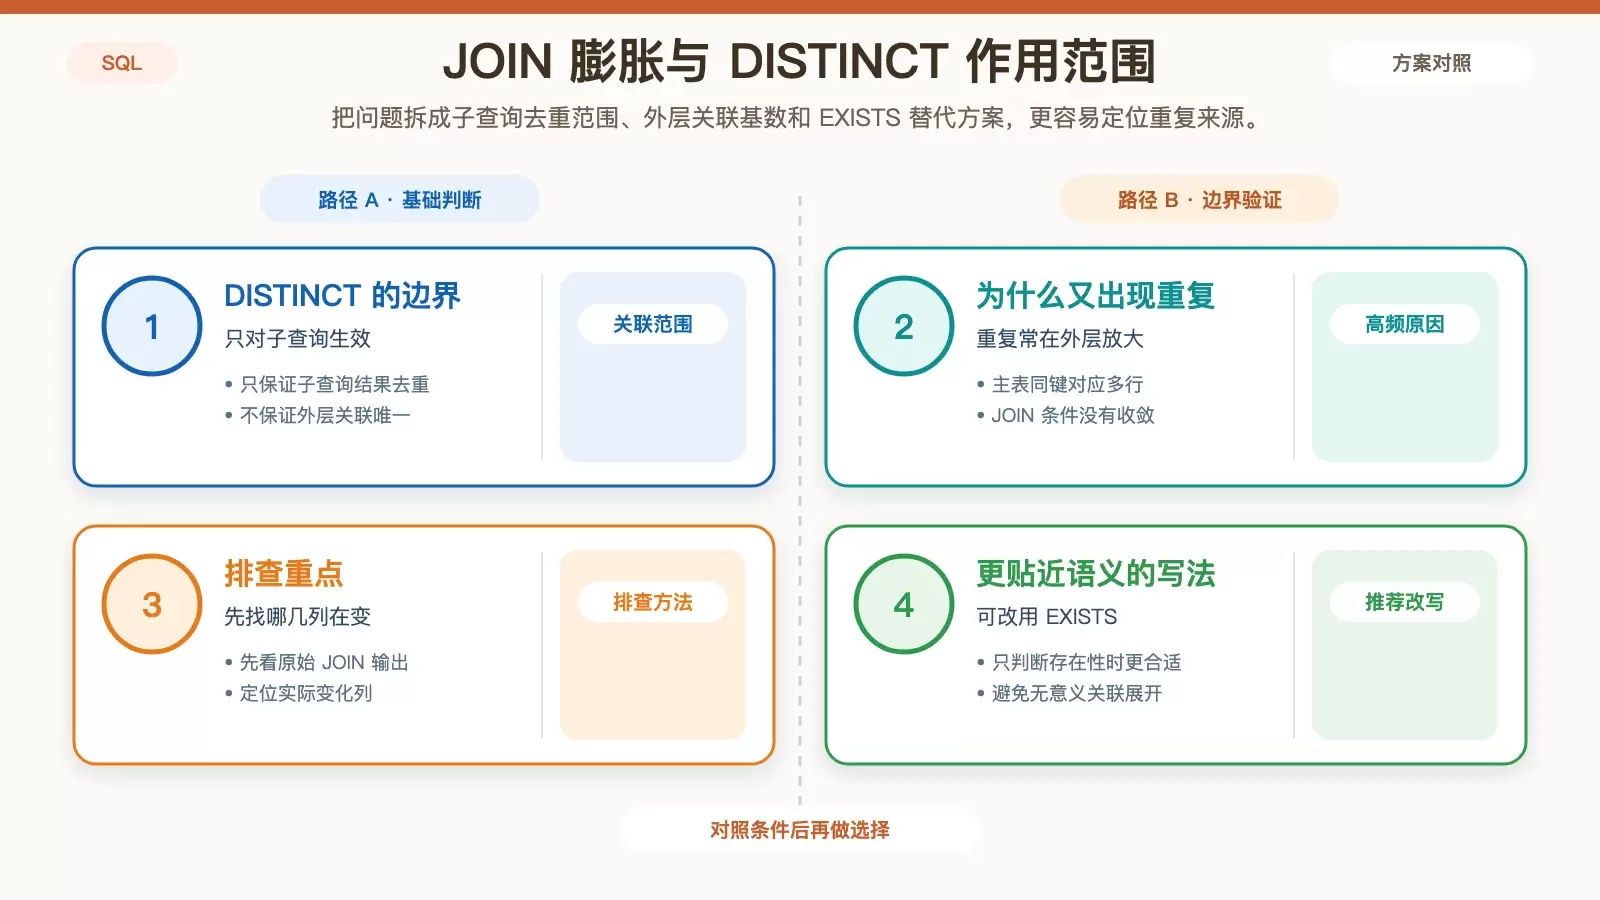
这类情况最常见,也最容易误判。根本原因不是 DISTINCT 没生效,而是它只作用于子查询自己的结果集。这个结果集一旦作为派生表参与 JOIN,只要关联字段本身不唯一,或者 JOIN 条件没有收敛,结果就会再次放大。
例如下面这条语句:
SELECT * FROM orders o JOIN (SELECT DISTINCT user_id, region FROM users) u ON o.user_id = u.user_id这里子查询只保证 user_id, region 这个组合在 users 结果中不重复,但并不保证外层 orders 表里每个 user_id 只出现一次。如果 orders 中同一个 user_id 有多条订单,那么每条订单都会与 u 中对应记录匹配,重复自然就出来了。
判断这类问题时,先不要急着在最外层再套一层 SELECT DISTINCT *。那通常只是对已经膨胀的结果做事后补救,既影响性能,也会掩盖真正的关联问题。更实用的排查方式有三步:
- 先用
SELECT *检查原始 JOIN 结果,确认到底是哪些列在变化。很多时候,变化列不是主键,而是时间戳、明细 ID、状态记录这类天然多值字段。 - 如果你只需要判断“是否存在匹配记录”,不要硬做 JOIN,可以改成
EXISTS或IN。 - 把唯一性约束前移,先确认子查询输出的字段组合,是否真的是外层 JOIN 所需要的唯一键。
比如原先写成:
JOIN (SELECT DISTINCT ...)很多时候更适合改成:
WHERE EXISTS (SELECT 1 FROM users u WHERE u.user_id = o.user_id AND u.status = 'active')这样做的重点不是“换个写法”,而是把需求从“关联出记录”改回“判断条件是否成立”。如果业务只关心主表数据,EXISTS 往往比 JOIN 去重更符合语义。
为什么 DISTINCT 去不掉“看起来一样”的行
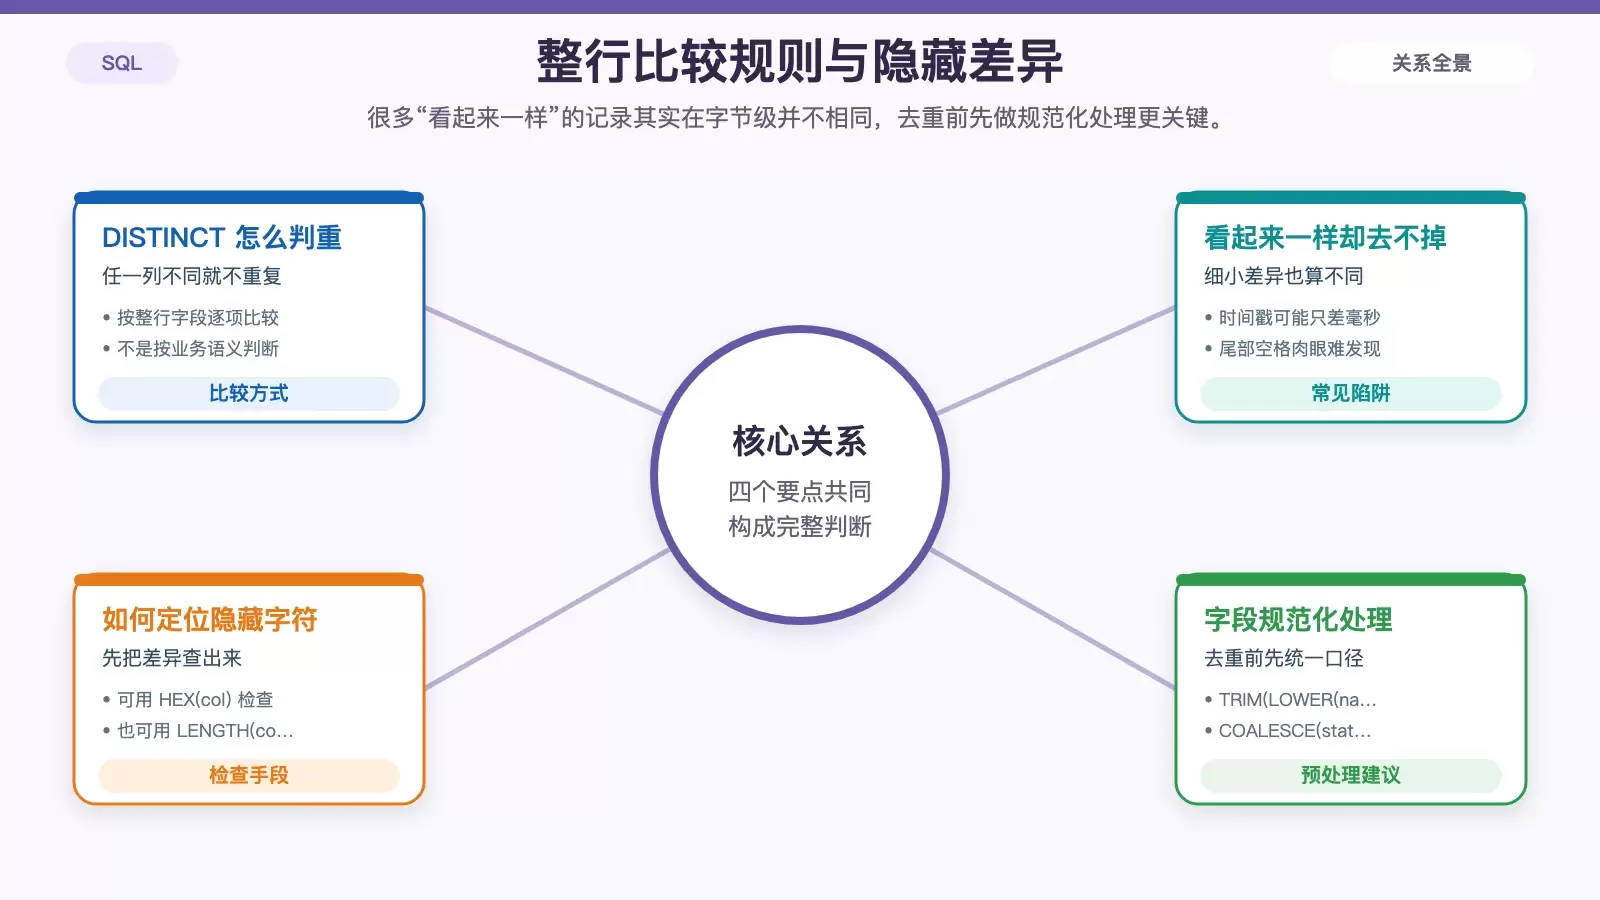
第二类误区来自对“重复”的理解不同。DISTINCT 判断重复,靠的是整行字段值逐项比较,不会按业务语义替你做归一化处理。也就是说,只要任意一个字段不同,这两行就不是重复行。
常见的情况包括:
name一样,但created_at相差 1 毫秒。lotno末尾多了一个空格,肉眼看不出来。- 一个字段是
NULL,另一个是空字符串''。
这些在业务上也许都能算“同一条”,但在 SQL 执行层面,它们就是不同的值,所以 DISTINCT 不会帮你合并。
遇到这种情况,排查重点不是继续加更多层去重,而是先把差异找出来。可以直接检查字段的原始表现形式,例如:
SELECT HEX(col)或:
SELECT LENGTH(col)这样能确认是否存在隐藏空格、不可见字符或编码差异。
如果问题出在字符串规范不一致,就应该在去重前先做预处理。例如:
TRIM(LOWER(name))以及:
COALESCE(status, 'UNKNOWN')前者把大小写和首尾空格收敛到统一形式,后者避免 NULL 与空值混用导致的结果分裂。
这里还有一个容易被忽略的跨库差异:MySQL 默认通常不区分大小写,而 PostgreSQL 是区分大小写的。同一套 SQL 在迁移数据库后,DISTINCT 的结果可能突然变化,问题不一定出在语句本身,而在底层比较规则已经变了。
遇到 GROUP BY 或窗口函数,DISTINCT 什么时候是多余的
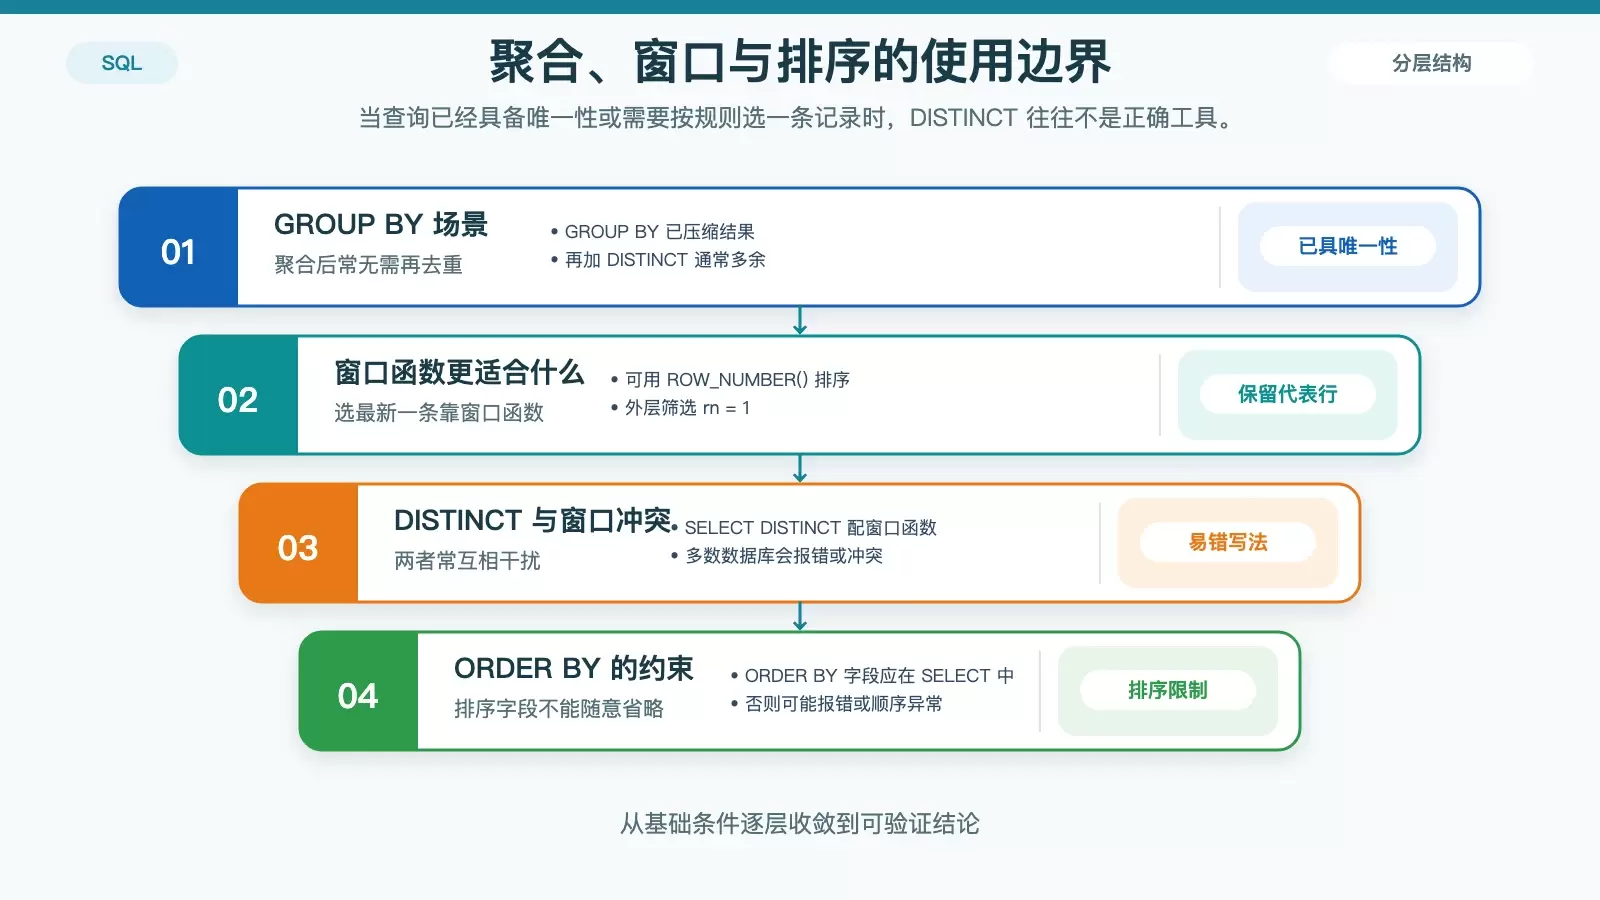
如果子查询里已经用了 GROUP BY 或 ROW_NUMBER() 一类窗口函数,再机械地补上 DISTINCT,通常没有帮助,反而容易把语义搅乱。
例如这条语句:
SELECT DISTINCT user_id, MAX(create_time) FROM orders GROUP BY user_idGROUP BY user_id 本身就已经把结果压成每个 user_id 一行了,这里的 DISTINCT 不再提供额外约束,只是增加理解成本。
再比如:
SELECT DISTINCT *, ROW_NUMBER() OVER (...) FROM t这类写法在多数数据库中都不可靠,甚至会直接报错。原因在于窗口函数依赖明确的分区和排序逻辑,而 DISTINCT 试图在结果层重新折叠行,二者经常互相冲突。
这一节最重要的判断标准是:当前查询是不是已经隐含唯一性。如果已经通过下面这些方式保证了唯一输出,就应优先删掉 DISTINCT:
GROUP BY的字段本身就是目标唯一键。- 已经用
ROW_NUMBER() ... WHERE rn = 1选出每组一条记录。 - 派生表或 CTE 的筛选条件已经明确保留了唯一结果。
尤其在“按某列去重,但还要保留整行”这种需求里,DISTINCT 基本无能为力。因为它只会按选出的整行字段组合去重,无法表达“同一个用户只保留最新一条”这种带排序规则的业务要求。真正合适的做法,通常是 ROW_NUMBER() 配合 CTE 或子查询,再筛掉 rn != 1 的记录。
还有一个边界要记住:不要把 ROW_NUMBER() 直接塞进 WHERE 子句里。窗口函数通常只能出现在 CTE、派生表或 SELECT 列表中,先算出序号,再在外层过滤,才是稳妥写法。
ORDER BY 不在 SELECT 列表里,为什么会造成“去重失效”的错觉
不少查询的问题并不是重复数据真的没被去掉,而是排序方式让结果看起来很混乱。典型写法是:
SELECT DISTINCT name FROM users ORDER BY created_at看到顺序不稳定,甚至执行直接报错,就容易误以为 DISTINCT 失效了。实际上,问题出在 ORDER BY 引用了未出现在 SELECT 列表中的字段。
在这种情况下,不同数据库的反应并不一样。有的数据库会直接拒绝执行,例如 MySQL 5.7+ 严格模式下就很常见;有的数据库可能返回内部顺序,结果虽然“去重了”,但显示出来像是顺序错乱,进而让人误判。
这里有两个实用原则:
ORDER BY使用的字段,最好直接出现在SELECT列表中,或者使用其别名。- 如果确实想按未直接输出的字段排序,就把去重和排序拆成两层查询。
例如可以改写成:
SELECT name FROM (SELECT DISTINCT name, MAX(created_at) AS max_time FROM users GROUP BY name) t ORDER BY max_time这样一来,内层先明确“每个 name 对应哪个排序值”,外层再按这个值排序,语义就完整了。
另外,PostgreSQL 支持 DISTINCT ON (col),在某些“按列去重并结合排序”的场景下确实很好用。但它并不兼容 MySQL 或 SQL Server,面向通用环境的 SQL 最好不要依赖这种方言特性。
真正该判断的,不是写不写 DISTINCT
很多时候,DISTINCT 被误用,不是因为开发者不会写,而是因为一开始就没把“重复”的来源分清楚。你需要先回答的是:重复到底来自哪一层。
- 如果是数据本身冗余,应该先清理字段值或统一口径。
- 如果是 JOIN 路径发散,应该调整关联方式或改成
EXISTS。 - 如果字段组合天然不唯一,单靠
DISTINCT就不可能得到你想要的一行。 - 如果业务目标是“保留最新一条”或“每组取一条代表记录”,那就该用排序加窗口函数,而不是继续堆去重。
真正麻烦的,从来不是 DISTINCT 写没写,而是查询语义没有提前收敛。只有先确认你要消除的是物理重复、关联膨胀,还是业务层的记录选择,后面的 SQL 写法才会稳定,性能和结果也才更可控。









