


把子查询放进 SQL 视图,问题往往不在“能不能写”,而在“数据库是否支持、返回值是否可求值、后续执行计划是否还能控住”。同样一段定义,在 PostgreSQL、SQL Server、MySQL 8.0+ 和 MySQL 5.7 上的结果可能完全不同。下面按常见使用场景拆开讲清楚:哪些写法能用,哪些会直接报错,遇到旧版本限制时该怎么改,以及为什么视图一旦嵌入子查询后,性能有时会突然失速。
子查询能不能直接写进视图定义
结论不能一概而论。数据库如果支持,在视图定义里通常可以使用标量子查询或相关子查询;但 MySQL 5.7 及更早版本限制明显,视图本身不支持这种灵活写法。原因在于优化器通常需要对视图定义做内联展开,而子查询会影响可更新性、权限推导以及执行计划生成。MySQL 8.0 之后才对部分简单场景有所放宽。
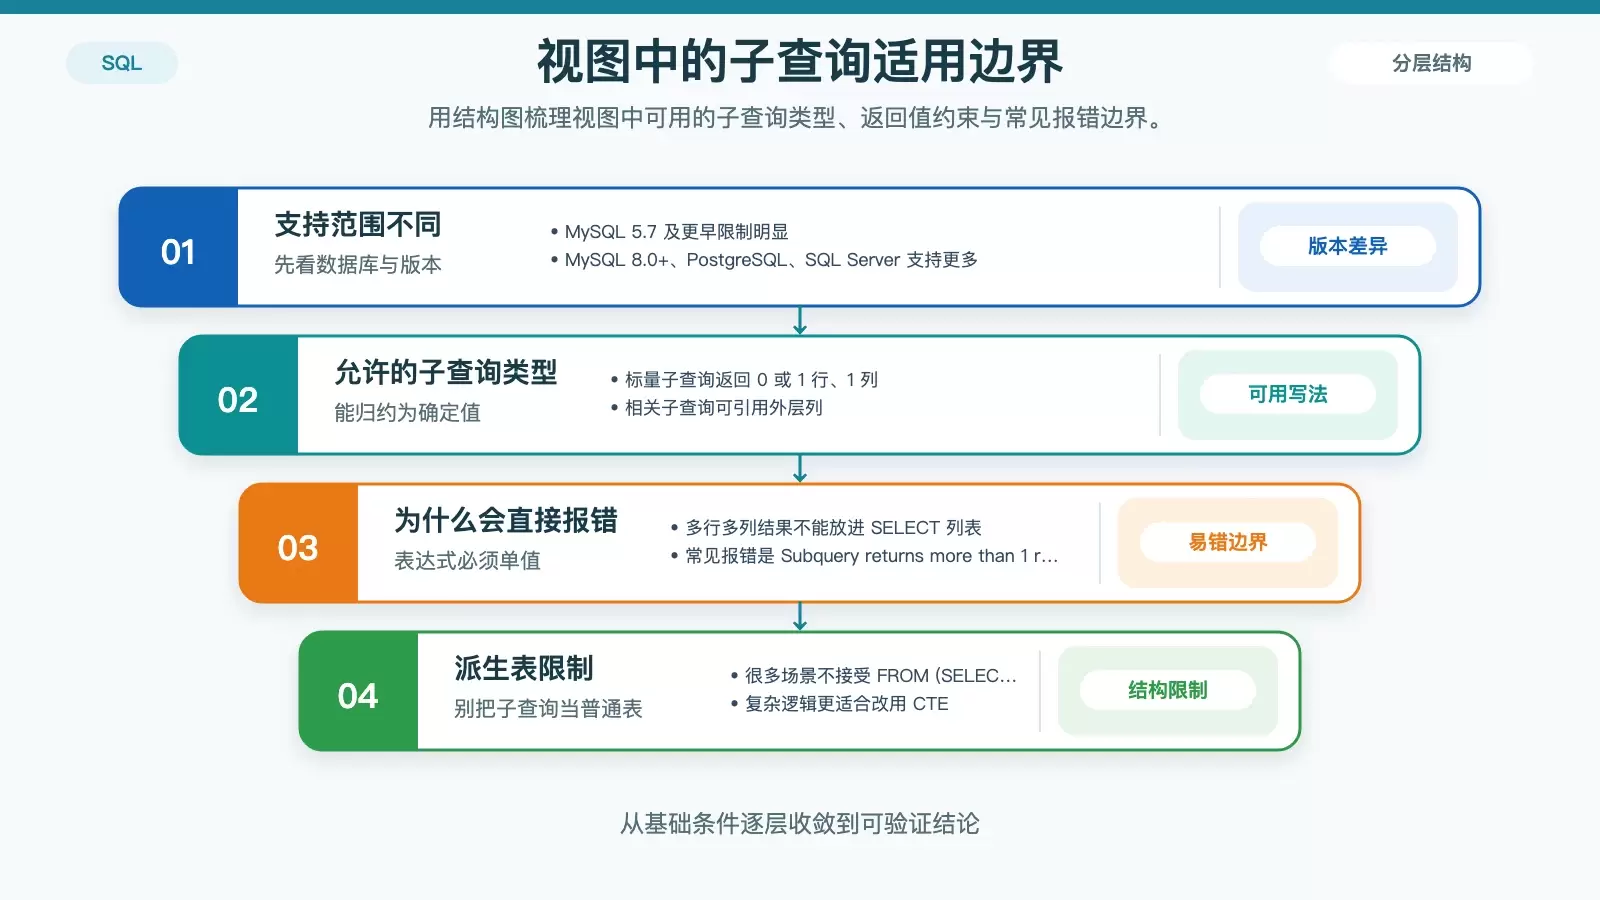
真正能放进 SELECT 列表里的子查询,必须满足“最终可求值”的要求,也就是它最后要么返回一个确定值,要么能和外层当前行建立一一对应关系。否则就不是把子查询当表达式使用,而是误把它当成普通表来写。
常见的可用情况主要有两类:
- 标量子查询:必须返回 0 或 1 行、1 列,例如
(SELECT COUNT(*) FROM logs WHERE logs.user_id = users.id) - 相关子查询:会引用外层列,例如
users.id,随着外层每一行的扫描重新执行
相反,如果你把一个会返回多行多列结果的查询直接塞进 SELECT 列表,例如 SELECT * FROM orders 这类形式,通常就会报错:
Subquery returns more than 1 row这不是单纯的语法问题,而是因为 SQL 标准要求 SELECT 列表中的每个表达式都必须产生确定值。与此同时,这类写法还容易把查询拖进典型的 N+1 执行陷阱。所以一旦子查询不再是单值表达式,优先考虑改写为 JOIN 或先做预聚合,通常更稳妥。
还要注意一个容易踩坑的限制:很多场景下,视图定义里并不接受 FROM (SELECT ...) AS t 这种派生表式子查询,除非数据库版本支持,或者你改用 CTE 把中间逻辑提出来。
用 WITH 改写复杂逻辑,可读性通常更好
当视图里开始堆两层、三层 SELECT 嵌套时,维护成本会迅速上升。字段从哪来、聚合在哪一层完成、关联条件是否漏写,都会变得不直观。对支持 CTE 的数据库来说,把逻辑改写成 WITH,通常是更适合长期维护的做法。
PostgreSQL 和 SQL Server 允许在视图定义中使用 WITH。这样可以把中间结果单独命名,再在主查询中复用,不必把相关子查询硬塞进 SELECT 列表。
例如,想查询每个用户的最新订单时间,可以这样写:
CREATE VIEW user_latest_order AS
WITH latest_orders AS (
SELECT user_id, MAX(created_at) AS max_time
FROM orders
GROUP BY user_id
)
SELECT u.id, u.name, lo.max_time
FROM users u
LEFT JOIN latest_orders lo ON u.id = lo.user_id;
这比在查询列表里直接写下面这种相关子查询更容易理解:
(SELECT MAX(created_at) FROM orders o WHERE o.user_id = u.id)两种写法在表达结果上可以一致,但 CTE 版本的好处更明显:
- 中间聚合逻辑被单独拆出,调试时更容易验证结果
- 主查询结构更清楚,字段来源一眼能看明白
- 数据库更容易针对中间结果做优化,某些场景下还能进行物化处理
如果你的视图不仅要查询结果,还要长期被其他查询继续 JOIN、过滤或复用,那么把复杂子查询改写成 WITH 或预聚合结果集,通常比直接嵌套更可靠。
MySQL 5.7 不支持 WITH 时怎么处理
MySQL 5.7 以及更早版本,是这类问题里最需要单独拎出来讨论的一档。它在解析视图定义时并不支持 WITH,写进去会直接报语法错误,因此不能照搬 PostgreSQL 或 SQL Server 的写法。
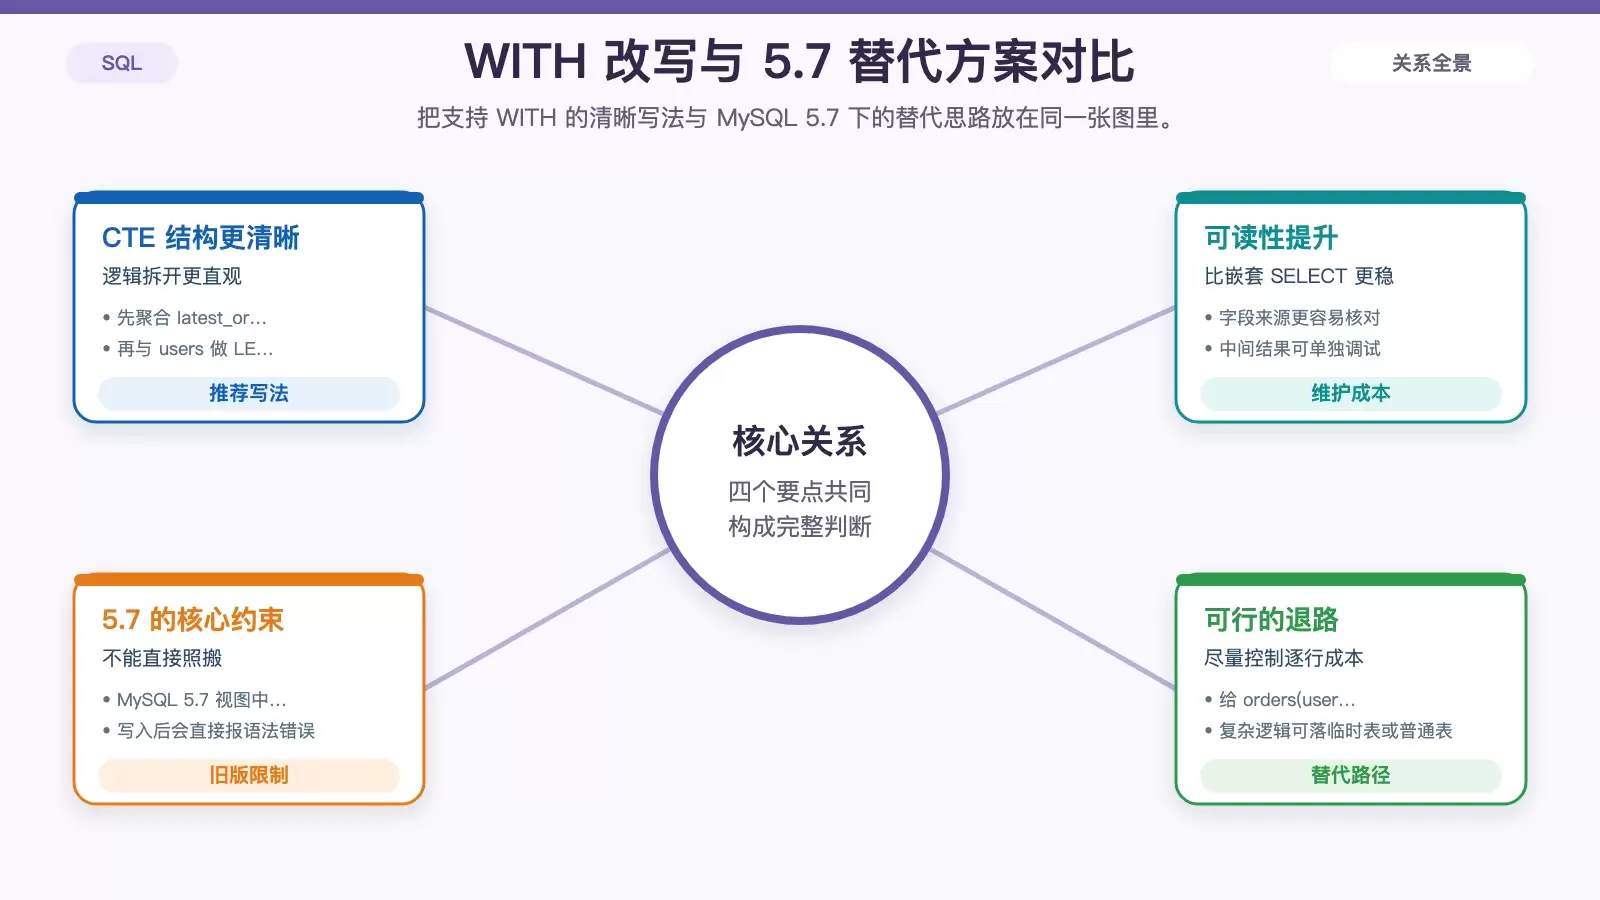
在这种环境下,如果又确实需要把逻辑封装进视图,通常只能退回到标量子查询和相关子查询的组合方案。但这样做时,性能风险会明显上升,尤其是当外层结果集较大时,每一行都可能触发一次子查询执行。
这时至少要守住几条底线:
- 尽量避免在
SELECT列表里对大表执行相关子查询,特别是会导致每行都扫描大量数据的场景 - 给子查询中的关联字段建立索引,例如
orders(user_id, created_at) - 如果逻辑本身已经比较复杂,优先考虑先落一层中间结果,比如临时表、普通表加定时刷新,或者其他可控的物化方案
- 如果条件允许,升级到 MySQL 8.0+ 往往是成本最低的长期解法,因为它已经支持
WITH
换句话说,MySQL 5.7 下不是完全不能做,而是要接受“能写进去”和“适合长期跑”是两回事。视图一旦承担复杂逻辑,就得提前评估数据量、索引覆盖和后续查询方式。
为什么视图里的子查询容易引发性能失速
很多人第一次遇到问题时会以为“子查询天然更慢”,其实并不准确。真正的风险通常来自优化器:它未必能像处理普通连接那样,准确推导子查询的统计信息、过滤条件传播路径和索引使用机会。尤其当子查询里还包含聚合、连接或相关条件时,执行计划很容易偏离预期。
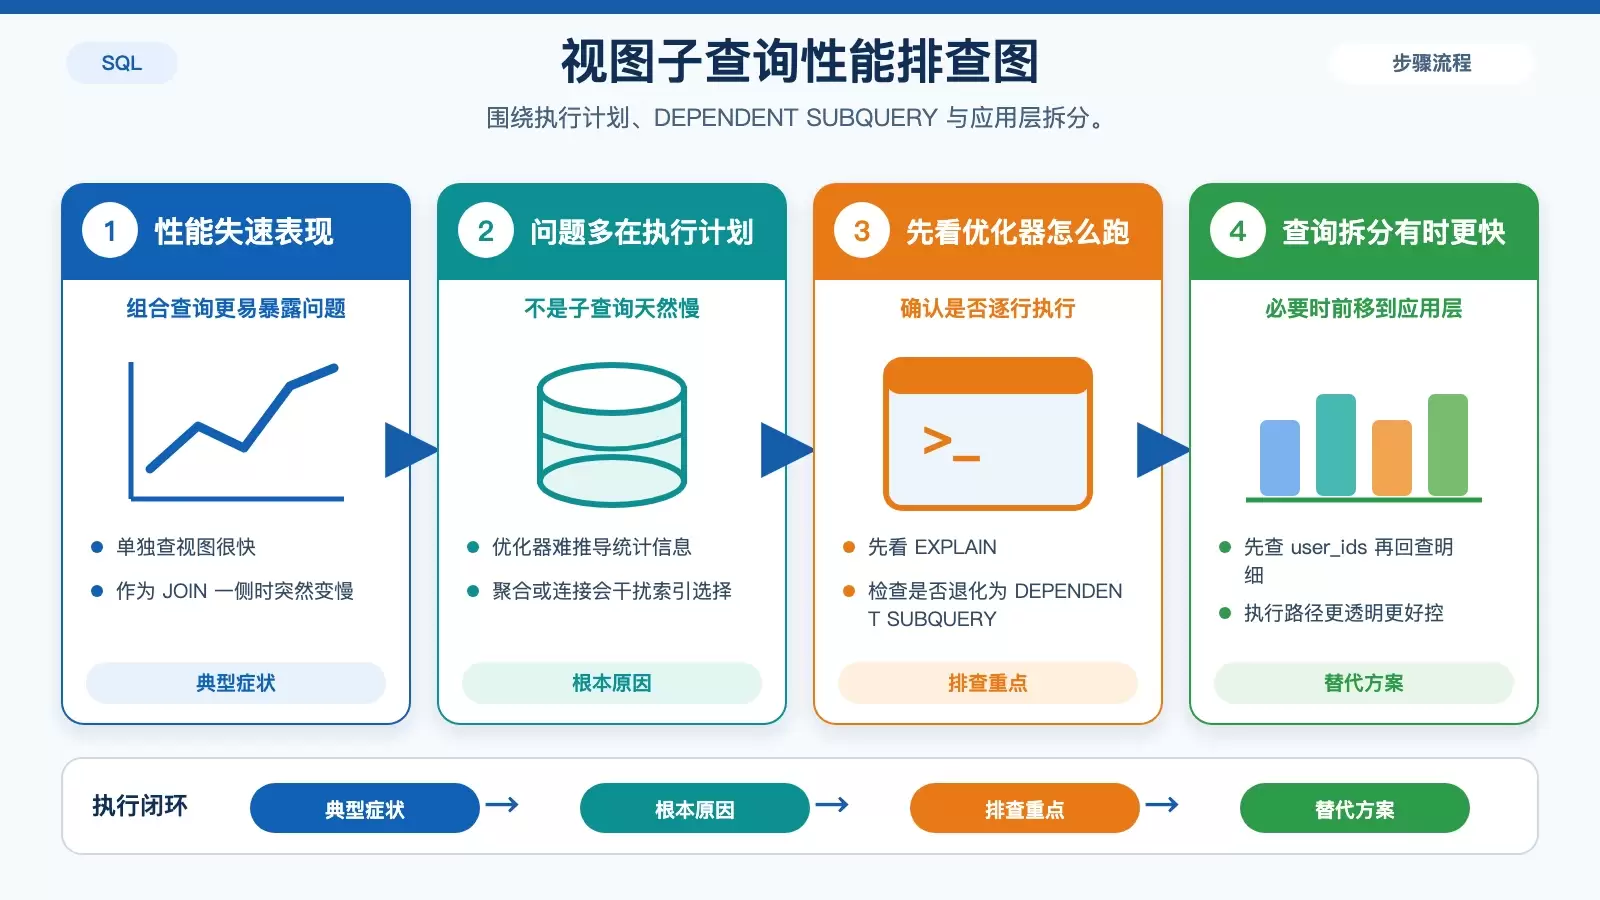
典型症状有两种:
- 视图单独执行看起来很快,但当它作为
JOIN的一侧参与更大查询时,响应时间突然拉长 - 给外层加了
WHERE条件后,本来以为会走索引,结果执行计划没有按预期变化
在 MySQL 这类数据库里,排查时最值得先看的就是 EXPLAIN。重点不是只盯着扫描行数,而是确认子查询有没有被优化器展开,还是已经退化成了 DEPENDENT SUBQUERY。一旦出现后者,通常意味着它会依赖外层逐行执行,成本可能随着结果集放大得非常快。
还有一个经常被忽视的事实是:视图把复杂性藏起来了,但数据库不会因为“看起来整洁”就更容易优化。相反,跨版本、跨引擎时,同一段 SQL 在不同优化器下可能表现完全不同。PostgreSQL 某些场景下还能尝试 /*+ MATERIALIZE */ 这类提示来影响执行策略,不过这依赖额外插件支持,也不是标准写法,使用时要谨慎。
如果你已经确认子查询版本难以让优化器稳定工作,有时把逻辑前移到应用层反而更现实。比如先查出一批 user_ids,再按这些主键回查明细数据,虽然步骤变多,但执行路径更透明,也更容易针对实际业务流量做缓存或分段处理。
实际落地时怎么判断该不该用
把子查询写进视图,不是单看 SQL 能不能通过,而是要同时判断四件事:数据库版本是否支持、子查询是否满足单值或相关求值规则、是否存在可替代的 JOIN/WITH/预聚合方案,以及执行计划是否还能稳定命中预期索引。
可以按下面的顺序快速判断:
- 如果是 PostgreSQL、SQL Server、MySQL 8.0+,优先考虑使用
WITH或清晰的聚合后再关联 - 如果只是返回单个统计值,标量子查询可以用,但先确认不会放大为逐行高成本执行
- 如果数据库是 MySQL 5.7,默认把复杂视图视为高风险对象,尽量简化或物化
- 一旦视图会继续被其他查询复用,务必用
EXPLAIN检查它在真实组合查询中的行为,而不是只测试视图单独执行
归根结底,子查询在视图里不是禁区,但它很容易掩盖执行路径的不确定性。尤其在跨版本、跨数据库引擎的项目中,保持结构清晰、限制嵌套层级、优先选择更可优化的写法,往往比单纯追求“SQL 写进一个视图里就结束”更重要。









