Python中利用pandas与sklearn划分训练集和测试集的方法
本文介绍如何在Python中使用pandas处理数据,并结合sklearn库进行数据集划分。详细讲解train_test_split函数的随机划分方法及KFold交叉验证的原理与参数设置,包括shuffle和random_state的影响,帮助开发者优化模型训练流程。
2026-10-15
5

本文介绍如何在Python中使用pandas处理数据,并结合sklearn库进行数据集划分。详细讲解train_test_split函数的随机划分方法及KFold交叉验证的原理与参数设置,包括shuffle和random_state的影响,帮助开发者优化模型训练流程。
本文介绍PyCharm中解决Unresolved reference 'sklearn'错误的两种方法。首先通过修改Console设置勾选Add source roots to PYTHONPATH并重启IDE;其次针对Python 3.6中sklearn弃用cross_validation的情况,建议使用model_selection模块导入train_test_split。
本文详解sklearn中predict与predict_proba的区别:前者返回预测标签,后者返回各类别概率数组。重点指出当训练集缺失某些类别时,predict_proba列数会减少,导致predict结果与最大概率索引不一致。建议使用train_test_split的stratify参数保持数据分布一致,避免此类隐蔽Bug。
本文详细介绍如何在Python中使用matplotlib库可视化打印混淆矩阵,涵盖sklearn.metrics.confusion_matrix与tf.confusion_matrix两个核心API的参数解析、对比及完整代码示例,帮助开发者直观评估分类模型性能。
本文介绍如何使用Python的numpy和sklearn库将CSV数据矩阵划分为训练集和测试集。通过train_test_split函数,按7:3比例随机分割输入特征X和标签y,并支持指定random_state。最后将分割后的数据保存为CSV文件,便于后续模型训练。
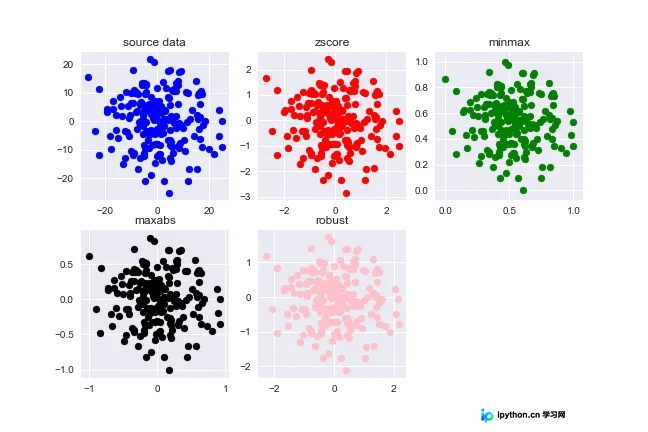
本文介绍Python中数据标准化的四种核心方法:Max-Min归一化、Z-Score标准化、MaxAbs绝对值标准化及RobustScaler鲁棒标准化。通过Sklearn库实现,解析各方法适用场景,如稀疏数据与含离群点数据的处理,助力提升模型训练效果。
本文介绍如何使用Python的Sklearn库实现简单的逻辑回归模型。通过读取Excel数据,利用NumPy进行数据处理,并使用Matplotlib进行可视化展示。代码涵盖了数据加载、模型训练、预测及结果评估的全过程,旨在为初学者提供清晰的逻辑回归实现示例。
本文介绍了如何在Python环境中利用KNN算法对Iris数据集进行分类。通过加载数据集、划分训练测试集、标准化处理以及模型训练与评估,展示了完整的分类流程。代码示例涵盖了从数据加载到结果输出的关键步骤,帮助读者快速掌握KNN在分类任务中的应用。
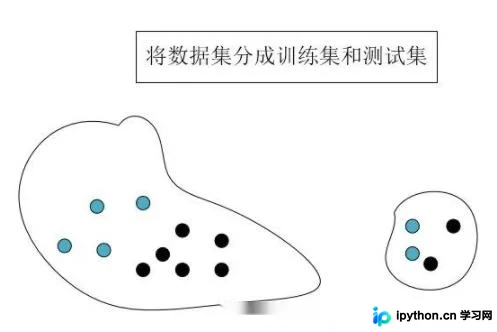
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
本文深入解析Python中StratifiedShuffleSplit函数的使用方法。该函数通过分层洗牌策略,在保持类别比例一致的前提下进行多次随机分割,适用于不平衡数据集的模型训练。文章详细说明了n_splits、test_size、train_size及random_state等关键参数的配置逻辑,并结合具体代码示例展示了如何生成满足特定比例的多组训练与测试集,帮助开发者优化模型评估流程。
本文介绍如何使用sklearn.preprocessing.LabelEncoder将分类标签转换为0到n_classes-1之间的连续整数编码。通过fit、transform和inverse_transform方法,可实现标签的标准化处理。文中提供了针对Series、DataFrame整体及特定列的多种转换示例,包括自定义多列编码器类的使用,帮助开发者高效完成分类数据的预处理工作。
本文详细讲解如何利用Python实现感知机(PLA)算法,涵盖原始形式与对偶形式的代码实现及实验结果对比。同时演示如何调用sklearn库中的Perceptron类进行模型训练与评估,通过具体案例展示分类准确率与错误率,帮助读者理解线性分类器的核心逻辑与工程应用。