Python中MSE、RMSE、MAE与R2的计算及sklearn实现
本文详细介绍Python中回归模型常用的评估指标:均方误差(MSE)、均方根误差(RMSE)、平均绝对误差(MAE)及决定系数(R2)。内容涵盖从原生Python列表推导到NumPy向量化计算的多种实现方式,并演示如何利用sklearn库快速调用相关函数进行模型评估,帮助开发者理解各指标的计算逻辑与应用场景。
2026-10-13
6

本文详细介绍Python中回归模型常用的评估指标:均方误差(MSE)、均方根误差(RMSE)、平均绝对误差(MAE)及决定系数(R2)。内容涵盖从原生Python列表推导到NumPy向量化计算的多种实现方式,并演示如何利用sklearn库快速调用相关函数进行模型评估,帮助开发者理解各指标的计算逻辑与应用场景。
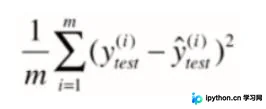
本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。
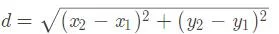
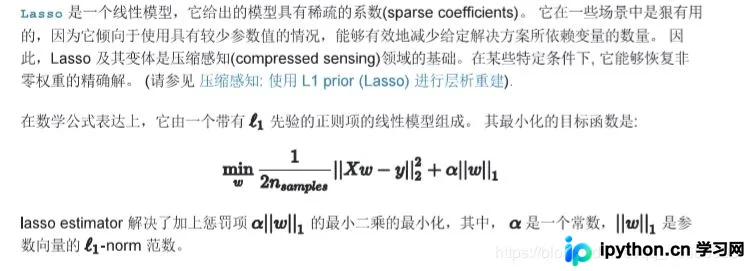
本文详细介绍如何使用Python和scikit-learn库实现Lasso回归,并通过代码示例展示其与弹性网络(Elastic Net)在稀疏数据场景下的性能对比。文章包含数据生成、模型训练、参数设置及可视化结果分析,帮助读者理解正则化方法对特征选择的影响。
本文介绍基于Python3.5和sklearn库,利用支持向量机(SVM)算法自动识别纯字母验证码的技术方案。内容涵盖从大量样本获取、图像灰度化与二值化预处理、垂直投影法字符分割,到使用Tesseract OCR辅助标注及SVM模型训练的全过程。文中还详细解析了处理黏连字符的滴水算法及常见配置坑点,旨在为开发者提供完整的实战参考。
本文介绍如何使用Python的sklearn库实现K近邻回归模型。通过波士顿房价数据集,演示数据预处理、标准化及模型训练流程。重点对比等权重(uniform)与不等权重(distance)两种策略在预测精度上的差异,包括均方误差和平均绝对误差的分析,帮助开发者理解不同权重设置对回归结果的影响。
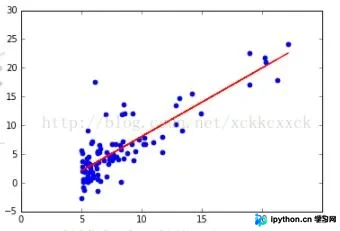
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。
本文详细解析Python中import与from import两种模块导入方式的区别。通过random和sklearn实例说明语法差异,重点解释为何import sklearn后无法直接通过sklearn.datasets访问属性,揭示模块内部__init__.py配置对导入行为的影响,帮助开发者避免常见导入错误。
本文详解Python中sklearn库的One-Hot编码技术。阐述将离散特征映射至欧式空间以优化距离计算的原理,并通过具体代码示例解析OneHotEncoder的使用,包括fit与transform方法的输出结果及维度分析,帮助开发者掌握特征预处理技巧。
本文详解Python线性回归模型中的拟合优度检验标准,重点解析判定系数R^2的含义、计算公式及评估标准。通过总体平方和、回归平方和与残差平方和的关系,结合具体代码示例演示如何计算R^2并评估模型准确性,帮助开发者掌握模型验证的核心方法。
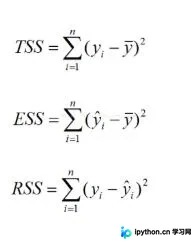
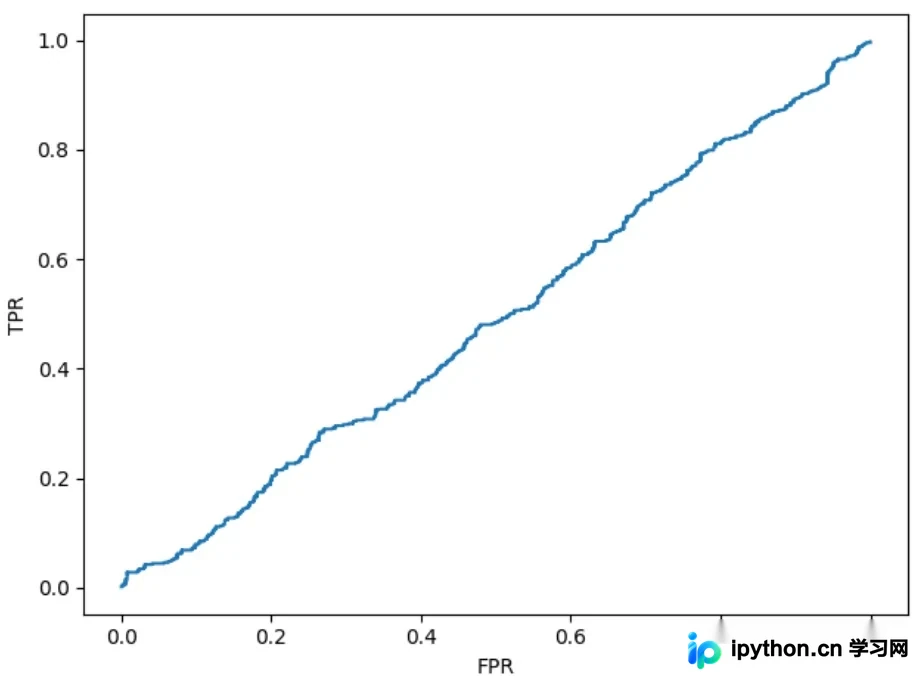
本文总结Python中计算AUC(ROC曲线下面积)的三种常用方法。首先介绍使用sklearn库直接计算的方式,其次详解通过遍历阈值计算面积的方法,最后讲解基于样本排序简化计算的算法。文章提供完整代码示例及运行结果分析,帮助开发者理解不同实现逻辑及其适用场景。
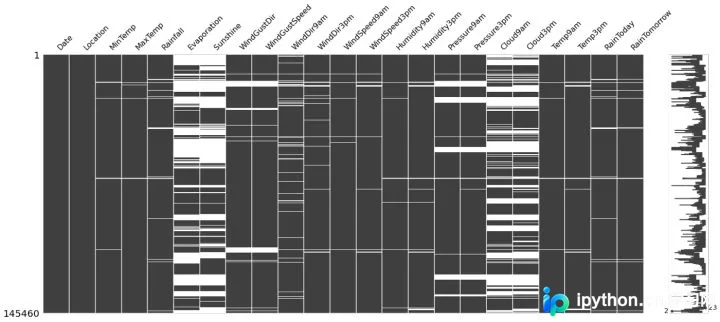
本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
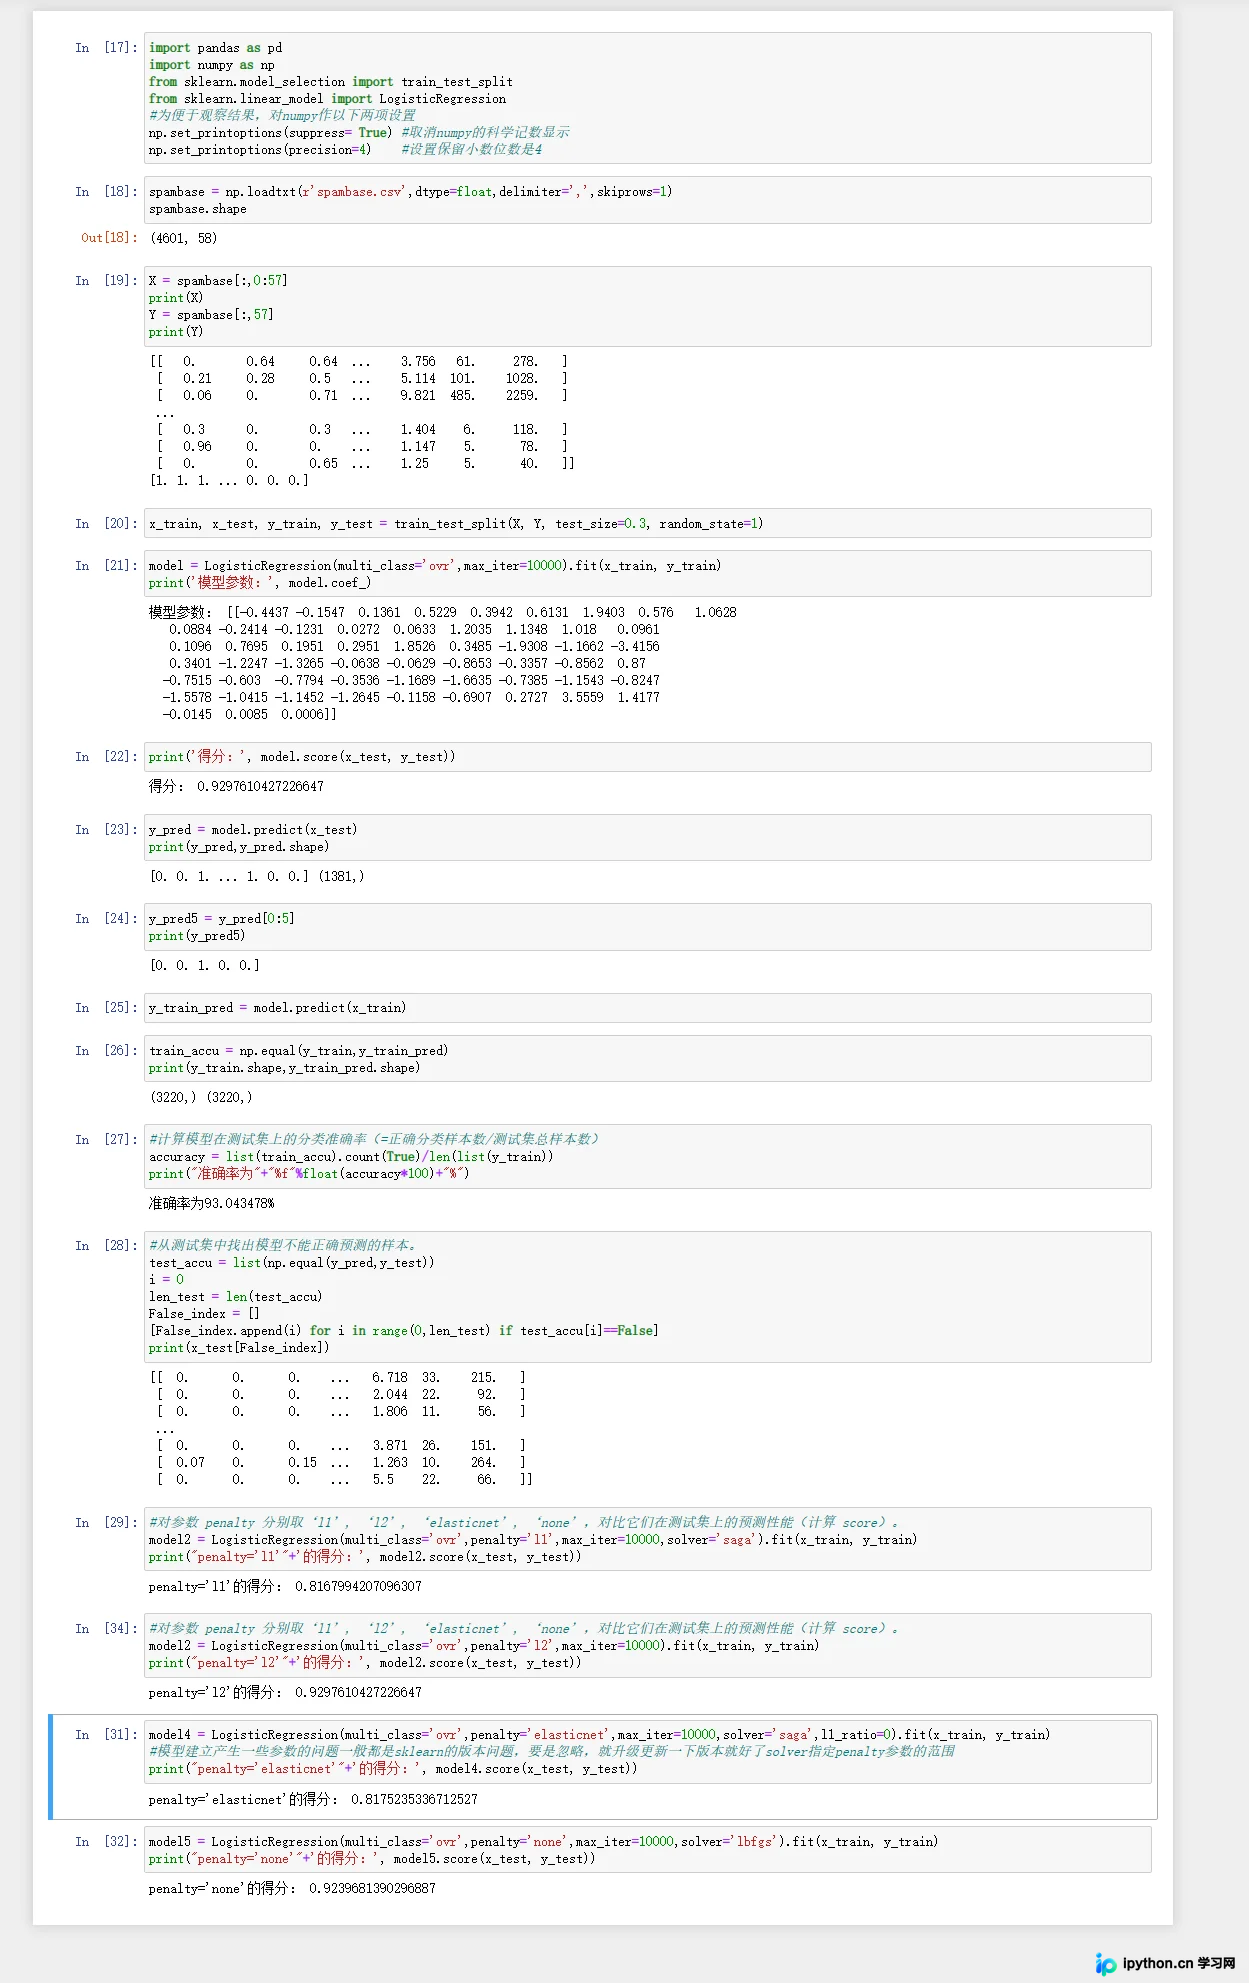
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。