

Python3.5 + sklearn利用SVM自动识别字母验证码方法示例

本文介绍基于Python3.5和sklearn库,利用支持向量机(SVM)算法自动识别纯字母验证码的技术方案。内容涵盖从大量样本获取、图像灰度化与二值化预处理、垂直投影法字符分割,到使用Tesseract OCR辅助标注及SVM模型训练的全过程。文中还详细解析了处理黏连字符的滴水算法及常见配置坑点,旨在为开发者提供完整的实战参考。
Python3.5结合SVM实现字母验证码识别
前言
近期在深入探索人工智能领域,为深化对各类算法的理解,我决定开发一个自动识别验证码的程序。浏览网络上的相关示例后发现,多数代码仍基于Python2编写,且演示案例多集中于数字识别。因此,本文旨在分享一个基于Python3的字母验证码识别实现过程。在开发过程中遇到了一些典型问题,现整理如下供读者参考。
图像识别流程主要包含以下几个关键步骤:
1、收集大量的验证码图片作为训练样本;
2、对图像进行预处理,具体流程包括:灰度化、二值化、字符切割以及最终的识别分类;
3、在图像识别阶段提取特征值,将二值化后的图像数据作为样本进行模型训练,最终基于训练好的模型对新输入的验证码进行识别。
验证码样本获取与预处理流程
一、大量验证码样本的准备
由于目标是实现字母识别,我们需要积累大量的字母验证码数据。此前我曾参与某电商项目的开发,了解到该网站使用纯字母验证码,因此选取该网站作为示例数据来源。
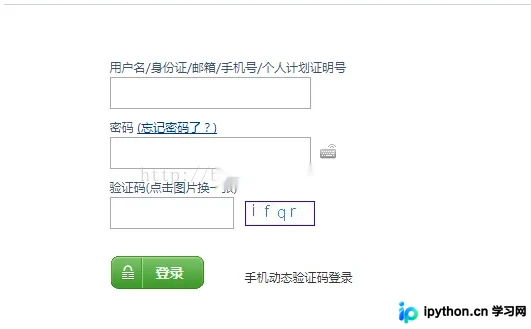
获取验证码的方法相对简单,首先定位到动态生成验证码图片的URL地址。
随后调用Python标准库中的urllib.request模块获取图片数据,并将其保存至本地目录即可。
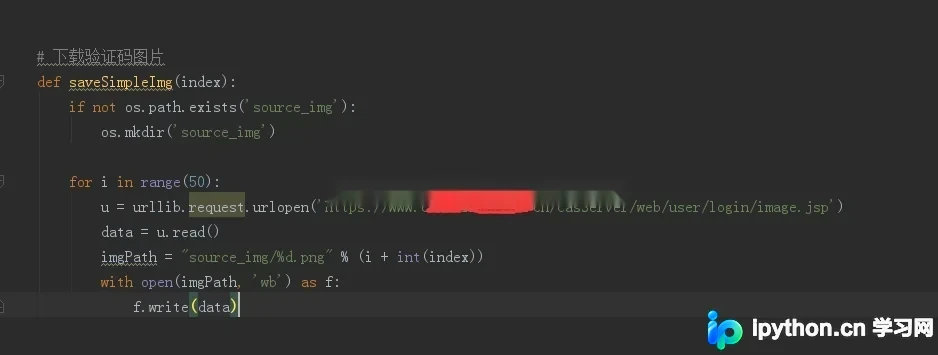
二、图像的灰度化与二值化处理
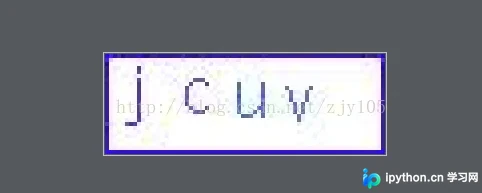
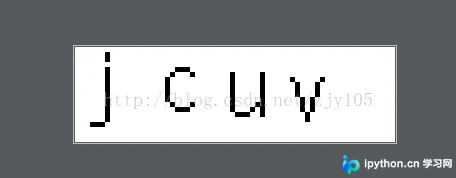
为了提高识别准确率,通常需要将彩色图像转换为灰度图像。
经过处理后,图像呈现黑白两色,其中黑色像素值设为255,白色像素值设为0。这种高对比度的表示方式更利于机器进行后续的特征提取与识别。
以下是灰度化及二值化处理前后的效果对比图。
字符分割与特征提取
三、图像的分割处理
通过观察验证码样本可以发现,目标验证码通常由4个字母组成。
此外,大多数验证码字符之间存在空白间隔(针对后续出现的字符黏连情况,将单独讨论处理方法)。
此处采用垂直投影法,依据像素投影分布情况对图像进行切割。该算法原理较为复杂,具体实现请参考相关代码部分。
处理效果如图所示,最终将原始图像成功分割为4个独立的字符图像。
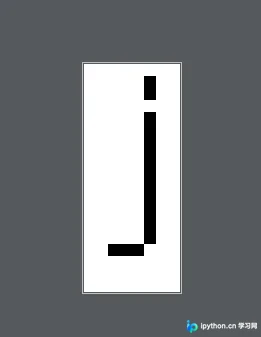
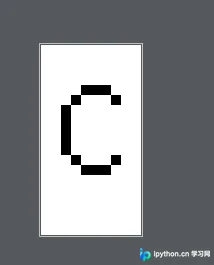
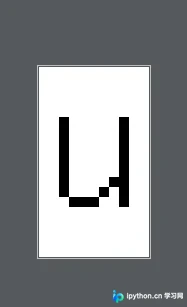
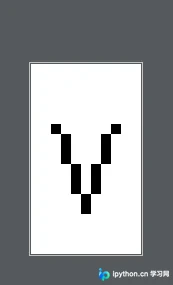
四、识别与分类标注
鉴于图像数据量庞大,若对每张图手动区分26个英文字母将极其繁琐。因此,引入Google的Tesseract OCR软件辅助识别图像中的字母内容。虽然Tesseract的识别率并非完美(否则无需引入人工智能优化),但可大幅减少人工工作量,对于识别错误的样本再进行人工修正分类。
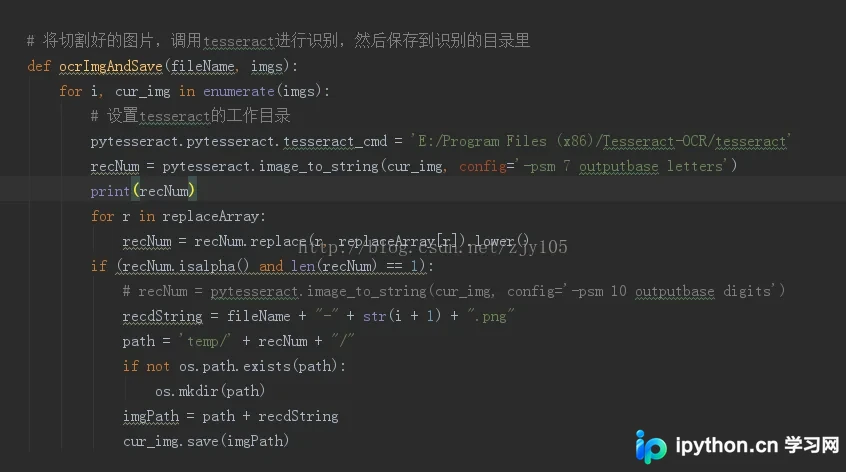
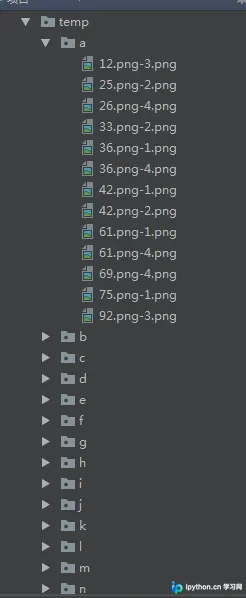
经过OCR自动识别与人工分类校正后,temp目录下形成了结构化的目录,每个子目录内存放对应正确字母的图片样本。
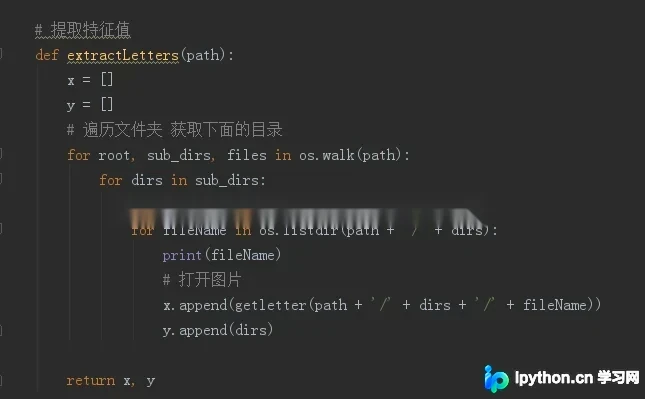
五、特征值提取
遍历存放字母图片的文件夹,提取每个字符的特征值,并将这些特征数据存储至文本文件中,以便后续模型训练使用。
SVM模型训练与验证
六、机器学习模型训练
本方案选用sklearn库中的SVM(支持向量机)算法对提取的特征数据进行分类训练。
关于SVM算法的具体原理,可参考知乎上的相关深度解析文章:https://www.zhihu.com/question/21094489 。
通过调用fit方法完成模型训练后,将训练结果序列化保存至pkl文件中。该文件内部主要存储了用于分类的0和1特征值矩阵。
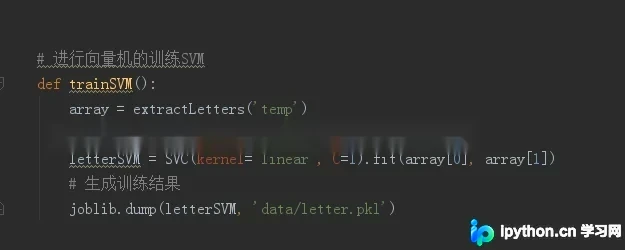
七、最终验证环节
获取一张新的验证码图片,复用前述预处理方法将其转换为二值化数据,随后输入至训练好的SVM模型中进行识别,即可获取最终的识别结果。
黏连字符处理与常见问题解析
八、滴水算法(解决字符黏连问题)
部分验证码并非完全由空格分隔,可能出现字符相互黏连的情况,例如长这样的图像。
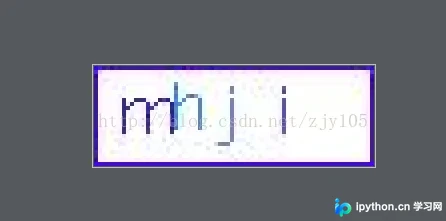
针对此类黏连字符,需采用滴水算法(Water Drop Algorithm)。该算法模拟水滴受重力作用下落的过程,自动寻找最佳切割点以分离黏连的字符图像。
详细的算法实现代码可查阅项目中的water.py文件。
开发过程中遇到的常见问题与解决方案:
1、Python3环境下不再支持旧版OpenCV的cv2.cv方法,该方法仅适用于Python2。需改用Python3兼容的写法即可实现相同功能。
2、原始验证码图片边缘带有蓝色边框,导致初期识别错误。经排查,需在切割前确保仅字母部分保留颜色,其余背景区域处理为白色。
上述逻辑由cutImg方法实现。
3、在使用Google OCR时,若通过Python的pytesseract库调用,需先在操作系统中安装Tesseract-OCR软件,并在代码中明确指定可执行文件路径。
否则程序运行时会报错。pytesseract.pytesseract.tesseract_cmd = 'E:/Program Files (x86)/Tesseract-OCR/tesseract'
4、pytesseract.image_to_string(cur_img, config='-psm 7 outputbase letters')
其中letters是我手动创建的配置文件,存放路径位于E:\Program Files (x86)\Tesseract-OCR\tessdata\configs目录下。该配置文件用于
约束识别的范围,例如设置tessedit_char_whitelist abcdefghijklmnopqrstuvwxyz 表示仅允许识别英文字母。这样设置后
可以避免将数字1和0误识别为字母l和o。
最后附上GitHub源码下载地址:https://github.com/zjy090/verifyCode (提供本地下载链接)。
后续计划研究遗传算法(GA)的实现,待完成Demo后将再次分享给社区。
总结
以上即为本文的全部内容,希望本文的技术细节与实战经验能对各位的学习或工作有所帮助,感谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









