

Python实现两种多分类混淆矩阵

本文详解Python中多分类混淆矩阵的两种实现方式。首先解析TP、FP等核心概念及查准率、F1-Score等评价指标,随后通过sklearn库展示如何直接打印各类别分类准确率,以及如何输出具体分类数值以支持灵活计算。包含完整代码示例与可视化图表,适用于深度学习模型评估。
1、什么是混淆矩阵
在深度学习领域,混淆矩阵不仅是绘制ROC曲线的基础,更是评估分类型模型准确度最基础、直观且计算简便的方法。它能直观展示分类模型在每一类样本中的表现,常作为模型评估的关键环节。通过混淆矩阵,可以轻易判断多个类别之间是否存在混淆现象,即某个类别的样本被错误预测为另一个类别的情况。
理解混淆矩阵前,需明确以下核心概念:
T(True)或F(False):代表样本是否被正确分类。
P(Positive)或N(Negative):代表样本原本的真实类别是正例还是负例。
- 真正例(True Positive,TP):预测正确。模型预测为正例,且样本真实类别也是正例。
- 真负例(True Negative,TN):预测正确。模型预测为负例,且样本真实类别也是负例。
- 伪正例(False Positive,FP):预测错误。模型预测为正例,但样本真实类别为负例。
- 伪负例(False Negative,FN):预测错误。模型预测为负例,但样本真实类别为正例。
将上述四个指标整理成表格,即得到混淆矩阵(Confusion Matrix)。此处引用自其他文章的示意图:
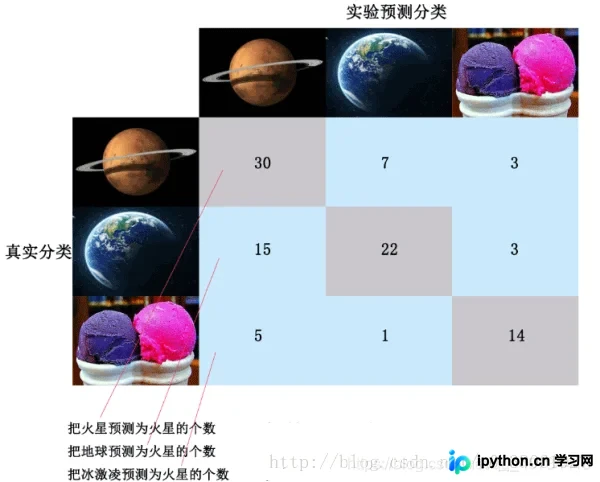
在混淆矩阵中,以主对角线为界。如上图所示,对角线上的元素表示预测正确的样本数,而对角线之外的元素则表示将样本错误预测为其他类别的数量。
2、分类模型评价指标
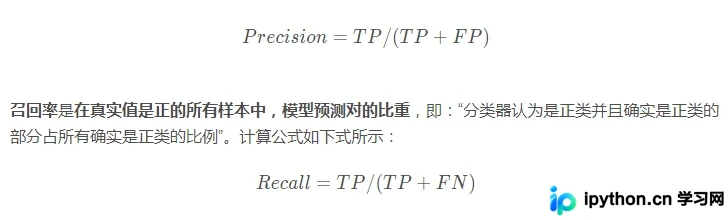
通过混淆矩阵可以直观查看各参数的数值大小。查准率(Precision)是指在模型预测为正例的所有样本中,真正为正例的比例,即“分类器判定为正类且确实为正类的部分占所有分类器判定为正类的比例”。其计算公式如下所示:
F1-Score指标综合了Precision(查准率)与Recall(召回率)的结果。F1-Score的取值范围在0到1之间,1代表模型输出最佳,0代表输出最差。其计算公式如下所示:
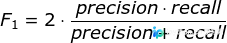
除了F1分数,F2分数和F0.5分数在统计学中也广泛应用。其中,F2分数赋予召回率更高的权重,而F0.5分数则赋予查准率更高的权重。
3、两种多分类混淆矩阵
根据实际需求,多分类混淆矩阵可绘制为不同形式:
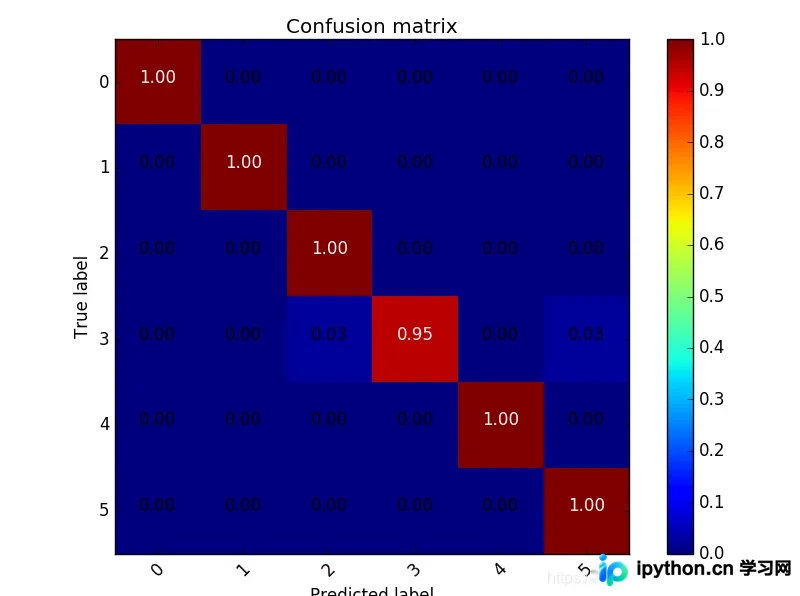
1、直接打印出每一个类别的分类准确率。
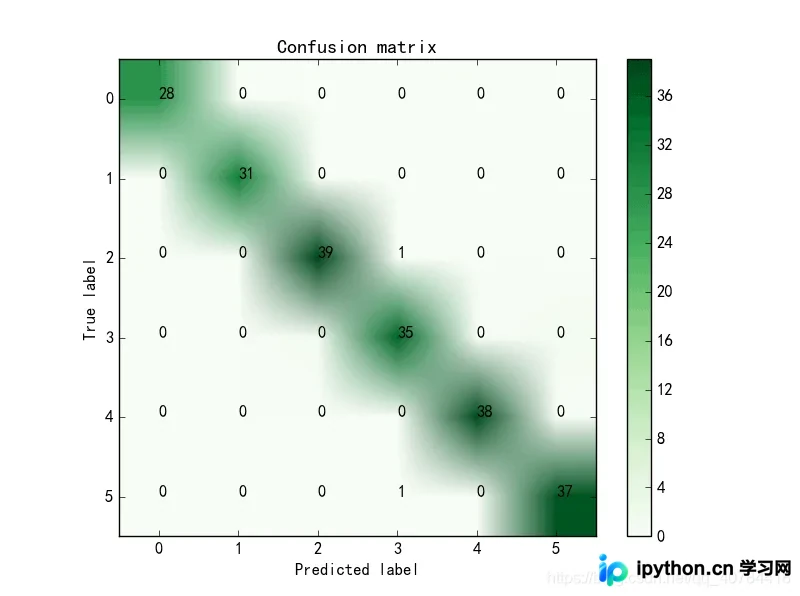
2、打印具体的分类结果数值,便于后续数据分析及各类指标的计算。
在介绍具体代码前,先介绍confusion_matrix()函数。该函数由Python的sklearn库提供,用于输出矩阵数据:
def confusion_matrix(y_true, y_pred, labels=None, sample_weight=None):参数意义如下:
- y_true:样本真实分类结果。
- y_pred:样本预测分类结果。
- labels:指定的类别列表,通过该参数可选择特定类别。
- sample_weight:样本权重。
3.1直接打印出每一个类别的分类准确率。
# 显示混淆矩阵
def plot_confuse(model, x_val, y_val):
   # 获得预测结果
    predictions = predict(model,x_val)
    #获得真实标签
    truelabel = y_val.argmax(axis=-1)   # 将one-hot转化为label
    cm = confusion_matrix(y_true=truelabel, y_pred=predictions)
    plt.figure()
    # 指定分类类别
    classes = range(np.max(truelabel)+1)
    title='Confusion matrix'
   #混淆矩阵颜色风格
    cmap=plt.cm.jet
    cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title)
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45)
    plt.yticks(tick_marks, classes)
    thresh = cm.max() / 2.
   # 按照行和列填写百分比数据
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, '{:.2f}'.format(cm[i, j]), horizontalalignment="center",
                 color="white" if cm[i, j] > thresh else "black")
    plt.tight_layout()
    plt.ylabel('True label')
    plt.xlabel('Predicted label')
    plt.show()
3.2打印具体的分类结果的数值
# 显示混淆矩阵
def plot_confuse_data(model, x_val, y_val):
    classes = range(0,6)
    predictions = predict(model,x_val)
    truelabel = y_val.argmax(axis=-1)   # 将one-hot转化为label
    confusion = confusion_matrix(y_true=truelabel, y_pred=predictions)
    #颜色风格为绿。。。。
    plt.imshow(confusion, cmap=plt.cm.Greens)
# ticks 坐标轴的坐标点
# label 坐标轴标签说明
    indices = range(len(confusion))
# 第一个是迭代对象,表示坐标的显示顺序,第二个参数是坐标轴显示列表
    plt.xticks(indices, classes)
    plt.yticks(indices, classes)
    plt.colorbar()
    plt.xlabel('Predicted label')
    plt.ylabel('True label')
    plt.title('Confusion matrix')

# plt.rcParams两行是用于解决标签不能显示汉字的问题
    plt.rcParams['font.sans-serif']=['SimHei']
    plt.rcParams['axes.unicode_minus'] = False

# 显示数据
    for first_index in range(len(confusion)):    #第几行
        for second_index in range(len(confusion[first_index])):    #第几列
            plt.text(first_index, second_index, confusion[first_index][second_index])
# 显示
    plt.show()
4、总结
1、混淆矩阵是深度学习中最常用的分类模型评估指标。网上多数示例仅显示各类别的分类正确率,灵活性不足。而显示具体数值的混淆矩阵灵活性更高,便于计算用户自定义的指标。
2、在多分类混淆矩阵中,查准率等于主对角线上的值除以该值所在列的和;召回率等于主对角线上的值除以该值所在行的和。
以上就是Python实现两种多分类混淆矩阵的详细内容,更多关于Python多分类混淆矩阵的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









