

Python自动化实现登录获取图片验证码功能
本文介绍如何使用Python的Selenium库定位并截取登录页面的图片验证码,随后调用百度AI高精度文字识别API进行OCR解析。通过获取验证码坐标、截取局部图像及调用SDK,实现自动化登录流程中的验证码自动填充与提交,适用于Web自动化测试场景。
2026-10-13
6

本文介绍如何使用Python的Selenium库定位并截取登录页面的图片验证码,随后调用百度AI高精度文字识别API进行OCR解析。通过获取验证码坐标、截取局部图像及调用SDK,实现自动化登录流程中的验证码自动填充与提交,适用于Web自动化测试场景。
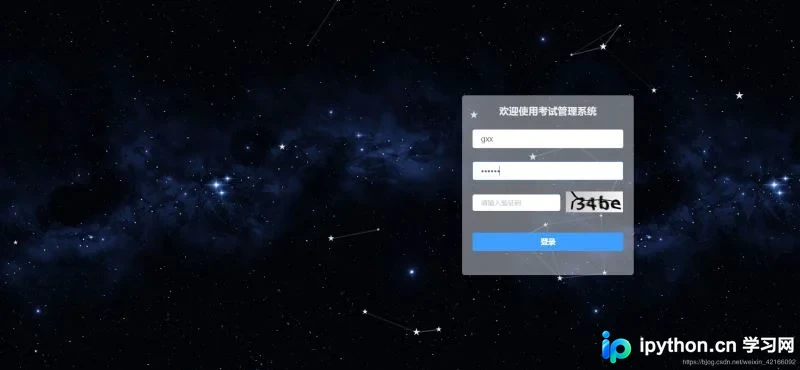
本文详细介绍如何利用Python结合Selenium库破解滑块验证码并实现自动登录。内容涵盖图像处理定位缺口位置、模拟人类滑动轨迹算法以及自动化浏览器操作。通过具体代码示例,展示如何计算位移距离、生成符合行为特征的滑动轨迹,并最终完成登录验证,为Web自动化测试提供实用参考。
本文介绍如何在Python中使用Selenium时彻底关闭ChromeDriver进程,避免残留进程导致系统卡顿。通过Service类管理驱动生命周期,使用quit()而非close(),以及利用os模块调用taskkill命令强制结束进程,提供完整代码示例与注意事项。
本文介绍如何使用Python和Selenium库自动化获取QQ群成员信息。通过模拟浏览器操作,自动登录并滚动加载页面,提取群成员昵称、QQ号等字段,最终导出为Excel文件。适用于拥有群主或管理员权限的场景,代码示例包含环境配置及核心抓取逻辑。
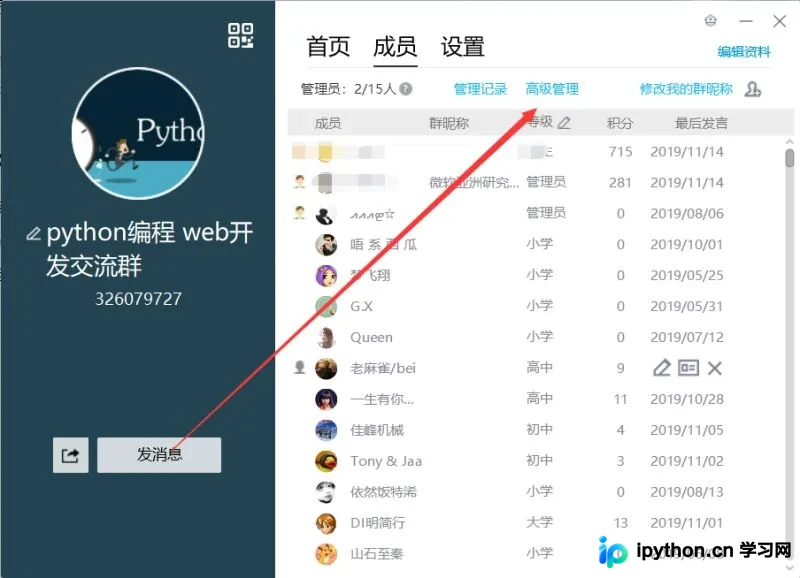
本文详细介绍如何使用Python、Selenium和PIL库实现网页特定元素的长截图功能。通过获取元素尺寸、循环滚动截取、裁剪及拼接图片,解决元素高度超过屏幕可视区域的问题。同时提供短元素截取的优化方案及iframe处理技巧,附带完整可运行代码。
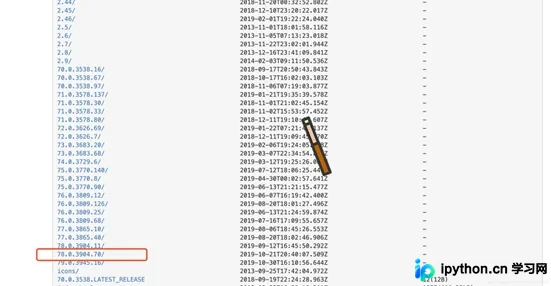
本文详细介绍在Mac系统中使用Python和Selenium进行浏览器自动化的基础配置。涵盖从安装Selenium库、获取与Chrome版本匹配的ChromeDriver驱动,到解压放置及编写简单自动化脚本的完整流程。通过百度首页搜索示例,演示如何控制浏览器、截图及获取页面数据,帮助初学者快速上手Web自动化测试。
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
本文详细解析Python中使用Selenium进行Web自动化测试时,Chrome浏览器无法启动的常见原因及解决方案。内容涵盖Selenium环境检查、ChromeDriver驱动配置、以及解决因旧版浏览器残留文件导致的路径冲突问题,帮助开发者快速定位并修复启动错误。
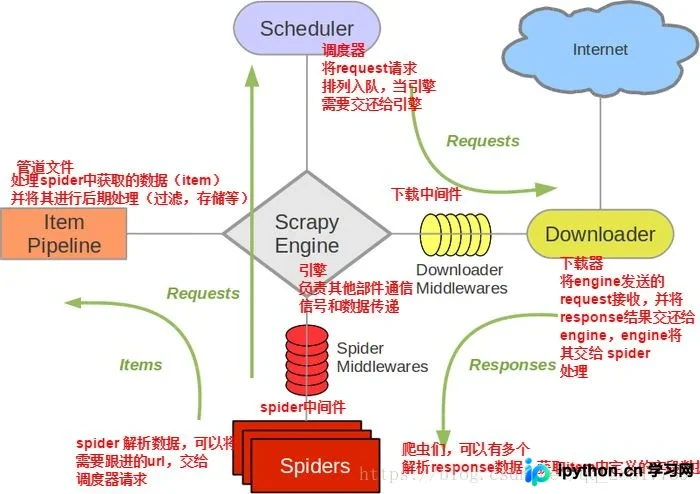
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。
本文介绍在Python2环境下,利用Selenium截取网页元素并结合PIL库进行图像处理的方案。通过提取验证码或特定图片区域,计算其与本地图库中图片的相似度,从而自动匹配最相似的图片。代码涵盖截图、裁剪、灰度处理及相似度算法实现,适用于自动化测试中的图形识别场景。
本文深入解析Pyppeteer作为Selenium替代方案的用法。介绍其基于Python async机制的异步优势,详解launch方法的headless、args等关键参数配置,并通过实例演示如何自动处理Chromium依赖及结合pyquery解析JS渲染页面,实现高效网页数据抓取。