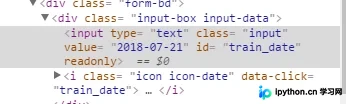
Selenium Python解决时间控件输入问题:移除readonly属性与赋值技巧
本文针对Selenium Python自动化测试中时间控件无法直接输入的问题,分析了存在与不存在readonly属性的两种情况。通过JavaScript移除readonly属性后,结合clear()清空与直接赋值value的方法,解决了input元素不可编辑导致的报错,提供了经过测试的完整封装流程。
2026-10-14
7

本文针对Selenium Python自动化测试中时间控件无法直接输入的问题,分析了存在与不存在readonly属性的两种情况。通过JavaScript移除readonly属性后,结合clear()清空与直接赋值value的方法,解决了input元素不可编辑导致的报错,提供了经过测试的完整封装流程。
本文详解在 Selenium Python 中处理长页面滚动的多种方案。针对元素不可见问题,介绍通过 execute_script 调用 JS 控制滚动条位置、使用 scrollIntoView 定位元素、发送 Tab 键切换焦点以及 Robot Framework 封装方法。涵盖上下及左右滚动场景,提供完整代码示例与注意事项,帮助开发者解决自动化测试中的滚动难题。
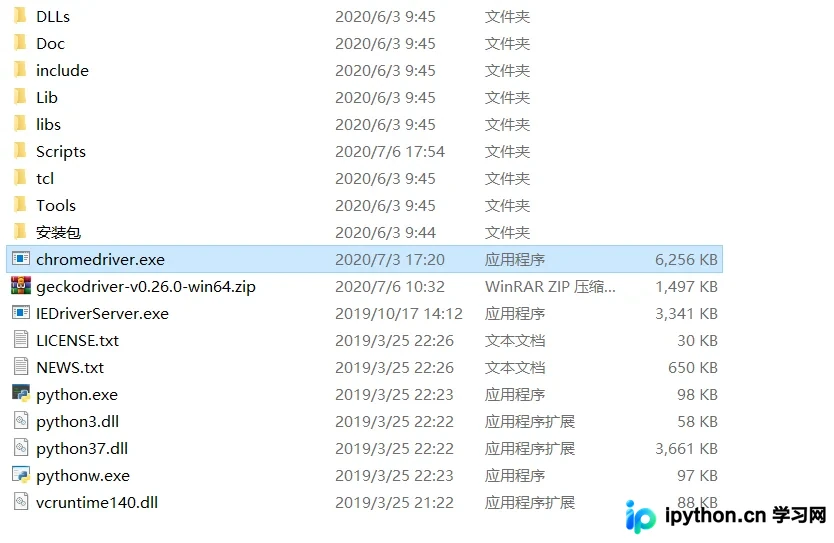
本文详细介绍Python中Selenium模块的安装与环境搭建过程,涵盖pip安装方式及浏览器驱动(Chrome、Firefox等)的配置方法。通过具体代码示例,演示如何启动浏览器、访问网页以及执行元素操作,帮助开发者快速掌握Selenium 2的基础应用。
本文介绍Python中muggle_ocr模块的安装与使用方法,涵盖光学印刷文本与4-6位验证码两种识别模式。结合Selenium与PhantomJS实现网页自动登录,演示如何截取验证码图片并调用第三方接口或本地SDK进行识别,最终完成全自动登录流程。
本文分析使用Python Selenium结合多线程执行定时任务时,因频繁启动浏览器实例导致CPU占用率飙升至90%以上的问题。通过展示基于threading.Timer的简易定时代码,指出其潜在性能瓶颈,并探讨如何优化资源占用以避免系统卡顿,适用于需要长期运行的自动化爬虫场景。
本文介绍Python Selenium中解决页面加载超时导致程序阻塞的问题。通过设置Chrome的pageLoadStrategy为none,使get()方法在HTML加载完成后立即返回,不再等待JS或图片资源。该方法避免了set_page_load_timeout导致的driver失效风险,实现了快速定位元素并继续操作的目标。
本文详解使用PyInstaller打包Selenium Python脚本时遇到的常见坑。针对打包后exe在其他机器闪退的问题,重点排查浏览器驱动与插件版本匹配及文件路径;针对运行出现CMD黑窗口的问题,通过修改service.py源码添加creationflags参数,并结合-F -w命令实现无头后台运行,确保程序稳定且界面简洁。
本文介绍如何利用Python结合Selenium与PyQt5构建账号共享浏览器。通过Selenium模拟登录并维持Cookie状态,利用自定义浏览器加载Cookie实现免登录访问。针对多用户同时使用导致的IP异常和掉线问题,引入代理服务器统一出口IP,有效规避安全限制,实现稳定的账号共享方案。
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
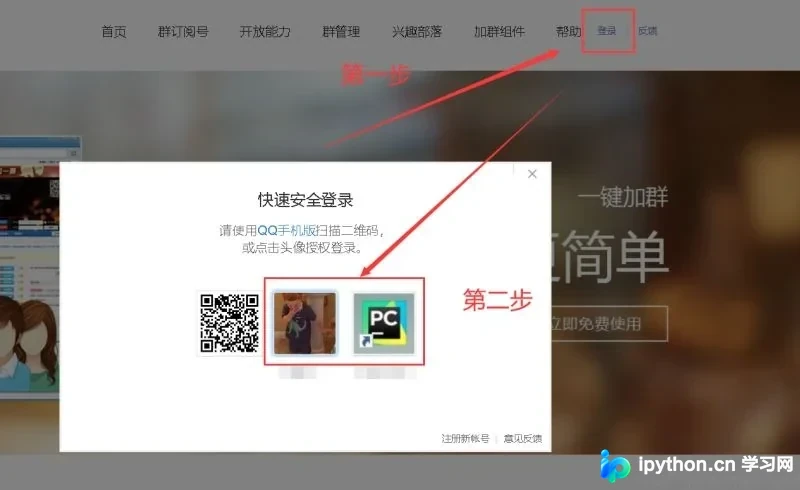
本文介绍使用 Python Selenium 自动化抓取 QQ 群成员信息的完整流程。通过模拟浏览器登录、选择目标群组及动态滚动加载页面,提取群成员列表。代码重点展示了如何清洗数据,去除群主和管理员身份,并仅保存普通成员的 QQ 号至本地文件,适用于需要批量获取群成员联系方式的场景。
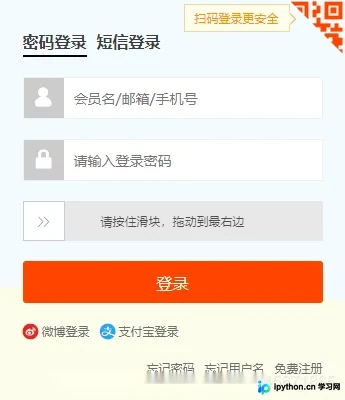
本文介绍使用Python3.7结合Selenium库实现淘宝网站密码登录的完整流程。重点解析如何应对登录时的滑动验证码挑战,通过定位元素、计算滑动距离及模拟轨迹,成功绕过验证机制。文章提供从环境配置到代码实现的详细步骤,帮助开发者掌握自动化登录技巧。
本文介绍使用Python 3.8.1与Selenium 3.141.0实现QQ邮箱登录滑块验证的自动化脚本。通过模拟人类移动轨迹,利用ActionChains控制滑块拖动,解决常见的人机验证问题。文章包含完整代码示例及关键参数说明,适用于同类滑块验证场景的参考与实现。