Python实现B站粉丝数实时监控与获取
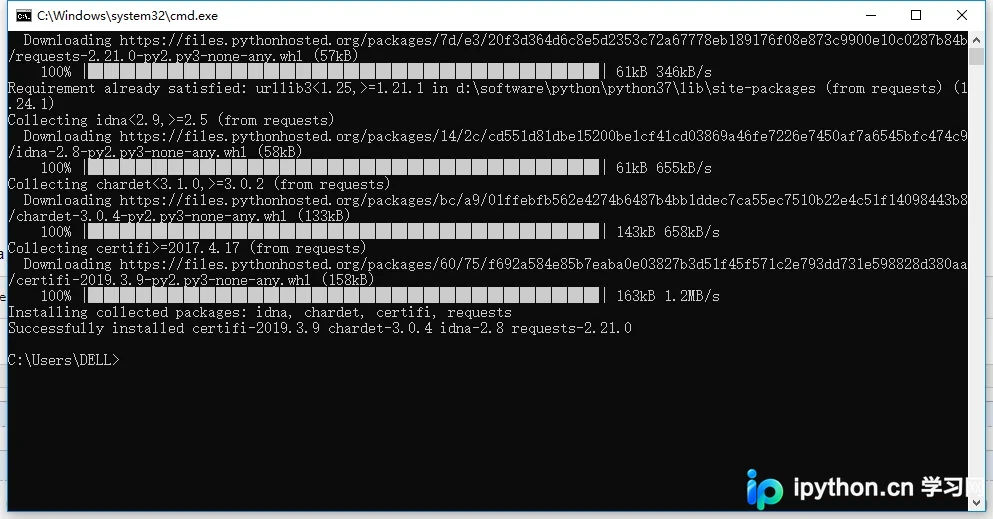
本文介绍如何使用Python通过B站开放API获取用户粉丝数。提供基础查询与带异常处理、定时轮询的监控脚本示例,涵盖requests库安装、UID配置及数据解析步骤,帮助开发者实现粉丝数量变化的自动检测。
2026-10-14
6

本文介绍如何使用Python通过B站开放API获取用户粉丝数。提供基础查询与带异常处理、定时轮询的监控脚本示例,涵盖requests库安装、UID配置及数据解析步骤,帮助开发者实现粉丝数量变化的自动检测。
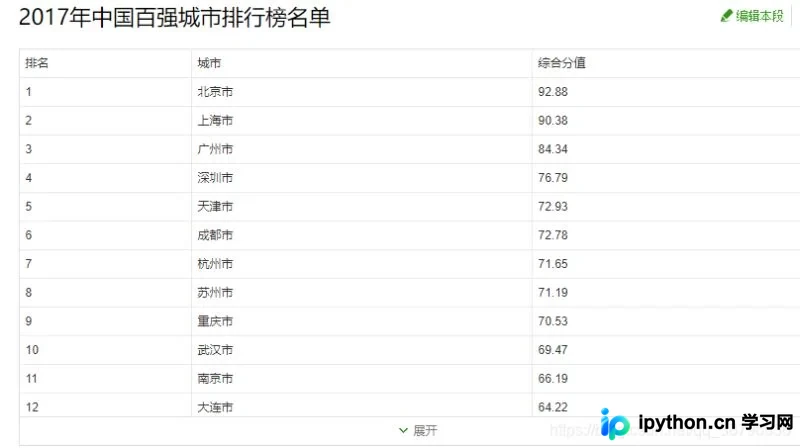
本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详细解析Python爬虫中因缺少User-Agent标识导致请求被拒的问题,并提供使用requests库进行UA伪装的完整代码示例。通过模拟Chrome浏览器头部信息,有效绕过门户网站的简单反爬检测,实现正常数据抓取。
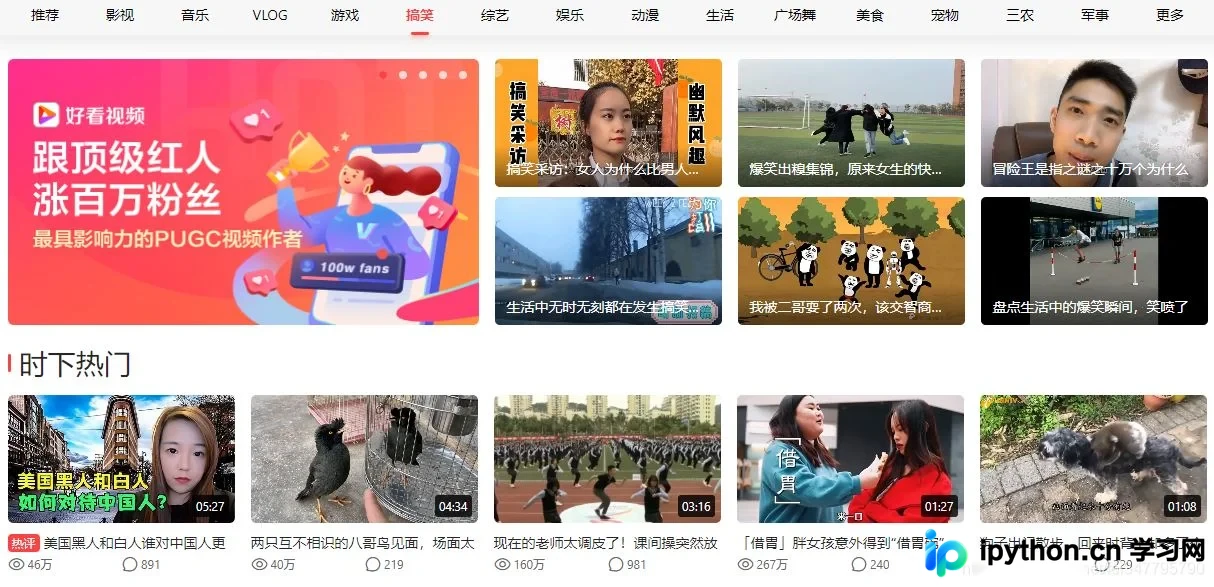
本文介绍使用Python爬取好看视频平台搞笑栏目短视频的方法。针对网站懒加载特性,通过构造API请求获取视频列表,解析标题与播放地址,并利用requests库下载保存视频文件。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文系统讲解Python爬虫核心知识,涵盖Web交互原理、Requests库的get/post/put方法及Response对象属性。提供10个基础代码实例,演示URL传参、Headers伪装绕过反爬、文件保存及编码处理。最后通过完整实例展示如何结合正则表达式从百度贴吧批量下载图片,适合初学者快速掌握爬虫基本操作。

本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
本文介绍Python爬虫在遇到登录验证(如验证码、拖拽)时的两种主流解决方案:Cookie注入与模拟登录。通过获取浏览器Cookie并利用requests库复用会话,可绕过多数验证机制;同时简述基于requests的模拟登录思路。文中包含完整代码示例,展示如何配置代理、设置Cookie及处理登录状态,帮助开发者高效解决登录墙问题。
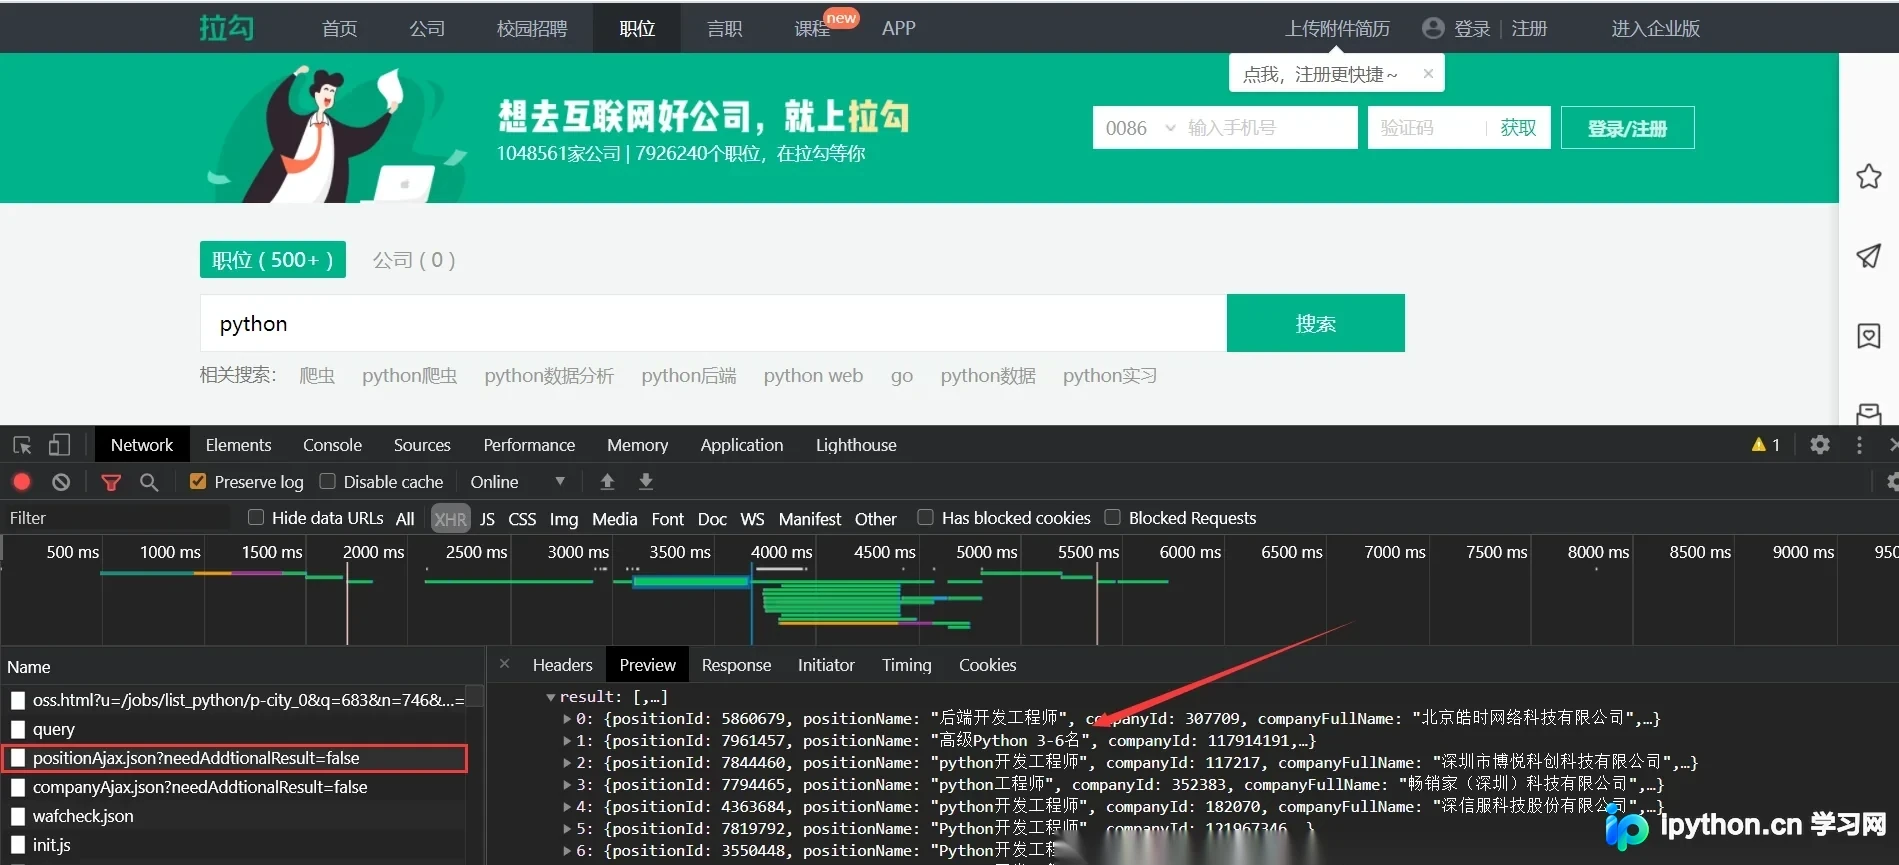
本文详细解析使用Python Requests库爬取拉勾网招聘信息的完整流程。重点解决接口返回操作频繁错误的问题,通过获取并动态刷新Cookies解决反爬限制。代码包含分页请求、字段提取及CSV保存功能,每十次请求自动更新Cookie,确保数据抓取的稳定性与有效性。
本文介绍如何使用Python的Requests库对文件分片上传接口进行自动化测试。通过模拟前端行为,将大文件按指定大小分片,计算整体及分片MD5值,并循环调用后端接口上传各分片。最后通过对比服务器返回的MD5值来验证上传完整性与正确性,适用于Vue前端与PHP后端的系统测试场景。
本文详细介绍Python中Requests库的安装方法及发送GET请求的核心用法。涵盖无参与有参请求、状态码与响应体(text/content)的区别、自动解码机制,以及response对象常用属性如headers、json()和raise_for_status()的实战应用,帮助开发者快速掌握接口测试基础。