

Python正则表达式非贪婪与多行匹配详解
本文详解Python中正则表达式的非贪婪匹配机制及多行处理技巧。通过对比贪婪与非贪婪模式的匹配结果,解析当存在前后限定条件时非贪婪标志的失效情况。同时深入讲解re.S与re.M标志对点号及行首尾锚点的影响,帮助开发者精准控制正则匹配行为。
2026-10-13
6

本文详解Python中正则表达式的非贪婪匹配机制及多行处理技巧。通过对比贪婪与非贪婪模式的匹配结果,解析当存在前后限定条件时非贪婪标志的失效情况。同时深入讲解re.S与re.M标志对点号及行首尾锚点的影响,帮助开发者精准控制正则匹配行为。
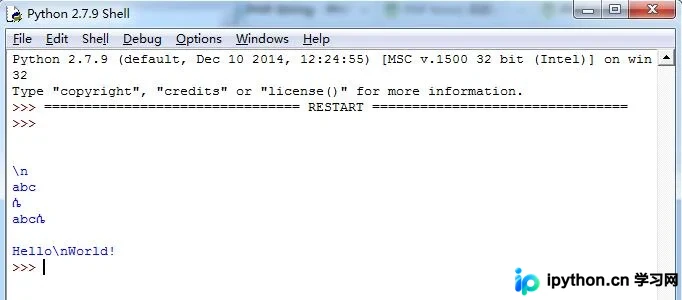
本文深入解析Python中原始字符串(r/R)与Unicode字符串(u/U)操作符的具体用法。通过代码实例演示了原始字符串在避免转义字符干扰及处理文件路径时的优势,以及Unicode操作符对标准字符串和原始Unicode字符串的转换机制。文章提供了相关在线编码转换工具链接,并附带完整可运行代码,帮助开发者掌握字符串处理技巧。
本文详细介绍如何使用Python编写简单的爬虫程序来批量下载网页图片。通过定义getHtml函数抓取页面源码,利用正则表达式筛选.jpg格式链接,并结合urllib.urlretrieve方法实现本地保存。文章还补充了urlopen与Request对象的使用差异,以及文件写入的两种常见写法,帮助初学者快速掌握图片抓取的核心技巧。
本文介绍使用Python编写简单图片爬虫的方法,通过urllib获取网页HTML源码,利用正则表达式匹配jpg图片链接,并实现批量下载保存。代码示例针对特定贴吧页面,适合初学者学习基础爬虫逻辑与文件操作。
本文介绍使用 Python3 通过搜狗微信搜索接口抓取文章标题与链接的方法。利用 urllib 构建请求,通过正则表达式解析 HTML 获取数据,并借助 xlsxwriter 模块将结果写入 Excel 文件。文中包含完整代码示例及 URL 构造逻辑说明,适用于 Python3.4 及 Windows 环境,需注意网站结构变更可能导致脚本失效。
本文介绍如何使用Python的subprocess模块调用系统Ping命令,并结合正则表达式解析返回的中文文本,提取接收包数量、最小、最大及平均延迟时间。代码示例展示了完整的解析逻辑,用于判断网络连通性及性能指标,适用于Windows环境下的网络诊断场景。
本文介绍如何使用Python模拟SQL语句对员工信息表执行增删改查操作。通过正则表达式和字符串分割技术解析SQL命令,支持模糊查询、条件过滤及多字段更新。代码精简利用函数封装,实现基于phone唯一键的插入、按id删除及多条件修改,并统计查询结果条数,适合初学者理解数据处理逻辑。
本文通过实际代码对比了Python中5种字符串过滤方法的性能。涉及循环、正则表达式、函数式filter、列表生成式及string.translate()。测试生成10万条随机字符串,统计各方法执行时间,旨在为开发者提供高效处理字符串的参考方案。
本文介绍在Python中实现字符串单词反转并保留原始空格的两种经典方案。第一种方法通过遍历字符串,定位单词边界并逐个反转,最后整体反转字符串;第二种方法利用re模块的正则表达式分割功能,直接实现反转。文章提供了完整的代码示例,帮助开发者掌握字符串处理技巧。
本文详解Python中正则表达式模块re的search方法。重点解析group()与groups()函数的用法差异:group()默认返回完整匹配字符串,支持指定分组索引;groups()以元组形式返回所有括号分组内容。通过具体示例帮助开发者准确掌握正则匹配结果的提取技巧。
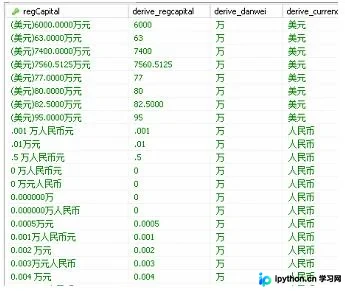
本文详解如何利用Python处理数据库中杂乱的非结构化文本数据。针对包含币种、金额及“万”字等混合信息的字符串,通过Python内置函数与逻辑判断,实现数字提取、单位统一(归一化为“万”)及币种标准化。文章提供从环境配置、逻辑拆解到全量代码实现的完整流程,并探讨基于时间戳的增量数据处理方案,适用于需要高灵活性的ETL场景。
本文介绍在Python中获取命令行执行结果并过滤所需信息的方法。以Windows系统为例,通过os.popen执行ipconfig命令,结合正则表达式精准提取本机物理地址(MAC)和IP地址,并展示完整代码与运行结果,供Python开发者参考。